
Knowledge Mining: Fundamentos da IA

Knowledge mining, ou mineração de conhecimento em português, é o segmento da IA dedicado a extrair informações de grandes volumes de dados, normalmente desestruturados, para criar um armazenamento de conhecimento pesquisável. Em vez de deixar contratos, PDFs, imagens e e-mails esquecidos em pastas, a técnica transforma esse acervo em algo que pessoas e aplicações conseguem consultar.
Neste artigo, você vai entender como o conceito funciona, quais tecnologias de IA ele combina e como o Azure AI Search implementa esse processo. Ao final, também verá um exemplo de consulta em C# e os cenários em que a abordagem faz mais sentido.
Fundamentos da Inteligência Artificial
Esta publicação faz parte de uma série de artigos sobre os Fundamentos da Inteligência Artificial. Confira abaixo a série completa.
- Parte 1: O que é Inteligência Artificial
- Parte 2: Machine Learning
- Parte 3: Computer Vision
- Parte 4: Natural Language Processing
- Parte 5: Document Intelligence
- Parte 6: Knowledge Mining (você está aqui)
- Parte 7: Generative AI
A série segue a mesma linha dos conteúdos da certificação Azure AI Fundamentals. Por isso, cada parte apresenta uma capacidade da IA e o serviço do Azure que a implementa.
O que é knowledge mining
Knowledge mining é a capacidade de extrair grande volume de informação de documentos que, em geral, não têm estrutura definida. O resultado dessa extração alimenta um armazenamento de conhecimento que aceita buscas.
Pense em uma empresa com milhares de contratos digitalizados. O texto existe, mas está preso em imagens e PDFs, então nenhuma busca comum consegue encontrar uma cláusula específica.
A mineração de conhecimento resolve esse problema em três movimentos. Primeiro, ela lê o conteúdo bruto, depois aplica IA para entender o que há ali e, por fim, organiza o resultado em um índice.
Em outras palavras, o knowledge mining transforma dados escuros, aqueles que a empresa guarda mas não usa, em informação acessível. Esse é o principal valor da técnica.
Dados estruturados e desestruturados
Dados estruturados seguem um esquema fixo, como as linhas e colunas de uma tabela. Um banco relacional sabe exatamente onde está o nome do cliente e o valor do pedido.
Por outro lado, dados desestruturados não seguem um formato previsível. Textos livres, imagens, áudios, apresentações e documentos escaneados entram nessa categoria.
Boa parte do conhecimento de uma organização vive nesse segundo grupo. Por isso, sem uma etapa de extração inteligente, esse conhecimento fica praticamente invisível para os sistemas de busca.
Como funciona o knowledge mining
O processo de knowledge mining combina várias capacidades de IA que aparecem nos artigos anteriores da série. Cada uma contribui com um tipo de extração.
A visão computacional reconhece texto impresso ou manuscrito em imagens por meio de OCR. Além disso, ela descreve o conteúdo visual de fotos e diagramas.
O processamento de linguagem natural identifica idiomas, pessoas, lugares, organizações e frases-chave. Também detecta sentimento e dados pessoais em textos longos.
A inteligência documental entende o layout de formulários, tabelas e documentos complexos. Assim, ela preserva a relação entre os campos e seus valores.
Juntas, essas etapas criam uma camada de significado sobre o conteúdo original. O resultado final é um índice que responde a perguntas que o documento bruto não responderia.
Knowledge mining no Microsoft Azure
Uma das soluções para knowledge mining no Microsoft Azure é o Azure AI Search, uma solução corporativa de busca em documentos com ferramentas próprias para indexação. O serviço já se chamou Azure Cognitive Search e é totalmente gerenciado na nuvem.
Essa indexação pode atender apenas o público interno da empresa ou ficar disponível publicamente na internet. Dessa forma, o mesmo serviço sustenta tanto uma intranet quanto um portal aberto.
O Azure AI Search usa recursos nativos dos serviços de IA do Azure para processamento de imagem, inteligência documental e NLP na extração de dados. Segundo a documentação oficial de AI enrichment, esse enriquecimento cria conteúdo pesquisável e estrutura onde antes não havia nenhuma.
Esse recurso permite indexar documentos que antes ninguém conseguia pesquisar. Além disso, extrai informação de um grande volume de dados rapidamente.
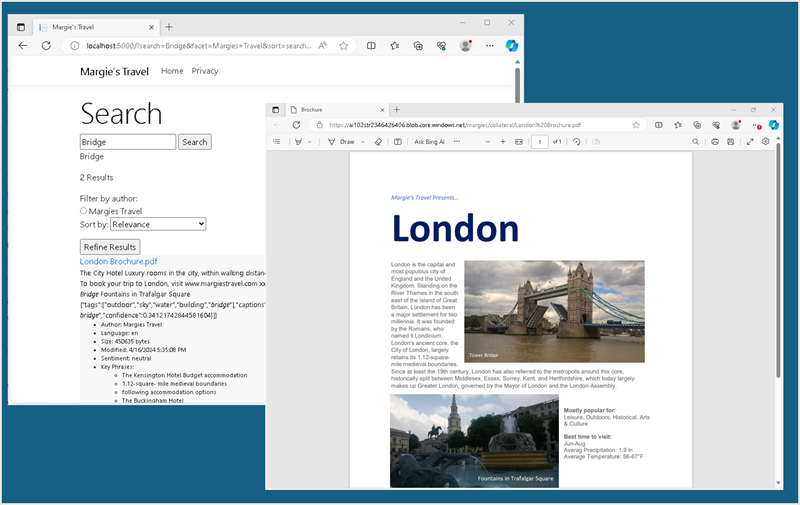
Neste exemplo, um site de viagens usa o Azure AI Search para melhorar a pesquisa sobre destinos. A busca considera informações extraídas tanto de imagens quanto de textos.
Os componentes do Azure AI Search
Para entender o knowledge mining no Azure, vale conhecer as peças que formam o pipeline. São quatro objetos principais.
Fonte de dados
A fonte de dados indica onde o conteúdo original está guardado. Entre as opções suportadas estão o Azure Blob Storage, o Azure Cosmos DB, o SharePoint e o OneLake.
Indexador
O indexador conduz todo o processo. Ele busca os documentos na fonte, extrai texto e imagens, executa o enriquecimento e carrega o resultado no índice.
Para fontes com controle de alterações, o indexador processa apenas documentos novos ou modificados. Assim, as execuções seguintes ficam mais rápidas e baratas.
Skillset
O skillset reúne as habilidades de IA aplicadas a cada documento. Na prática, é aqui que o knowledge mining acontece de verdade.
Você pode combinar skills prontas da Microsoft com skills customizadas. Uma skill customizada chama um código seu por meio de uma interface web, o que permite plugar modelos próprios de classificação.
Índice de busca
O índice é a estrutura que recebe o conteúdo enriquecido e responde às consultas. Ele aceita busca full text, vetorial, híbrida e multimodal.
Além do índice, o indexador pode gravar o resultado em um knowledge store. Veremos esse recurso mais adiante.
O fluxo de um projeto de knowledge mining
A documentação do Azure AI Search descreve um fluxo típico para montar o pipeline de enriquecimento. Ele segue uma ordem lógica de criação dos objetos.
- Primeiro, crie a fonte de dados com a conexão para o local onde os documentos estão.
- Em seguida, defina o skillset com as habilidades de IA e, se quiser, a definição do knowledge store.
- Depois, monte o esquema do índice com os campos que vão receber o conteúdo enriquecido.
- Então, crie e execute o indexador, que junta todas as peças e carrega o índice.
- Por fim, execute consultas para avaliar o resultado ou abra uma sessão de depuração.
No indexador, você também configura os mapeamentos de campos. Eles definem qual saída do enriquecimento vai para qual campo do índice.
Quando precisar repetir o processo, reinicie o indexador antes de executá-lo novamente. Outra opção, recomendada no plano gratuito, é apagar e recriar os objetos a cada rodada.
Esse ciclo curto de ajuste e validação é o coração de qualquer projeto de knowledge mining. Afinal, dificilmente o primeiro skillset entrega exatamente os campos que o negócio precisa.
Skills nativas para knowledge mining
O Azure AI Search oferece um conjunto de skills nativas que cobrem os cenários mais comuns de knowledge mining. A tabela abaixo resume as principais:
| Skill | O que faz |
|---|---|
| OCR | Reconhece texto impresso e manuscrito em imagens e arquivos binários |
| Image Analysis | Descreve o conteúdo de uma imagem e gera texto pesquisável |
| Language Detection | Detecta o idioma predominante do texto |
| Entity Recognition | Extrai pessoas, lugares, organizações, datas e outras entidades |
| Key Phrase Extraction | Identifica as frases mais importantes do conteúdo |
| Sentiment | Avalia se o texto tem tom positivo, negativo ou neutro |
| PII Detection | Localiza e pode mascarar dados pessoais |
| Text Translation | Traduz o conteúdo para permitir buscas multilíngues |
Essas skills chamam serviços de IA do Azure por baixo dos panos. Por isso, a maior parte delas gera cobrança separada, e a documentação recomenda anexar um recurso faturável ao skillset em projetos maiores.
Vale lembrar também que os erros se acumulam. Por exemplo, uma falha no OCR passa adiante para a extração de frases-chave.
Knowledge store
O knowledge store é um armazenamento secundário para o conteúdo enriquecido pelo skillset. Fisicamente, ele fica no Azure Storage, em tabelas, blobs ou ambos.
Enquanto o índice serve para consultas de busca, o knowledge store atende outros cenários. Ferramentas como o Power BI, pipelines de ciência de dados e aplicações próprias podem ler esse conteúdo diretamente.
Com a skill Shaper, você define o formato dos dados projetados. Assim, o mesmo pipeline de knowledge mining entrega tabelas para relatórios e objetos complexos para análise.
Um detalhe importante: o indexador cria e atualiza as projeções, mas não as apaga. Portanto, cabe ao dono da conta de armazenamento remover o que deixou de ser útil.
Consultando o resultado do knowledge mining com C#
Depois que o indexador popula o índice, qualquer aplicação pode consultá-lo. Em .NET, o pacote Azure.Search.Documents oferece o SearchClient para essa tarefa.
O exemplo abaixo consulta o índice de exemplo de hotéis, alinhado ao cenário do site de viagens:
using Azure;
using Azure.Search.Documents;
using Azure.Search.Documents.Models;

// Configuração do cliente de busca
string serviceName = "<your-search-service-name>";
string indexName = "hotels-sample";
string apiKey = "<your-query-api-key>";

var endpoint = new Uri($"https://{serviceName}.search.windows.net");
var credential = new AzureKeyCredential(apiKey);
var searchClient = new SearchClient(endpoint, indexName, credential);

// Consulta full text nos campos de nome e descrição
var options = new SearchOptions
{
    SearchMode = SearchMode.All,
    IncludeTotalCount = true,
    Size = 10
};
options.SearchFields.Add("HotelName");
options.SearchFields.Add("Description");
options.Select.Add("HotelName");
options.Select.Add("Description");

SearchResults<SearchDocument> response =
    await searchClient.SearchAsync<SearchDocument>("NY +view", options);

Console.WriteLine($"Total documents matching query: {response.TotalCount}");
await foreach (SearchResult<SearchDocument> result in response.GetResultsAsync())
{
    Console.WriteLine($"Hotel: {result.Document["HotelName"]}");
}
Repare que a aplicação não sabe nada sobre OCR ou entidades. Ela apenas consulta o índice, porque todo o trabalho pesado aconteceu durante a indexação.
Em produção, prefira autenticação com Microsoft Entra ID por meio do DefaultAzureCredential. Dessa forma, você evita espalhar chaves de API pelo código.
Knowledge mining e IA generativa
Com a chegada dos LLMs, o knowledge mining ganhou um novo papel. O índice enriquecido passou a servir de base para soluções de RAG, em que o modelo consulta documentos antes de responder.
Se quiser entender essa técnica, o artigo sobre o que é RAG (Retrieval-Augmented Generation) explica o funcionamento em detalhes. A ligação com a mineração de conhecimento é direta.
Hoje, o Azure AI Search também oferece fatiamento de texto e vetorização integrados ao pipeline. Além disso, a documentação apresenta o agentic retrieval, em que um LLM planeja a consulta e combina várias fontes de conhecimento.
Ou seja, a mesma base criada pela mineração de conhecimento atende tanto a busca clássica quanto agentes de IA. Esse é um bom motivo para investir no enriquecimento desde cedo.
Casos de uso de knowledge mining
O primeiro caso de uso clássico é o jurídico. Escritórios e departamentos legais indexam contratos para encontrar cláusulas, partes envolvidas e prazos em segundos.
Outro exemplo é o atendimento ao cliente. Bases de conhecimento, manuais e históricos de chamados viram uma fonte única para agentes humanos e chatbots.
Na área de pesquisa, o knowledge mining ajuda a navegar por artigos científicos e relatórios técnicos. As entidades extraídas permitem filtrar por autor, instituição ou tema.
Por fim, o setor de viagens, como no exemplo da imagem, combina fotos e descrições para sugerir destinos. Nesse caso, a análise de imagem gera texto que a busca consegue usar.
Boas práticas para começar
Comece com um subconjunto pequeno e representativo dos documentos. A própria documentação lembra que o desenho do indexador e do skillset é iterativo.
Em seguida, use as sessões de depuração do portal para validar cada skill. Assim, você encontra problemas antes de processar o acervo inteiro.
Se o skillset usa OCR ou análise de imagem, considere o cache de enriquecimento. Ele reaproveita resultados e reduz o custo das reexecuções.
Também avalie se você realmente precisa de vetores. Segundo a Microsoft, nem todo cenário exige busca vetorial, e o índice full text já resolve muitos casos.
Conclusão
Knowledge mining é a capacidade da IA dedicada à mineração de documentos, ou seja, à extração de grandes volumes de informação de conteúdos normalmente desestruturados. Essa busca resulta em um armazenamento de conhecimento pesquisável.
O Azure AI Search é a ferramenta do Azure para essa tarefa. Ele combina processamento de imagens, inteligência documental e NLP para extrair dados e alimentar índices e knowledge stores.
Com isso, documentos esquecidos passam a responder perguntas reais do negócio. E, com a IA generativa, esse mesmo conhecimento ainda alimenta assistentes e agentes.
Para continuar a série, volte para a Parte 5: Document Intelligence ou avance para a Parte 7: Generative AI.
FAQ
Knowledge mining é a mesma coisa que data mining?
Não. Data mining busca padrões em dados geralmente estruturados, enquanto knowledge mining extrai informação de conteúdos desestruturados e a torna pesquisável.
Qual serviço do Azure faz knowledge mining?
O principal é o Azure AI Search, que usa indexadores e skillsets para enriquecer documentos com serviços de IA do Azure.
Preciso programar para usar o Azure AI Search?
Não necessariamente. O portal do Azure permite criar fontes de dados, skillsets, índices e indexadores, enquanto os SDKs e a API REST servem para automação.
O que é um skillset?
É o conjunto de habilidades de IA, como OCR e extração de entidades, que o indexador aplica a cada documento durante a indexação.
Para que serve o knowledge store?
Ele guarda o conteúdo enriquecido no Azure Storage para usos fora da busca, como relatórios no Power BI e análises de ciência de dados.