
Document Intelligence: Fundamentos da IA

Document Intelligence é o segmento da inteligência artificial que lida com a gestão, o processamento e o uso de grandes volumes de dados presentes em formulários e documentos. Em português, chamamos de inteligência documental, e ela permite criar sistemas que automatizam o processamento de contratos, notas fiscais, formulários e muito mais.
Fundamentos da inteligência artificial
Esta publicação faz parte de uma série de artigos sobre os fundamentos da inteligência artificial. Confira abaixo a série completa.
- Parte 1: O que é Inteligência Artificial
- Parte 2: Machine Learning
- Parte 3: Computer Vision
- Parte 4: Natural Language Processing
- Parte 5: Document Intelligence (este artigo)
- Parte 6: Knowledge Mining
- Parte 7: Generative AI
O que é Document Intelligence
Empresas guardam uma quantidade enorme de informação em documentos. Notas fiscais, recibos, contratos, fichas cadastrais e formulários escaneados carregam dados valiosos, mas presos em papel ou em PDF.
Document Intelligence é a área da IA que transforma esses documentos em dados estruturados. Em vez de alguém digitar campo por campo, um modelo lê o documento, entende sua estrutura e devolve os valores prontos para uso.
Na prática, isso significa receber um JSON com o nome do fornecedor, a data, os itens e o total de uma nota fiscal. Além disso, cada valor vem acompanhado de um índice de confiança e da posição exata em que aparece na página.
Por isso, a inteligência documental se tornou peça central em processos de automação. Ela reduz trabalho manual, diminui erros de digitação e acelera fluxos que antes levavam dias.
Por que documentos são um desafio para a IA
À primeira vista, extrair texto de uma imagem parece um problema resolvido. Afinal, o OCR existe há décadas e já converte pixels em caracteres com boa precisão.
No entanto, ler o texto é só o começo. Um documento tem tabelas, campos rotulados, caixas de seleção, assinaturas e textos manuscritos espalhados pela página.
Além disso, o mesmo tipo de documento muda de layout entre fornecedores. Uma nota fiscal de uma empresa raramente se parece com a nota de outra.
Dessa forma, o desafio real é entender o significado de cada trecho. O sistema precisa saber que aquele número no canto inferior é o total, e não o número do pedido.
É exatamente aqui que o Document Intelligence se diferencia do OCR tradicional. Ele combina reconhecimento de texto, análise de layout e modelos de machine learning treinados para entender o contexto.
Como funciona a extração de dados
O processo costuma seguir algumas etapas bem definidas. Primeiro, o serviço recebe o documento como imagem, PDF ou arquivo do Office.
Em seguida, ele aplica OCR para identificar palavras, linhas e idiomas, inclusive em textos escritos à mão. Depois, analisa o layout para encontrar parágrafos, títulos, tabelas e marcas de seleção.
Na etapa seguinte, um modelo especializado interpreta esse conteúdo. Ele identifica pares de chave e valor e associa cada informação ao campo correto.
Por fim, o serviço devolve um resultado estruturado e fortemente tipado. Um campo de data chega como data e um valor monetário chega como moeda, com símbolo e quantia separados.
Esse fluxo conversa com outros temas da série. A leitura da imagem vem de Computer Vision, enquanto a interpretação do texto se apoia em técnicas de processamento de linguagem natural.
Document Intelligence no Microsoft Azure
No Azure, podemos usar o Azure AI Document Intelligence para criar soluções que gerenciam e aceleram a coleta de dados de documentos escaneados. O serviço se chamava Form Recognizer e ganhou o nome atual em 2023.
O Azure AI Document Intelligence ajuda a automatizar o processamento de documentos em aplicações e workflows. Com isso, ele fortalece estratégias orientadas a dados e melhora a capacidade de busca em grandes acervos.
Você pode usar modelos prontos para adicionar inteligência ao processamento de documentos, notas e formulários. Porém, também é possível criar modelos customizados com seus próprios datasets rotulados.
Esses recursos ficam disponíveis no Azure Document Intelligence Studio e em várias linguagens de programação. Atualmente, a Microsoft agrupa o serviço nas Foundry Tools, a família de serviços de IA do Azure.
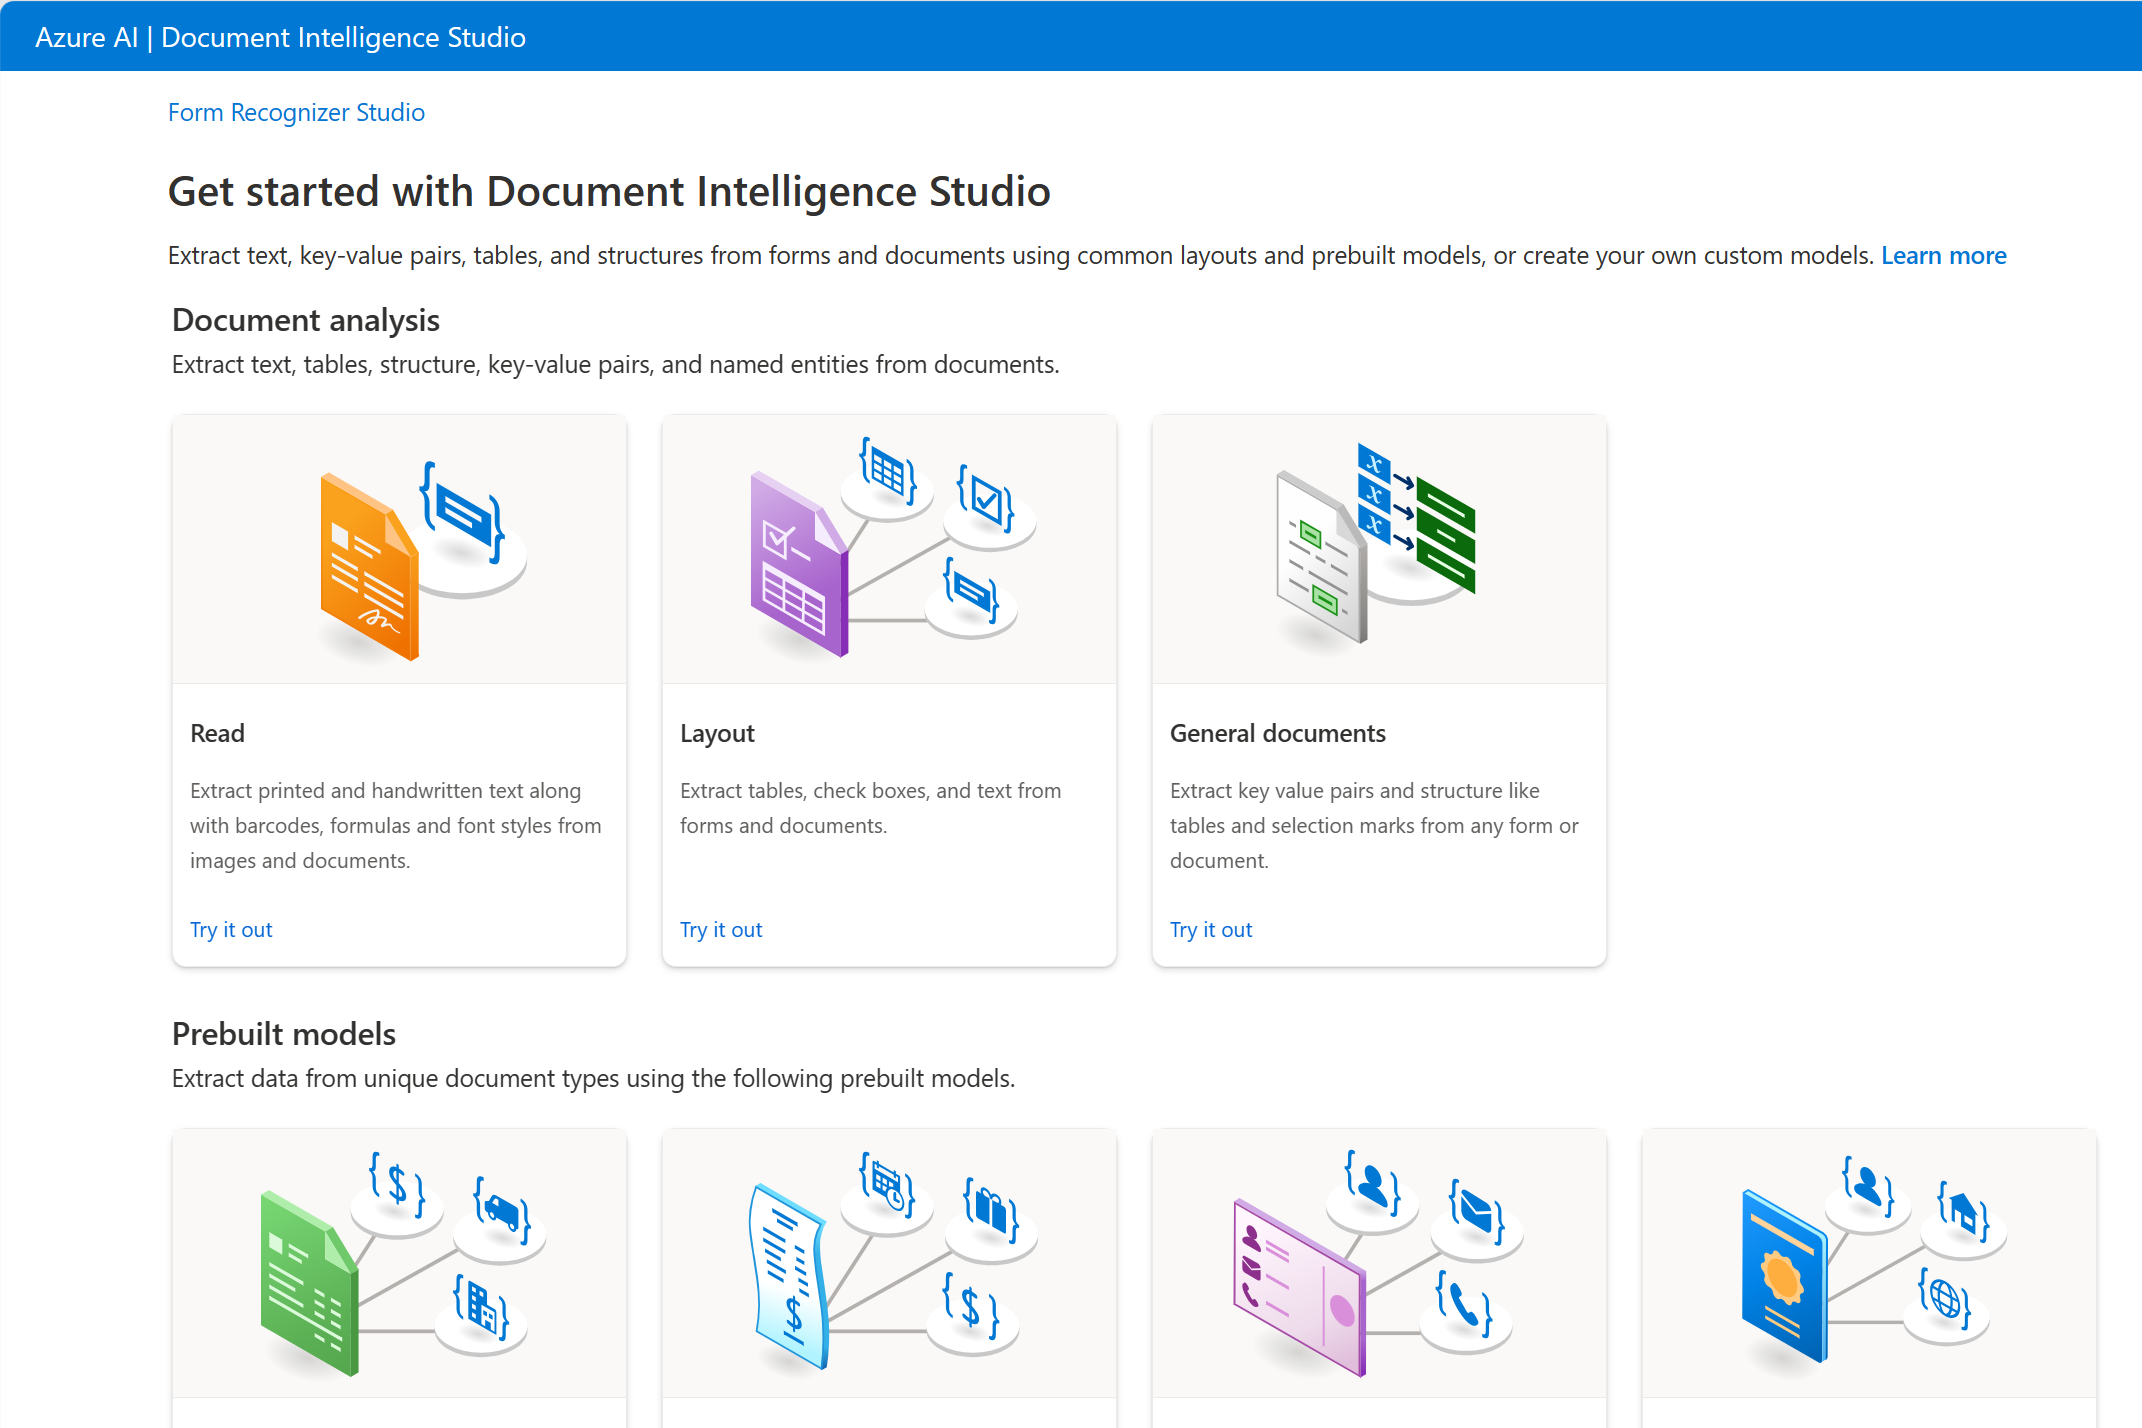
Modelos do Azure AI Document Intelligence
O serviço organiza seus recursos em três grupos de modelos. Cada grupo atende um nível diferente de especialização, do texto cru até campos específicos do seu negócio.
Modelos de análise: Read e Layout
O modelo prebuilt-read extrai texto impresso e manuscrito, linhas, palavras e idiomas detectados. Ele serve para digitalizar qualquer documento, por exemplo em cenários de auditoria e conformidade.
Já o modelo prebuilt-layout vai além do texto. Ele também extrai tabelas, marcas de seleção, parágrafos e a estrutura do documento, o que ajuda a indexar conteúdo e preparar dados para outras aplicações.
Modelos pré-construídos
Os modelos pré-construídos do Document Intelligence já vêm treinados pela Microsoft para tipos comuns de documentos. Assim, você adiciona inteligência ao fluxo sem treinar nada.
Entre os principais, estão os modelos de nota fiscal, recibo, documento de identidade, cartão de visita, contrato e extrato bancário. Também existem modelos para cheques, holerites, cartões de crédito e diversos formulários fiscais dos Estados Unidos.
Nesses modelos, a Microsoft define e mantém o esquema de campos. Por exemplo, o modelo de nota fiscal devolve InvoiceDate como data e SubTotal como valor monetário, sem nenhuma configuração extra.
Modelos customizados
Quando o seu documento é único, entram os modelos customizados do Document Intelligence. Você rotula um conjunto de exemplos com os valores que quer extrair e treina o modelo com esse dataset.
O modelo customizado de template funciona bem para layouts fixos, como formulários sempre iguais. Por outro lado, o modelo customizado neural lida melhor com documentos de estrutura variada.
Além disso, você pode combinar vários modelos em um modelo composto. Também é possível treinar um classificador customizado, que identifica o tipo do documento antes de chamar o extrator certo.
Segundo a documentação, cinco exemplos de um mesmo tipo de documento já bastam para começar um modelo de extração customizado.
Recursos complementares
O Document Intelligence oferece ainda capacidades opcionais que você liga conforme a necessidade. Entre elas, estão a extração em alta resolução, fórmulas, propriedades de fonte e códigos de barras.
Também há recursos para gerar PDFs pesquisáveis e para consultar campos específicos com queryFields. Dessa forma, você ajusta a análise ao cenário sem trocar de modelo.
Document Intelligence Studio na prática
O Document Intelligence Studio é uma ferramenta online para explorar os modelos de forma visual e sem código. Ele é o melhor ponto de partida para validar um cenário antes de escrever qualquer linha.
Para usá-lo, você precisa de uma assinatura do Azure e de um recurso de Document Intelligence criado no portal. Para testes, o plano gratuito F0 atende bem, e você pode migrar para um plano pago depois.
Com o recurso criado, abra a página Keys and Endpoint no portal e copie a chave e o endpoint. Em seguida, configure esses valores no Studio.
A partir daí, escolha um modelo, envie um documento de exemplo ou um arquivo seu e analise o resultado. O painel lateral mostra os campos extraídos, as tabelas e o JSON completo da resposta.
Para modelos customizados, o Studio também oferece uma interface de rotulagem. Você conecta uma conta de armazenamento, marca os campos nos documentos, treina o modelo e testa o resultado no mesmo lugar.
Inclusive, o Studio consegue rotular documentos automaticamente usando um modelo pré-construído ou um modelo que você já treinou. Isso economiza bastante tempo na preparação do dataset.
Usando o Document Intelligence com C#
Depois de validar o cenário no Studio, o próximo passo é integrar o serviço à sua aplicação. A Microsoft oferece bibliotecas para C#, Java, JavaScript e Python, além da API REST.
No .NET, instale o pacote Azure.AI.DocumentIntelligence com o comando abaixo.
dotnet add package Azure.AI.DocumentIntelligence
Em seguida, crie o cliente com o endpoint e a chave do recurso. Neste exemplo, os valores vêm de variáveis de ambiente, o que evita deixar segredos no código.
using Azure;
using Azure.AI.DocumentIntelligence;

// lê o endpoint e a chave das variáveis de ambiente
string endpoint = Environment.GetEnvironmentVariable("DI_ENDPOINT")!;
string key = Environment.GetEnvironmentVariable("DI_KEY")!;

var client = new DocumentIntelligenceClient(
    new Uri(endpoint),
    new AzureKeyCredential(key));

// nota fiscal de exemplo publicada pela Microsoft
var invoiceUri = new Uri("https://raw.githubusercontent.com/Azure-Samples/cognitive-services-REST-api-samples/master/curl/form-recognizer/sample-invoice.pdf");

// analisa o documento com o modelo pré-construído de nota fiscal
Operation<AnalyzeResult> operation = await client.AnalyzeDocumentAsync(
    WaitUntil.Completed,
    "prebuilt-invoice",
    invoiceUri);

AnalyzeResult result = operation.Value;

foreach (AnalyzedDocument document in result.Documents)
{
    if (document.Fields.TryGetValue("VendorName", out DocumentField? vendorName)
        && vendorName.FieldType == DocumentFieldType.String)
    {
        Console.WriteLine($"Vendor: {vendorName.ValueString} (confidence {vendorName.Confidence})");
    }

    if (document.Fields.TryGetValue("InvoiceTotal", out DocumentField? invoiceTotal)
        && invoiceTotal.FieldType == DocumentFieldType.Currency)
    {
        CurrencyValue total = invoiceTotal.ValueCurrency;
        Console.WriteLine($"Total: {total.CurrencySymbol}{total.Amount} (confidence {invoiceTotal.Confidence})");
    }
}
O método AnalyzeDocumentAsync recebe o identificador do modelo e a origem do documento. Com WaitUntil.Completed, o código aguarda o fim da análise antes de seguir.
O resultado traz a coleção Documents, e cada documento expõe um dicionário Fields. Então, basta verificar o tipo do campo e ler o valor tipado, como ValueString ou ValueCurrency.
Repare também na propriedade Confidence. Ela indica o quanto o modelo confia no valor extraído, o que permite enviar casos duvidosos para revisão humana.
Para usar outro modelo, troque apenas o identificador. Por exemplo, prebuilt-receipt analisa recibos, prebuilt-layout extrai tabelas e um modelo customizado usa o ID que você definiu no treino.
Requisitos dos documentos de entrada
Antes de enviar arquivos para o Document Intelligence, vale conhecer os requisitos de entrada da v4.0. Todos os modelos aceitam PDF e imagens nos formatos JPEG, PNG, BMP, TIFF e HEIF.
Além disso, os modelos Read e Layout também leem arquivos do Office, como DOCX, XLSX e PPTX, e páginas HTML. Os modelos pré-construídos e os extratores customizados, por outro lado, trabalham apenas com PDF e imagens.
Quanto ao tamanho, o plano pago aceita arquivos de até 500 MB, enquanto o plano gratuito limita cada arquivo a 4 MB. No plano gratuito, o serviço também processa apenas as duas primeiras páginas de cada documento.
As imagens precisam ter entre 50 por 50 e 10.000 por 10.000 pixels. Já os PDFs protegidos por senha precisam ser desbloqueados antes do envio.
Para melhores resultados, a documentação recomenda uma foto nítida ou um escaneamento de boa qualidade por documento. Afinal, a qualidade da entrada influencia diretamente a confiança dos valores extraídos.
Casos de uso de Document Intelligence
O cenário mais comum é o contas a pagar. O sistema recebe notas fiscais por e-mail, extrai fornecedor, valores e vencimentos e alimenta o ERP automaticamente.
Outro uso frequente é o controle de despesas. Nesse caso, o colaborador fotografa o recibo e o aplicativo preenche o reembolso sozinho.
Também há ganhos claros no cadastro de clientes. Bancos e seguradoras usam o modelo de identidade para ler documentos pessoais e agilizar a abertura de contas.
Na área jurídica, o modelo de contratos extrai partes, datas e cláusulas. Assim, a equipe localiza informações em milhares de contratos sem abrir arquivo por arquivo.
Por fim, a inteligência documental alimenta soluções de busca. Combinada com Knowledge Mining, ela transforma acervos inteiros em conteúdo pesquisável.
Versões da API e boas práticas
A versão atual da API é a v4.0, lançada como GA em novembro de 2024. As versões v3.1, v3.0 e v2.1 seguem disponíveis, mas a v3.0 e a v2.1 já têm datas de aposentadoria anunciadas.
Portanto, novos projetos devem começar direto na v4.0. Se você mantém uma aplicação antiga, vale planejar a migração com antecedência.
Quanto à segurança, prefira a autenticação com Microsoft Entra ID em produção. Assim, você evita distribuir chaves e controla o acesso com permissões mínimas.
Também vale tratar o índice de confiança como parte do fluxo. Defina um limite mínimo e mande para revisão manual tudo que ficar abaixo dele.
Se quiser conhecer outros serviços de IA da plataforma, veja nosso artigo sobre os recursos de inteligência artificial do Microsoft Azure.
Conclusão
Document Intelligence, ou inteligência documental, é o segmento da IA que cuida da gestão, do processamento e do uso de grandes volumes de dados presentes em documentos escaneados.
O Azure AI Document Intelligence Studio permite testar esses recursos, automatizar processos e workflows e melhorar a busca em documentos. Além dos modelos padrão, podemos treinar nossos próprios modelos rotulados dentro do Studio.
Com o SDK do .NET, levar essa capacidade para a sua aplicação exige poucas linhas de código. No próximo artigo da série, veremos como o Knowledge Mining amplia essa ideia para grandes volumes de conteúdo.
FAQ
Qual a diferença entre OCR e Document Intelligence?
O OCR apenas converte imagem em texto. O Document Intelligence também entende a estrutura e devolve campos, tabelas e valores já interpretados.
O Azure AI Document Intelligence é o antigo Form Recognizer?
Sim, o serviço Form Recognizer mudou de nome para Azure AI Document Intelligence em 2023. As funcionalidades continuam e evoluíram nas versões seguintes da API.
Preciso treinar um modelo para começar?
Não, os modelos pré-construídos já atendem notas fiscais, recibos, documentos de identidade e outros tipos comuns. O treino só é necessário para documentos específicos do seu negócio.
Quantos documentos preciso para treinar um modelo customizado?
A documentação indica que cinco exemplos do mesmo tipo de documento bastam para começar. Mais exemplos variados tendem a melhorar a qualidade.
Existe plano gratuito?
Sim, o plano F0 permite testar o serviço sem custo, com limites de uso. Para produção, você migra para um plano pago.