
Computer Vision: Fundamentos da IA

Computer vision, ou visão computacional em português, é a capacidade que a inteligência artificial tem de interpretar o mundo visualmente, por meio de câmeras, imagens e vídeos. Neste artigo, vamos explorar os principais modelos e capacidades dessa área e ver como colocá-los em prática no Microsoft Azure.
Fundamentos da inteligência artificial
Esta publicação faz parte de uma série de artigos sobre os fundamentos da inteligência artificial. Por isso, vale conferir a série completa na ordem abaixo.
- Parte 1: O que é Inteligência Artificial
- Parte 2: Machine Learning
- Parte 3: Computer Vision (você está aqui)
- Parte 4: Natural Language Processing
- Parte 5: Document Intelligence
- Parte 6: Knowledge Mining
- Parte 7: Generative AI
Se você ainda não leu a parte sobre aprendizado de máquina, comece por ela. Afinal, quase tudo o que veremos aqui depende de modelos treinados com dados.
O que é computer vision
Computer vision é o segmento da IA que lida com percepção visual. Em outras palavras, ela permite que um software olhe para uma imagem e extraia dela algum significado útil.
Para um ser humano, reconhecer um carro em uma foto é trivial. Para um computador, porém, a foto é apenas uma grande tabela de números, e transformar esses números em conceitos exige modelos bem treinados.
A maioria das soluções de computer vision é baseada em modelos de Machine Learning (aprendizado de máquina). Esses modelos podem ser aplicados sobre câmeras ao vivo, imagens estáticas e vídeos.
Vale lembrar que um vídeo nada mais é do que uma sequência de imagens. Assim, praticamente toda técnica que funciona em uma imagem também pode ser aplicada quadro a quadro em um vídeo.
Como uma imagem vira dados
Antes de falar dos modelos, precisamos entender como o computador enxerga uma imagem. Na prática, toda imagem digital é uma matriz de pixels, e cada pixel guarda valores numéricos.
Em uma imagem em escala de cinza, cada pixel tem um único valor, normalmente de 0 (preto) a 255 (branco). Já em uma imagem colorida, cada pixel tem três valores, um para cada canal: vermelho, verde e azul.
Durante muito tempo, a visão computacional dependia de filtros aplicados manualmente a essas matrizes. Esses filtros destacavam bordas, contornos e texturas, mas exigiam que alguém definisse cada regra.
Com o avanço do deep learning, as redes neurais convolucionais passaram a aprender esses filtros sozinhas a partir de exemplos. Dessa forma, o modelo descobre quais padrões visuais importam para cada tarefa.
Mais recentemente, surgiram modelos de base treinados com enormes volumes de imagens e textos. O Florence, da Microsoft, é um exemplo desse tipo de modelo e alimenta parte dos recursos de análise de imagem do Azure.
Modelos e capacidades da computer vision
A computer vision tem várias capacidades, e cada uma resolve um tipo diferente de problema. A seguir, vamos usar um exemplo recorrente para comparar todas elas: uma solução de monitoramento de tráfego.
Image classification
Image classification, ou classificação de imagem, envolve treinar um modelo de Machine Learning para classificar imagens com base no seu conteúdo. O modelo olha para a imagem inteira e responde qual é o assunto principal dela.
Por exemplo, em uma solução de monitoramento de tráfego, você pode usar um modelo de classificação para separar imagens pelo tipo de veículo que elas contêm. Assim, cada foto recebe um rótulo como táxi, ônibus ou carro.
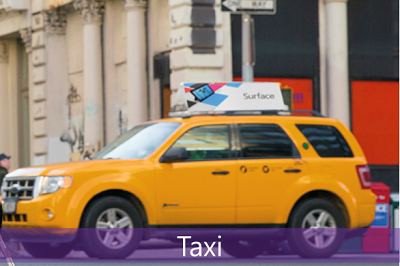
A classificação funciona melhor quando cada imagem tem um assunto dominante. Quando há vários objetos relevantes na mesma cena, outras técnicas costumam ser mais adequadas.
Object detection
Object detection, ou detecção de objetos, envolve treinar um modelo para classificar objetos individuais em uma imagem e identificar a localização de cada um. Essa localização vem na forma de uma caixa delimitadora, chamada de bounding box.
Por exemplo, em uma solução de monitoramento de tráfego, a detecção de objetos identifica onde estão os carros, os ônibus e as bicicletas na mesma cena. Com isso, o sistema consegue contar veículos ou medir a distância entre eles.
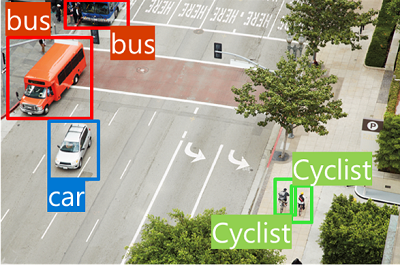
A documentação do Azure lembra algumas limitações dessa técnica. Objetos muito pequenos, com menos de 5% da imagem, ou muito próximos uns dos outros, como uma pilha de pratos, costumam passar despercebidos.
Semantic segmentation
Semantic segmentation, ou segmentação semântica, é uma técnica avançada de Machine Learning em que cada pixel da imagem é classificado de acordo com o objeto a que pertence. Portanto, o resultado não é uma caixa, mas uma máscara com o contorno exato de cada objeto.
Em uma solução de monitoramento de tráfego, por exemplo, teríamos uma camada sobre o vídeo, com uma máscara destacando os diferentes veículos em cores distintas.
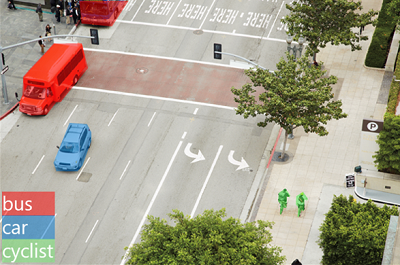
Essa precisão é útil em cenários como veículos autônomos e imagens médicas. Em contrapartida, rotular dados para segmentação dá muito mais trabalho, já que alguém precisa desenhar o contorno de cada objeto.
Image analysis
Image analysis, ou análise de imagem, é uma solução que combina modelos de Machine Learning com técnicas avançadas de análise de imagem. Em vez de responder uma única pergunta, ela extrai várias informações de uma vez.
Essa análise consegue gerar tags que ajudam a catalogar a imagem ou descrições que resumem a cena mostrada. Por exemplo, uma foto pode receber a legenda "um homem andando com um cachorro na rua", além de tags como "pessoa", "cachorro" e "ao ar livre".
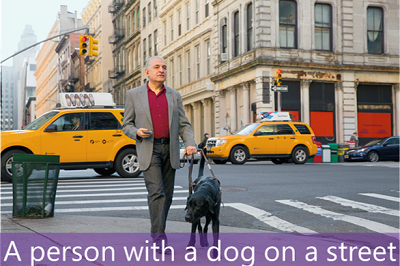
Esse tipo de recurso ajuda bastante em acessibilidade, já que permite gerar textos alternativos para imagens. Além disso, facilita a busca em grandes acervos de fotos.
Face detection
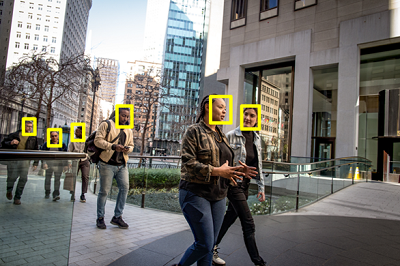
Face detection, ou detecção facial, é uma forma especializada de detecção de objetos capaz de encontrar rostos humanos em imagens e vídeos. O resultado básico é a posição de cada rosto na imagem.
Ela pode ser combinada com técnicas de classificação e de geometria facial para reconhecer indivíduos com base em suas características. Nesse caso, falamos de reconhecimento facial, que é uma etapa além da simples detecção.
OCR
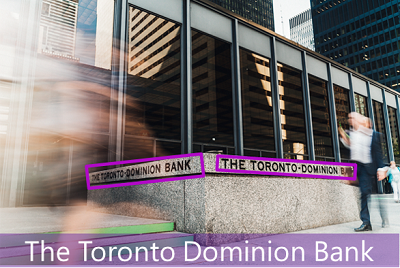
OCR (Optical Character Recognition), ou reconhecimento ótico de caracteres, é uma técnica usada para detectar e ler textos em imagens. Ou seja, ela converte pixels que formam letras em texto que o computador consegue processar.
Podemos usar o OCR para ler textos em fotografias, como placas e estampas de camisetas, ou para extrair informações de documentos escaneados. No Azure, o OCR reconhece tanto texto impresso quanto manuscrito.
Para documentos com estrutura complexa, como notas fiscais e formulários, o caminho costuma ser o Document Intelligence. Esse tema aparece na parte 5 da série.
Como escolher a capacidade de computer vision certa
Com tantas opções, a escolha depende da pergunta que você quer responder. Assim, uma boa forma de decidir é observar o tipo de resposta que cada técnica entrega.
| Pergunta | Capacidade | Resposta típica |
|---|---|---|
| O que esta imagem mostra? | Image classification | Um rótulo para a imagem inteira |
| Onde estão os objetos? | Object detection | Classe e bounding box de cada objeto |
| Quais pixels pertencem a cada objeto? | Semantic segmentation | Uma máscara por classe |
| Como descrever a cena? | Image analysis | Tags e legendas |
| Onde estão os rostos? | Face detection | Coordenadas de cada rosto |
| Qual texto aparece aqui? | OCR | Linhas e palavras com posição |
Na prática, muitas soluções de computer vision combinam mais de uma capacidade. Um sistema de estacionamento, por exemplo, pode detectar o carro e depois aplicar OCR sobre a placa.
Onde a computer vision aparece no dia a dia
Embora pareça um tema distante, a computer vision já está presente em muitos produtos que usamos todos os dias. O desbloqueio do celular pelo rosto, por exemplo, depende de detecção e verificação facial.
Aplicativos de banco que leem boletos e documentos pela câmera usam OCR. Da mesma forma, galerias de fotos que agrupam imagens por pessoas, animais ou lugares usam classificação e análise de imagem.
No varejo, câmeras acompanham prateleiras para identificar produtos em falta. Já na indústria, modelos de detecção apontam defeitos em peças antes que elas saiam da linha de produção.
Na área da saúde, a segmentação ajuda a destacar regiões de interesse em exames de imagem. Ainda assim, o modelo apoia o profissional e não substitui a avaliação humana.
Em todos esses casos, a lógica se repete: capturar a imagem, extrair informações com um modelo e transformar o resultado em uma ação. Por isso, entender as capacidades básicas ajuda a enxergar oportunidades nos seus próprios projetos.
Computer vision no Azure
O serviço do Azure usado para criar soluções de computer vision é o Azure AI Vision. Ele oferece modelos pré-treinados que você consome por API, sem precisar treinar nada do zero.
Além dele, o ecossistema inclui serviços complementares. O Custom Vision permite treinar classificadores e detectores com as suas próprias imagens, enquanto o Video Indexer extrai informações de vídeos.
Azure AI Vision e Image Analysis 4.0
A versão 4.0 da Image Analysis reúne vários recursos em uma única operação de análise. Segundo a documentação oficial, ela oferece leitura de texto, legendas, legendas densas, tags, detecção de objetos, detecção de pessoas e recorte inteligente.
As legendas densas descrevem até 10 regiões da imagem, cada uma com a sua bounding box. Por outro lado, a versão 3.2 ainda oferece recursos que não chegaram à 4.0, como detecção de marcas, de pontos turísticos e de esquema de cores.
Por isso, a recomendação da Microsoft é usar a 4.0 sempre que ela atender ao seu caso. Quando não atender, a 3.2 continua disponível.
Testando no Vision Studio
Para experimentar os recursos sem escrever código, você pode usar o Vision Studio. Basta entrar com a sua conta do Azure e escolher ou criar um recurso de Vision.
Depois disso, o portal oferece demonstrações de OCR, análise de imagem e detecção facial. Dessa forma, você envia suas próprias imagens e vê o JSON retornado por cada recurso.
Usando computer vision com C#
Também é possível consumir os recursos por código, em linguagens como C# e Python. No .NET, o pacote Azure.AI.Vision.ImageAnalysis traz o cliente da Image Analysis 4.0.
using Azure;
using Azure.AI.Vision.ImageAnalysis;

// Endpoint e chave do recurso de Vision, lidos de variáveis de ambiente
var endpoint = Environment.GetEnvironmentVariable("VISION_ENDPOINT")!;
var key = Environment.GetEnvironmentVariable("VISION_KEY")!;

var client = new ImageAnalysisClient(new Uri(endpoint), new AzureKeyCredential(key));

// Pede a legenda da imagem e o texto encontrado nela (OCR)
ImageAnalysisResult result = client.Analyze(
    new Uri("https://aka.ms/azsdk/image-analysis/sample.jpg"),
    VisualFeatures.Caption | VisualFeatures.Read,
    new ImageAnalysisOptions { GenderNeutralCaption = true });

Console.WriteLine($"Caption: {result.Caption.Text} ({result.Caption.Confidence:F4})");

// Percorre os blocos e linhas de texto detectados
foreach (DetectedTextBlock block in result.Read.Blocks)
    foreach (DetectedTextLine line in block.Lines)
        Console.WriteLine($"Line: {line.Text}");
Nesse exemplo, o enum VisualFeatures define quais análises a chamada executa. Assim, você paga e espera apenas pelos recursos que realmente usa.
O retorno ImageAnalysisResult traz a legenda com a sua confiança e, em Read, os blocos, linhas e palavras encontrados. Cada linha também vem acompanhada do polígono que indica onde ela está na imagem.
Uso responsável da computer vision
Algumas capacidades de computer vision lidam com dados sensíveis, especialmente quando envolvem rostos. Por esse motivo, a Microsoft limita o acesso a parte dos recursos de reconhecimento facial.
A detecção de rostos está disponível sem cadastro. Já a identificação e a verificação facial exigem registro e aprovação, conforme a política de acesso limitado do serviço Face.
A Microsoft também aposentou recursos de propósito geral que tentavam inferir emoção e gênero a partir do rosto. Além disso, restringiu atributos como idade, sorriso, pelos faciais e maquiagem, porque esses usos podem levar a estereótipos e discriminação.
Portanto, ao projetar uma solução de computer vision, avalie a privacidade dos dados, a necessidade de consentimento e a legislação aplicável. Uma boa leitura complementar é a visão geral dos recursos de IA do Azure.
Conclusão
Computer vision, ou visão computacional, é o segmento da IA que lida com detecção e classificação de objetos em imagens, câmeras e vídeos. Ela transforma pixels em informações que um sistema consegue usar para tomar decisões.
A área tem diferentes segmentos e técnicas, que vão de classificações mais básicas até segmentação pixel a pixel, análise de cenas, detecção facial e OCR. Por isso, entender a pergunta que você quer responder é o primeiro passo para escolher a técnica certa.
No Azure, o Azure AI Vision concentra esses recursos de computer vision e pode ser usado tanto por código quanto pelo Vision Studio. Na próxima parte da série, vamos falar de processamento de linguagem natural.
FAQ
Qual a diferença entre computer vision e visão computacional?
Nenhuma, são o mesmo conceito. Computer vision é o termo em inglês e visão computacional é a tradução em português.
Qual a diferença entre classificação de imagem e detecção de objetos?
A classificação atribui um rótulo à imagem inteira. Já a detecção identifica cada objeto e devolve a posição dele em uma bounding box.
Preciso treinar um modelo para usar o Azure AI Vision?
Não para os recursos prontos, como legendas, tags, objetos e OCR. Para categorias específicas do seu negócio, você pode treinar um modelo próprio com o Custom Vision.
O reconhecimento facial do Azure está disponível para qualquer conta?
A detecção de rostos está disponível sem registro. Identificação e verificação facial exigem cadastro e aprovação da Microsoft.
Dá para testar computer vision sem programar?
Sim. O Vision Studio permite enviar imagens e ver os resultados de cada recurso direto no navegador.