
Generative AI: Fundamentos da IA

Generative AI, ou IA generativa, é a capacidade da inteligência artificial de criar conteúdo original a partir de entradas em linguagem natural. Com ela, você descreve o que deseja em português ou em inglês, e o modelo responde com textos, imagens, código e outros formatos.
É comum interagirmos com uma generative AI dentro de aplicações de conversa, os chats. O exemplo mais famoso é o ChatGPT, mas a mesma tecnologia está presente em assistentes de código, ferramentas de escrita e copilotos corporativos.
Fundamentos da inteligência artificial
Esta publicação faz parte de uma série de artigos sobre os fundamentos da inteligência artificial. Confira abaixo a série completa.
- Parte 1: O que é Inteligência Artificial
- Parte 2: Machine Learning
- Parte 3: Computer Vision
- Parte 4: Natural Language Processing
- Parte 5: Document Intelligence
- Parte 6: Knowledge Mining
- Parte 7: Generative AI (este artigo)
Se você chegou agora, vale começar pela parte sobre processamento de linguagem natural. Afinal, boa parte do que veremos aqui depende de como as máquinas lidam com texto.
O que é generative AI
A generative AI é um segmento da inteligência artificial em que os modelos aprendem a gerar conteúdo novo. Em outras palavras, eles não apenas classificam ou analisam dados, mas produzem algo que não existia antes.
Na prática, você escreve uma descrição em linguagem cotidiana, e o modelo responde com o resultado adequado. Por exemplo, ele pode redigir um e-mail, resumir um relatório, criar uma imagem ou sugerir um trecho de código.
Essa é a principal diferença em relação às técnicas vistas nas partes anteriores da série. Um modelo de computer vision, por exemplo, identifica objetos em uma imagem, enquanto um modelo generativo cria a própria imagem.
O mesmo vale para o processamento de linguagem natural tradicional. Enquanto ele extrai entidades ou detecta sentimentos, a generative AI escreve textos inteiros com coerência.
Tipos de conteúdo que a generative AI cria
A generative AI trabalha com várias modalidades de conteúdo. As mais comuns aparecem a seguir.
- Texto: respostas a perguntas, resumos, traduções, artigos e roteiros.
- Código: sugestões de funções, testes, consultas SQL e explicações de trechos existentes.
- Imagens: ilustrações e fotos sintéticas geradas a partir de uma descrição.
- Áudio: transcrição de fala em texto e síntese de voz a partir de texto.
Além disso, alguns modelos são multimodais. Ou seja, eles aceitam texto e imagem na entrada e conseguem, por exemplo, descrever uma foto ou responder perguntas sobre um diagrama.
Como a generative AI funciona
No centro da generative AI estão os grandes modelos de linguagem, os LLMs (large language models). Também existem versões mais compactas, chamadas de SLMs (small language models).
Esses modelos guardam as relações linguísticas e semânticas entre as palavras de um vocabulário. Com isso, eles conseguem interpretar uma entrada em linguagem natural e gerar respostas relevantes.
A documentação da Microsoft compara os LLMs a uma versão muito poderosa do texto preditivo dos celulares. Em essência, o modelo recebe um prompt e prevê, passo a passo, qual é a continuação mais provável.
O resultado dessa previsão recebe o nome de completion. Para quem quer se aprofundar, o artigo sobre como funciona uma LLM detalha esse processo.
Tokens
O primeiro passo do treinamento é montar um vocabulário enorme. No entanto, os modelos não trabalham exatamente com palavras, e sim com tokens.
Um token pode ser uma palavra inteira, parte de uma palavra, um sinal de pontuação ou outra sequência comum de caracteres. Por exemplo, o prefixo "un" de "unbelievable" pode virar um token próprio.
Cada token recebe um identificador numérico único. Dessa forma, o modelo opera sobre números, e não sobre o texto em si.
Entender tokens também tem impacto financeiro. Afinal, serviços como o Azure OpenAI costumam cobrar por token de entrada e de saída, e o tamanho do contexto também é medido em tokens.
Embeddings e transformers
Depois da tokenização, cada token ganha um vetor, ou seja, uma lista de valores numéricos. Durante o treinamento, esses vetores passam a carregar características semânticas e recebem o nome de embeddings.
Quem faz esse trabalho é a arquitetura transformer, apresentada no artigo científico "Attention is all you need". Ela usa um mecanismo chamado attention, que avalia como cada token é influenciado pelos tokens ao redor.
Por exemplo, na frase "ouvi um cachorro latir", as palavras "ouvi" e "cachorro" pesam mais para prever "latir" do que o artigo "um". Assim, o modelo aprende quais palavras costumam aparecer juntas.
Como resultado, tokens usados em contextos parecidos geram vetores com direções parecidas. Por isso, "cachorro" e "filhote" ficam próximos, enquanto "skate" fica distante.
Da previsão à resposta completa
Na geração, o modelo considera apenas os tokens que vêm antes da posição atual. Em seguida, ele calcula o próximo token mais provável e o acrescenta à sequência.
Esse ciclo se repete até que o modelo preveja o fim da resposta. Portanto, um parágrafo inteiro nasce de centenas de pequenas previsões encadeadas.
Prompts: como conversar com um modelo
O prompt é a entrada que você envia ao modelo para obter uma resposta. Pode ser uma pergunta, uma instrução ou apenas um comentário que inicia a conversa.
Existem dois tipos principais de prompt. O prompt de sistema define o comportamento, o tom e as restrições do modelo, enquanto o prompt de usuário traz a pergunta ou a tarefa específica.
Normalmente, a aplicação define o prompt de sistema, e o usuário escreve o restante. Além disso, as aplicações de chat guardam o histórico da conversa e o reenviam a cada nova mensagem, para que o modelo mantenha o contexto.
Algumas práticas melhoram bastante os resultados de uma solução de generative AI:
- Seja claro e específico, com instruções explícitas.
- Adicione contexto, como público, tema e formato desejado.
- Use exemplos quando quiser um estilo particular.
- Peça estrutura, como listas, tabelas ou passos numerados.
Grounding e RAG
Um modelo de linguagem conhece apenas o que viu no treinamento. Por isso, ele não sabe nada sobre as políticas internas da sua empresa ou sobre documentos recentes.
A técnica de retrieval augmented generation, o RAG, resolve esse problema. Primeiro, a aplicação busca documentos relevantes, e depois inclui esse conteúdo no prompt junto com a pergunta do usuário.
Com isso, a resposta fica ancorada em dados reais, o que chamamos de grounding. Por exemplo, um assistente de reembolso pode consultar a política de despesas antes de responder quanto o funcionário pode gastar em uma viagem.
Essa técnica conversa diretamente com a parte sobre knowledge mining, já que ambas dependem de indexar e recuperar informação de forma eficiente.
Copilotos e generative AI
Um copiloto é um assistente baseado em generative AI que trabalha ao lado do usuário. Ele recebe pedidos em linguagem natural e ajuda a concluir tarefas dentro de uma aplicação.
O termo ficou popular com o GitHub Copilot e com o Microsoft Copilot, mas qualquer empresa pode criar o próprio. Na prática, um copiloto combina um modelo de linguagem, um prompt de sistema bem definido e, muitas vezes, dados da organização via RAG.
Assim, um copiloto de atendimento pode responder dúvidas de clientes com base no catálogo de produtos. Já um copiloto interno pode ajudar o time financeiro a consultar relatórios.
Generative AI no Microsoft Azure
O Azure OpenAI Service é a solução em nuvem da Microsoft para publicação, customização e hospedagem de modelos de generative AI. Ele reúne os modelos mais novos da OpenAI e APIs com a segurança e a escalabilidade da plataforma Azure.
Além disso, o serviço permite escolher entre diversos modelos generativos, cada um voltado para um propósito. Há modelos GPT para texto e conversa, modelos de embeddings para busca semântica, modelos de geração de imagens e modelos de áudio.
Outro ponto importante é a privacidade. Segundo a documentação da Microsoft, o Azure OpenAI roda no ambiente do Azure e não usa os dados dos clientes para treinar os modelos.
O serviço também oferece filtros de conteúdo, autenticação com Microsoft Entra ID e diferentes tipos de implantação. Portanto, ele atende cenários corporativos que exigem governança e controle de dados.
Azure AI Studio
Você pode usar o Azure AI Studio para criar soluções de generative AI. Por exemplo, ele permite montar assistentes baseados em texto, os copilotos, que usam modelos do Azure OpenAI.
No portal, você implanta um modelo, testa prompts em um playground e conecta seus próprios dados. Em seguida, pode publicar a solução como um aplicativo ou consumi-la via API.
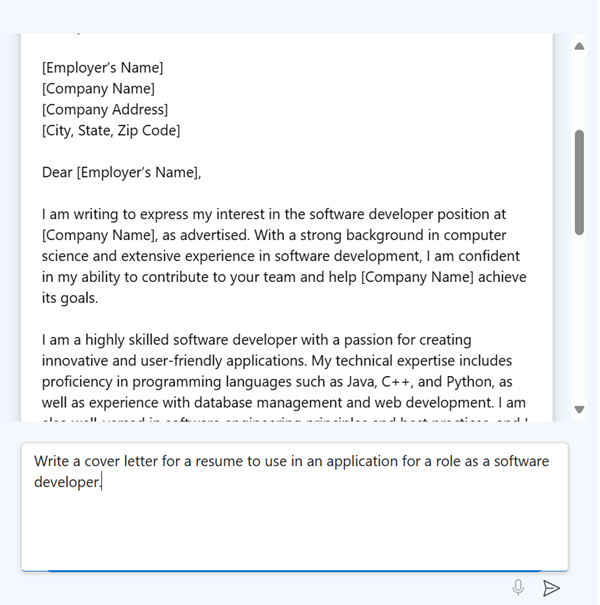
Neste exemplo, um modelo do Azure AI Service potencializa um copiloto. Assim, ele gera conteúdo original como resposta às entradas do usuário em linguagem natural.
Vale registrar que a Microsoft renomeou o Azure AI Studio para Azure AI Foundry e, depois, para Microsoft Foundry. Os conceitos deste artigo, no entanto, continuam os mesmos.
Consumindo um modelo de generative AI com C#
Além do portal, você pode consumir um modelo de generative AI direto do seu código. O pacote Azure.AI.OpenAI oferece o cliente para .NET.
O exemplo a seguir envia um prompt de sistema e uma pergunta do usuário para um modelo implantado no Azure OpenAI.
using Azure.AI.OpenAI;
using Azure.Identity;
using OpenAI.Chat;

var endpoint = new Uri("https://your-resource-name.openai.azure.com/");

// Autenticação sem chave, usando a identidade do ambiente
AzureOpenAIClient azureClient = new(endpoint, new DefaultAzureCredential());

// O nome aqui é o da implantação criada no portal
ChatClient chatClient = azureClient.GetChatClient("gpt-4o");

ChatCompletion completion = await chatClient.CompleteChatAsync(
[
    // O prompt de sistema define o comportamento do modelo
    new SystemChatMessage("You are a helpful assistant that answers in a short, friendly way."),
    // O prompt de usuário traz a pergunta
    new UserChatMessage("What is generative AI?")
]);

Console.WriteLine(completion.Content[0].Text);
Repare que o SystemChatMessage representa o prompt de sistema, e o UserChatMessage representa a pergunta. Para manter uma conversa, basta acrescentar as mensagens anteriores na lista, incluindo as respostas como AssistantChatMessage.
Se você quer ir além desse exemplo, o artigo sobre Azure OpenAI com .NET e o resumo de IA generativa no .NET mostram outros cenários.
Limitações da generative AI
Apesar dos resultados impressionantes, a generative AI tem limitações importantes. A primeira é que o modelo prevê o texto mais provável, e não necessariamente o texto verdadeiro.
Por isso, ele pode inventar fatos, referências ou trechos de código com total confiança. Esse comportamento recebe o nome de alucinação e exige revisão humana nas respostas críticas.
A segunda limitação é o conhecimento congelado no tempo. Como os dados de treinamento têm uma data de corte, o modelo desconhece eventos posteriores, a menos que a aplicação forneça esse contexto via RAG.
Além disso, existe o limite da janela de contexto, medida em tokens. Prompts muito longos custam mais e deixam menos espaço para a resposta.
Por fim, o custo e a latência crescem com o tamanho do modelo e com o volume de tokens. Dessa forma, escolher o modelo certo para cada tarefa também faz parte de um bom projeto.
IA responsável
Modelos generativos são probabilísticos e podem errar. Além disso, eles podem gerar conteúdo ofensivo, enviesado ou simplesmente incorreto com aparência convincente.
Por isso, a Microsoft define princípios de IA responsável que valem para qualquer solução de generative AI:
- Justiça: reduzir vieses nos dados e testar o sistema para evitar discriminação.
- Confiabilidade e segurança: reconhecer que o modelo não é infalível e mitigar riscos.
- Privacidade e segurança: proteger os dados de treinamento e evitar vazamento de informações.
- Inclusão: garantir que a solução atenda a todos os usuários.
- Transparência: deixar claro como o sistema funciona e quais são seus limites.
- Responsabilização: definir governança, porque pessoas e empresas respondem pelo que publicam.
Na prática, os filtros de conteúdo do Azure OpenAI são uma das ferramentas para aplicar esses princípios. Ainda assim, a responsabilidade começa no desenho da solução e segue até a operação.
Conclusão
Generative AI é o segmento da inteligência artificial que cria conteúdo original a partir de linguagem natural, tanto na entrada quanto na saída. Com ela, é possível gerar textos, imagens, código e áudio.
Por trás dessa capacidade estão os modelos de linguagem, que trabalham com tokens, embeddings e o mecanismo de attention dos transformers. Além disso, a qualidade da resposta depende muito do prompt e do contexto fornecido.
No Azure, o Azure OpenAI Service fornece publicação, customização e hospedagem de modelos de generative AI. Já o Azure AI Studio permite criar copilotos capazes de gerar conteúdo original com base nas entradas do usuário.
Com este artigo, encerramos a série sobre os fundamentos da inteligência artificial. Se quiser revisar desde o começo, volte para a parte 1 da série.
FAQ
Qual a diferença entre generative AI e IA tradicional?
A IA tradicional costuma classificar, prever ou analisar dados existentes. Já a generative AI cria conteúdo novo, como textos, imagens e código.
O que é um LLM?
Trata-se de um grande modelo de linguagem treinado com volumes enormes de texto para prever o próximo token de uma sequência.
O que é um token?
Ele é a menor unidade com que o modelo trabalha, podendo ser uma palavra, parte de uma palavra ou pontuação.
O que é o Azure OpenAI Service?
É o serviço da Microsoft que hospeda os modelos da OpenAI no Azure, com recursos de segurança, escala e governança corporativa.
O Azure AI Studio ainda existe com esse nome?
Não. A Microsoft renomeou o portal para Azure AI Foundry e, mais tarde, para Microsoft Foundry.
O que é RAG?
É uma técnica que busca documentos relevantes e os inclui no prompt, para que a resposta se baseie em dados reais.