
SQL Server: Conhecendo os cursores

Um cursor no SQL Server é uma estrutura que permite percorrer o resultado de uma consulta linha a linha e executar ações sobre cada registro. Neste artigo, você vai montar um cursor completo para atualizar a cidadania de pessoas em uma tabela, concatenando os campos Citizenship e State.
Além do passo a passo, você vai entender o ciclo de vida do cursor, os valores de @@FETCH_STATUS, as opções de declaração e os cenários em que uma instrução baseada em conjunto resolve o mesmo problema com menos custo.
O que é um cursor no SQL Server
Bancos relacionais trabalham com conjuntos de linhas. Por exemplo, um SELECT devolve de uma vez todas as linhas que satisfazem a cláusula WHERE, e a documentação chama esse conjunto de result set.
Algumas rotinas, porém, precisam tratar uma linha ou um pequeno bloco de linhas por vez. Segundo a documentação oficial sobre cursores, o cursor existe justamente para estender o result set e oferecer esse mecanismo.
Na prática, um cursor no SQL Server permite posicionar a leitura em uma linha específica e recuperar um registro a partir da posição atual. Além disso, ele permite modificar a linha em que está posicionado e dá acesso ao resultado dentro de scripts, stored procedures e triggers.
Este artigo trata dos cursores Transact-SQL, aqueles criados com a instrução DECLARE CURSOR. O SQL Server também implementa cursores de API e cursores de cliente, usados por drivers como ODBC e OLE DB, mas eles ficam fora do escopo aqui.
Ciclo de vida de um cursor no SQL Server
Todo cursor no SQL Server segue o mesmo ciclo, independentemente do que você faz com os dados. Por isso, vale conhecer as cinco instruções antes de escrever a primeira linha de código.
DECLARE CURSORdefine o cursor e a consulta que gera o result set.OPENexecuta a consulta e popula o result set.FETCHdevolve uma linha do result set e avança a posição.CLOSElibera o result set atual e os bloqueios do cursor.DEALLOCATEremove a referência ao cursor e libera seus recursos.
Repare que fechar e desalocar são passos diferentes. O CLOSE mantém as estruturas de dados disponíveis para uma nova abertura, enquanto o DEALLOCATE descarta tudo.
Cenário do exemplo
O exemplo usa uma tabela Person com as colunas Id, Citizenship e State. Como os dois últimos campos se referem à cidadania da pessoa, a regra de negócio considera a coluna de estado dispensável.
Contudo, antes de excluir essa coluna, precisamos preservar a informação. Então, o cursor vai concatenar o valor de State ao final de Citizenship, separado por uma barra.
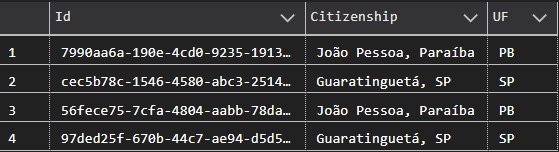
Na imagem, a coluna de estado aparece com o nome original UF. Nos exemplos de código, ela se chama State, porque todo o código do artigo segue nomes em inglês.
Declarando as variáveis
Começamos abrindo uma transação que termina com ROLLBACK. Dessa forma, nenhuma execução feita durante o desenvolvimento fica gravada no banco, e você pode rodar o script quantas vezes quiser.
Em seguida, declaramos as variáveis que vão receber os valores de cada linha. O @id serve como referência ao registro na hora de atualizar, enquanto @personCitizenship e @personState armazenam a cidadania e o estado.
BEGIN TRANSACTION

    DECLARE
        @id UNIQUEIDENTIFIER,
        @personCitizenship NVARCHAR(120),
        @personState NVARCHAR(120)

ROLLBACK
Os tipos das variáveis devem acompanhar os tipos das colunas lidas. Assim, você evita conversões implícitas e truncamentos silenciosos durante o FETCH.
Declarando o cursor no SQL Server
Agora declaramos o cursor e associamos a ele a consulta que seleciona os campos necessários. O SELECT do cursor no SQL Server define exatamente quais colunas e linhas o laço vai percorrer.
BEGIN TRANSACTION

    DECLARE
        @id UNIQUEIDENTIFIER,
        @personCitizenship NVARCHAR(120),
        @personState NVARCHAR(120)

    -- 01. Percorrer os registros
    DECLARE [cur_Person_CitizenshipState] CURSOR FOR
        SELECT
            [Id],
            [Citizenship],
            [State]
        FROM
            [Person]

ROLLBACK
Nesse ponto, o SQL Server ainda não executou a consulta. A declaração apenas registra o nome do cursor, a consulta e as características de navegação.
Você também pode usar variáveis dentro do SELECT do cursor, por exemplo para filtrar um grupo de pessoas. Contudo, a documentação avisa que mudar o valor dessas variáveis depois da declaração não altera o cursor.
A referência do DECLARE CURSOR lembra que as palavras-chave FOR BROWSE e INTO não são permitidas dentro do SELECT de um cursor. Se precisar revisar a sintaxe de consultas, o artigo começando com SQL Server na prática cobre estrutura, inserção e consulta.
Manipulando os registros com FETCH e WHILE
Com o cursor declarado, falta abri-lo e percorrer as linhas. O script a seguir completa os passos de 02 a 07.
BEGIN TRANSACTION

    DECLARE
        @id UNIQUEIDENTIFIER,
        @personCitizenship NVARCHAR(120),
        @personState NVARCHAR(120)

    -- 01. Percorrer os registros
    DECLARE [cur_Person_CitizenshipState] CURSOR FOR
        SELECT
            [Id],
            [Citizenship],
            [State]
        FROM
            [Person]

    -- 02. Abrir cursor
    OPEN [cur_Person_CitizenshipState]

    -- 03. Ler a primeira linha
    FETCH NEXT FROM
        [cur_Person_CitizenshipState]
    INTO
        @id,
        @personCitizenship,
        @personState

    -- 04. Percorrer as linhas do cursor
    WHILE @@FETCH_STATUS = 0
    BEGIN

        -- 05. Executar rotinas no registro
        UPDATE [Person]
            SET [Citizenship] = @personCitizenship + '/' + @personState
        WHERE
            [Id] = @id

        -- 06. Ler o próximo registro
        FETCH NEXT FROM [cur_Person_CitizenshipState] INTO @id, @personCitizenship, @personState
    END

    -- 07. Encerrar a leitura do cursor
    CLOSE [cur_Person_CitizenshipState]
ROLLBACK
No passo 02, o OPEN executa a consulta e popula o result set. Logo depois, no passo 03, o primeiro FETCH NEXT lê a linha inicial e copia os valores para as variáveis, na mesma ordem das colunas do SELECT.
O passo 04 declara o laço WHILE, que roda enquanto a última leitura tiver sucesso. Dentro dele, o passo 05 atualiza a linha atual, e o filtro por Id garante que só aquele registro muda.
Por fim, o passo 06 lê o próximo registro e atualiza as variáveis, fazendo o laço recomeçar enquanto houver linhas. Quando a leitura passa do fim do result set, o laço termina e o passo 07 fecha o cursor.
Esquecer o FETCH dentro do laço é o erro mais comum nesse padrão. Nesse caso, @@FETCH_STATUS continua em 0 e o WHILE nunca termina.
Como funciona o status do FETCH
O @@FETCH_STATUS não é uma variável declarada por você, e sim uma função de sistema do tipo inteiro. Ela devolve o estado da última instrução FETCH executada na conexão.
Segundo a documentação do @@FETCH_STATUS, a função pode retornar quatro valores:
| Valor | Significado |
|---|---|
| 0 | O FETCH teve sucesso |
| -1 | O FETCH falhou ou a linha está além do result set |
| -2 | A linha buscada não existe mais |
| -9 | O cursor não está executando uma operação de fetch |
Portanto, ao chegar ao fim dos registros, a função passa a retornar -1, e não 1. Como o laço testa a igualdade com 0, qualquer valor diferente encerra a repetição, inclusive o -2 de uma linha excluída.
Há ainda um cuidado importante. Como a função é global para todos os cursores da conexão, o teste precisa acontecer antes de qualquer FETCH em outro cursor, como em cursores aninhados ou em procedures chamadas dentro do laço.
Finalização com CLOSE e DEALLOCATE
Depois de fechar o cursor, ainda falta remover a referência a ele. Caso contrário, o nome continua ocupado e os recursos ficam reservados sem necessidade.
BEGIN TRANSACTION

    DECLARE
        @id UNIQUEIDENTIFIER,
        @personCitizenship NVARCHAR(120),
        @personState NVARCHAR(120)

    -- 01. Percorrer os registros
    DECLARE [cur_Person_CitizenshipState] CURSOR FOR
        SELECT
            [Id],
            [Citizenship],
            [State]
        FROM
            [Person]

    -- 02. Abrir cursor
    OPEN [cur_Person_CitizenshipState]

    -- 03. Ler a primeira linha
    FETCH NEXT FROM
        [cur_Person_CitizenshipState]
    INTO
        @id,
        @personCitizenship,
        @personState

    -- 04. Percorrer as linhas do cursor
    WHILE @@FETCH_STATUS = 0
    BEGIN

        -- 05. Executar rotinas no registro
        UPDATE [Person]
            SET [Citizenship] = @personCitizenship + '/' + @personState
        WHERE
            [Id] = @id

        -- 06. Ler o próximo registro
        FETCH NEXT FROM [cur_Person_CitizenshipState] INTO @id, @personCitizenship, @personState
    END

    -- 07. Encerrar a leitura do cursor
    CLOSE [cur_Person_CitizenshipState]

    -- 08. Liberar o cursor da memória
    DEALLOCATE [cur_Person_CitizenshipState]
ROLLBACK
O passo 08 usa DEALLOCATE. De acordo com a referência do DEALLOCATE, quando a última referência ao cursor sai de cena, o SQL Server libera as estruturas de dados que o compõem.
Além disso, um nome de cursor só pode ser reutilizado no mesmo escopo depois do DEALLOCATE. Por isso, se o cursor for global, rodar o script de novo na mesma conexão sem esse passo gera erro informando que o cursor já existe.
Verificação e COMMIT
Com o script completo, execute tudo ainda com ROLLBACK. Antes do ROLLBACK, adicione um SELECT para conferir se as modificações ocorreram como planejado.
SELECT
    [Id],
    [Citizenship],
    [State]
FROM [Person]
Os valores resultantes devem ficar semelhantes aos da imagem abaixo, com o estado anexado ao final da cidadania.
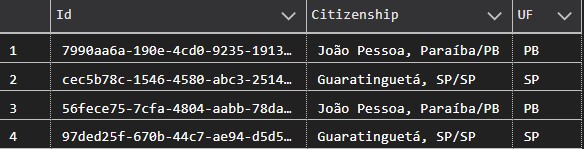
Depois de confirmar o resultado, troque o ROLLBACK por COMMIT e execute o script novamente. Assim, as alterações passam a valer de forma definitiva.
Por fim, com a informação preservada em Citizenship, você pode excluir a coluna de estado:
ALTER TABLE [Person]
    DROP COLUMN [State]
GO
Faça essa exclusão só depois do COMMIT e de uma nova conferência dos dados. Afinal, sem a coluna original, não há como desfazer a concatenação de forma simples.
Opções de declaração do cursor no SQL Server
O exemplo usou a forma mais simples de declaração. No entanto, a sintaxe estendida do Transact-SQL aceita opções que mudam escopo, navegação, sensibilidade a alterações e concorrência.
DECLARE cursor_name CURSOR [ LOCAL | GLOBAL ]
    [ FORWARD_ONLY | SCROLL ]
    [ STATIC | KEYSET | DYNAMIC | FAST_FORWARD ]
    [ READ_ONLY | SCROLL_LOCKS | OPTIMISTIC ]
    [ TYPE_WARNING ]
    FOR select_statement
    [ FOR UPDATE [ OF column_name [ , ...n ] ] ]
Conhecer essas opções ajuda a escolher o cursor no SQL Server mais leve para cada tarefa. Na maioria das rotinas de manutenção, você só precisa ler as linhas em sequência, uma única vez.
Escopo LOCAL e GLOBAL
Um cursor LOCAL vale apenas dentro do batch, da stored procedure ou do trigger que o criou. Além disso, o SQL Server o desaloca implicitamente quando esse bloco termina.
Já um cursor GLOBAL vale para toda a conexão e só é desalocado de forma implícita na desconexão. Quando você não informa nenhum dos dois, a opção de banco default to local cursor decide o escopo.
Tipos de cursor no SQL Server
Existem quatro tipos de cursor no SQL Server, e cada um lida de um jeito com as mudanças feitas na tabela durante a leitura.
- Forward-only: lê as linhas em sequência, do início ao fim, sem voltar. Quando também é somente leitura, a documentação o chama de firehose.
- Static: monta uma cópia completa do resultado no
tempdbao abrir e não enxerga alterações posteriores. Cursores estáticos no SQL Server são sempre somente leitura. - Keyset: fixa quais linhas fazem parte do resultado e a ordem delas na abertura, mas enxerga mudanças nos valores dessas linhas.
- Dynamic: reflete todas as alterações confirmadas a cada leitura, inclusive inserções e exclusões feitas por outros usuários.
Um detalhe pouco conhecido envolve o tipo keyset. Se a consulta referenciar ao menos uma tabela sem índice único, o SQL Server converte o cursor keyset em estático, e a opção TYPE_WARNING faz o servidor avisar o cliente sobre esse tipo de conversão.
Há também o FAST_FORWARD, que combina FORWARD_ONLY e READ_ONLY com otimizações de desempenho. A documentação recomenda cursores desse tipo quando não há necessidade de atualizar tabelas por meio do cursor.
No nosso exemplo, o UPDATE acontece em uma instrução separada, filtrada pelo Id. Então, a declaração pode ficar mais leve:
-- Cursor local, somente leitura e apenas para frente
DECLARE [cur_Person_CitizenshipState] CURSOR LOCAL FAST_FORWARD FOR
    SELECT
        [Id],
        [Citizenship],
        [State]
    FROM
        [Person]
Atualização posicionada com WHERE CURRENT OF
Outra forma de alterar a linha atual é a atualização posicionada. Em vez de filtrar pela chave, o UPDATE usa a cláusula WHERE CURRENT OF com o nome do cursor.
DECLARE
    @personCitizenship NVARCHAR(120),
    @personState NVARCHAR(120)

DECLARE [cur_Person_CitizenshipState] CURSOR LOCAL FOR
    SELECT
        [Citizenship],
        [State]
    FROM
        [Person]
    FOR UPDATE OF [Citizenship]

OPEN [cur_Person_CitizenshipState]

FETCH NEXT FROM [cur_Person_CitizenshipState] INTO @personCitizenship, @personState

WHILE @@FETCH_STATUS = 0
BEGIN
    -- Atualiza exatamente a linha em que o cursor está posicionado
    UPDATE [Person]
        SET [Citizenship] = @personCitizenship + '/' + @personState
    WHERE CURRENT OF [cur_Person_CitizenshipState]

    FETCH NEXT FROM [cur_Person_CitizenshipState] INTO @personCitizenship, @personState
END

CLOSE [cur_Person_CitizenshipState]
DEALLOCATE [cur_Person_CitizenshipState]
Nesse caso, a cláusula FOR UPDATE OF indica quais colunas podem mudar pelo cursor. Por outro lado, um cursor READ_ONLY ou FAST_FORWARD não aceita WHERE CURRENT OF, então essa abordagem exige um cursor atualizável.
Quando evitar um cursor no SQL Server
O cursor resolve bem rotinas que realmente dependem de processar uma linha por vez. Por exemplo, chamar uma stored procedure para cada registro ou montar um relatório com cursores aninhados, como mostra a própria documentação.
Contudo, o banco relacional foi pensado para trabalhar com conjuntos. Assim, a concatenação do nosso exemplo cabe em uma única instrução baseada em conjunto:
-- Mesmo resultado do cursor, em uma única instrução
UPDATE [Person]
    SET [Citizenship] = [Citizenship] + '/' + [State]
Essa versão faz uma única passagem pela tabela. Em contrapartida, o cursor executa um UPDATE separado para cada linha, o que custa mais em tabelas grandes.
A documentação também alerta que cursores podem usar worktables no tempdb, o que gera custo de I/O e pode virar gargalo. Além disso, ela aponta que, em alguns cenários com chave primária, um laço WHILE substitui o cursor sem esse custo extra.
Vale um cuidado com valores nulos em qualquer das abordagens. Com a configuração padrão CONCAT_NULL_YIELDS_NULL ligada, concatenar NULL com o operador + resulta em NULL, então filtre ou trate essas linhas antes de excluir a coluna.
Se quiser explorar outros recursos que substituem laços por consultas, o artigo sobre consultas SQL avançadas traz exemplos práticos. Para praticar em um ambiente isolado, veja também como rodar o SQL Server no Docker.
Conclusão
Agora você conhece a estrutura básica de um cursor no SQL Server: declarar, abrir, ler com FETCH, percorrer com WHILE, fechar e desalocar. Com essa base, você pode criar rotinas para o seu projeto e, se fizer sentido, colocá-las dentro de stored procedures.
Lembre de testar sempre dentro de uma transação com ROLLBACK antes do COMMIT. Além disso, prefira LOCAL FAST_FORWARD quando o cursor só precisa ler as linhas em sequência.
Por fim, antes de recorrer a um cursor no SQL Server, verifique se uma instrução baseada em conjunto resolve o problema. Na maioria das vezes, ela resolve com menos código e melhor desempenho.
FAQ
O que @@FETCH_STATUS retorna no fim dos registros?
Retorna -1, que indica falha no FETCH ou linha além do result set. O valor 0 indica leitura com sucesso.
Qual a diferença entre CLOSE e DEALLOCATE?
O CLOSE libera o result set atual e os bloqueios, mas permite reabrir o cursor. Já o DEALLOCATE remove a referência e libera as estruturas de dados do cursor.
Preciso usar DEALLOCATE em um cursor LOCAL?
O SQL Server desaloca o cursor LOCAL ao fim do batch, da procedure ou do trigger. Mesmo assim, chamar DEALLOCATE explicitamente libera os recursos mais cedo e deixa o código mais claro.
Cursor é sempre lento?
Não necessariamente, mas ele processa uma linha por vez e pode usar worktables no tempdb. Quando uma instrução baseada em conjunto resolve o problema, ela tende a ser mais eficiente.
Qual tipo de cursor usar para apenas ler dados?
Use FAST_FORWARD, que combina FORWARD_ONLY e READ_ONLY com otimizações de desempenho. Junto com LOCAL, ele limita o escopo ao bloco atual.
Posso atualizar a linha atual sem filtrar pela chave?
Sim, com um UPDATE que usa WHERE CURRENT OF e um cursor atualizável declarado com FOR UPDATE. Cursores READ_ONLY e FAST_FORWARD não aceitam essa cláusula.