
Começando com SQL Server na prática - Estrutura, inserção e consulta

Aprender SQL Server na prática significa criar um banco de dados do zero, estruturar as tabelas, inserir registros e consultá-los com comandos simples e diretos. Neste artigo, você vai fazer exatamente isso em uma instância local do Microsoft SQL Server, seguindo boas práticas na escrita das queries.
O objetivo é colocar você diante de um cenário prático de comandos SQL. Por isso, o foco está em executar cada instrução e analisar o resultado, sem se perder em teoria.
Na prática, cada seção traz um script pronto para rodar no SQL Server, seguido da explicação do que ele faz.
O que você vai construir no SQL Server na prática
Este conteúdo está dividido em duas partes. Nesta primeira parte, você aprende SQL Server na prática criando o banco, inserindo e consultando registros.
Já na segunda parte da série, você aprende a editar e remover dados e a alterar a estrutura do banco. Assim, as duas leituras se completam.
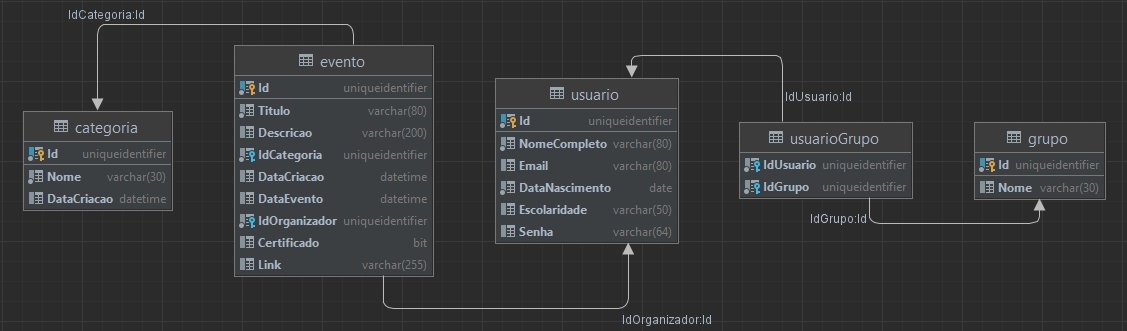
O cenário escolhido é um sistema simples de eventos. Uma tabela de eventos referencia a categoria do evento e o organizador, enquanto o organizador pertence a um grupo que define seu acesso.
Preparando o ambiente
O SGBD (sistema gerenciador de banco de dados) usado aqui é o Microsoft SQL Server 2017. Ele roda em um container Docker através do WSL, no Windows.
Para escrever e executar as queries, o editor escolhido foi o Azure Data Studio. Além disso, o JetBrains DataGrip aparece apenas para exibir o diagrama do banco e ilustrar cada etapa.
Caso ainda não tenha esses recursos instalados, os artigos abaixo mostram o caminho:
- Docker: instalação, configuração e primeiros passos
- SQL Server no Docker
- Download e instalação do Azure Data Studio
Vale um aviso importante: a Microsoft aposentou o Azure Data Studio em 28 de fevereiro de 2026. Hoje, a substituta oficial é a extensão MSSQL para o Visual Studio Code, que abre os mesmos scripts sem conversão.
Na prática, os comandos deste artigo funcionam em qualquer editor conectado ao SQL Server. Portanto, você pode seguir o passo a passo no VS Code ou no SQL Server Management Studio.
Conectando ao banco master
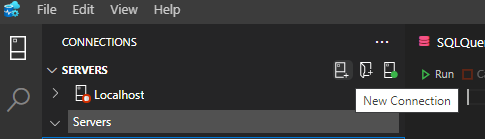
Com o SGBD e o editor instalados, o primeiro passo é conectar ao servidor. Para isso, abra o Azure Data Studio e clique no botão New Connection, no canto superior esquerdo, logo abaixo do menu principal.
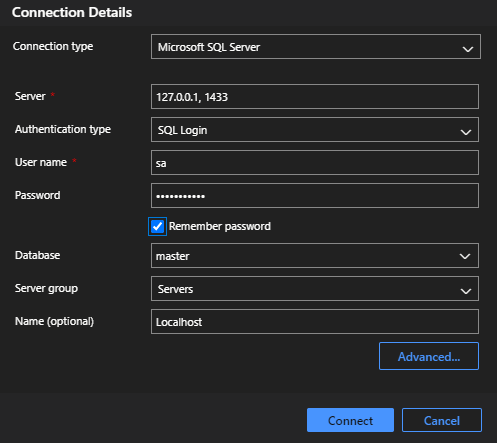
Em seguida, conecte ao banco master, que o SQL Server cria por padrão durante a instalação. Para isso, preencha o formulário que aparece logo depois:
Campos da conexão
Cada campo do formulário tem uma função específica. Vale entender todos antes de clicar em conectar:
- Connection type: tipo de conexão. Mantenha o padrão, Microsoft SQL Server.
- Server: servidor ao qual você deseja se conectar. Use
localhostou127.0.0.1para servidores locais, ou então o IP ou domínio do servidor remoto. - Authentication type: forma de autenticação. Com SQL Login, você informa usuário e senha, enquanto Windows Authentication usa o usuário do Windows, sem pedir credenciais.
- Database: banco ao qual você vai se conectar. Como o banco do projeto ainda não existe, selecione o
master, que serve de ponto de partida para o script de criação. - Server group: grupo de servidores. Ele organiza a visualização no menu lateral e ajuda bastante quando você trabalha com muitos servidores.
- Name: nome do conjunto de configurações. Ele não influencia a conexão e serve apenas para identificá-la dentro do editor.
Para entender melhor cada parte da string de conexão gerada por esse formulário, leia o artigo SQL Server: descomplicando as connection strings.
Criando o banco de dados no SQL Server na prática
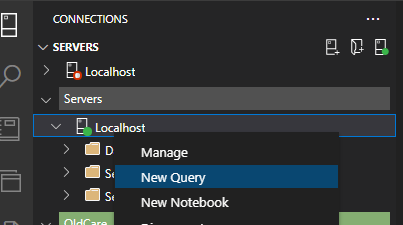
Para começar os scripts, clique com o botão direito sobre o servidor configurado e selecione New Query. Assim, o editor abre a primeira query.
Então, digite o comando abaixo:
-- Cria o banco apenas se ele ainda não existir
IF NOT EXISTS (SELECT * FROM sys.databases WHERE name = N'events')
    BEGIN
        CREATE DATABASE [events]
    END;
A primeira linha faz uma verificação antes de qualquer coisa. O IF NOT EXISTS confere se o banco já existe, usando um SELECT na visão sys.databases.
Esse SELECT procura um banco com o nome informado. Caso ele não exista, o SQL Server executa o CREATE DATABASE, que cria o banco com esse nome.
Repare também que o nome do banco aparece entre colchetes, como em [events]. Essa convenção se repete em todo o artigo e evita conflitos com palavras reservadas do SQL Server na prática do dia a dia.
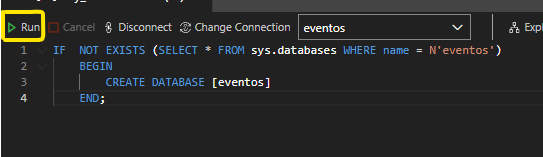
Para executar o comando, pressione F5 ou clique no botão Run acima do script.
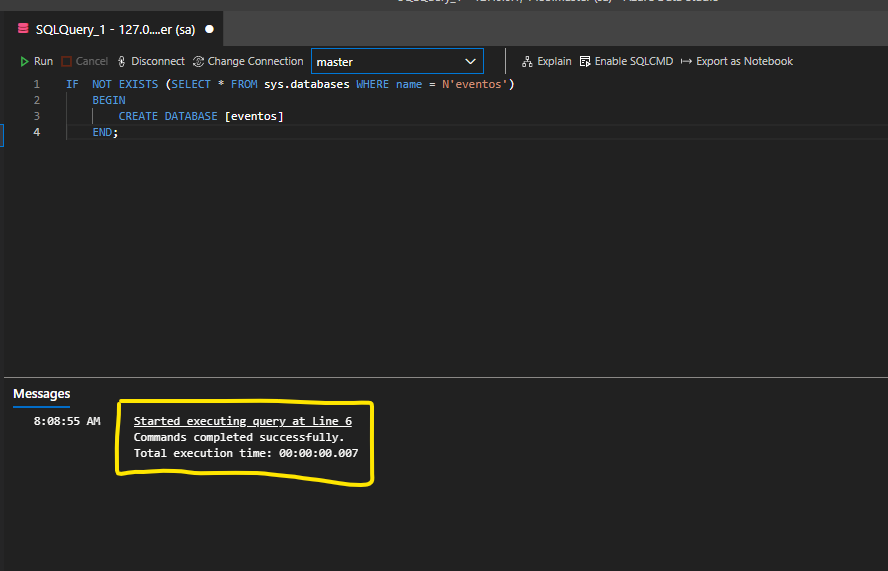
Logo abaixo do editor, aparece a confirmação da execução:
Criando as tabelas
Agora, no mesmo script, crie as tabelas do projeto. O trecho fica assim:
USE [events]
GO

-- Grupos que definem o acesso dos usuários
IF NOT EXISTS (SELECT * FROM sysobjects WHERE name = 'group' AND xtype = 'U')
    BEGIN
        CREATE TABLE [group] (
            [Id] UNIQUEIDENTIFIER NOT NULL,
            [Name] VARCHAR(30),
            CONSTRAINT [pk_group] PRIMARY KEY ([Id])
        )
    END

-- Usuários que organizam os eventos
IF NOT EXISTS (SELECT * FROM sysobjects WHERE name = 'user' AND xtype = 'U')
    BEGIN
        CREATE TABLE [user] (
            [Id] UNIQUEIDENTIFIER NOT NULL,
            [FullName] VARCHAR(80) NOT NULL,
            [Email] VARCHAR(80),
            [BirthDate] DATE NOT NULL,
            [Education] VARCHAR(50),
            [Password] VARCHAR(64),
            CONSTRAINT [pk_user] PRIMARY KEY ([Id])
        )
    END

-- Tabela de ligação entre usuários e grupos
IF NOT EXISTS (SELECT * FROM sysobjects WHERE name = 'userGroup' AND xtype = 'U')
    BEGIN
        CREATE TABLE [userGroup] (
            [UserId] UNIQUEIDENTIFIER NOT NULL,
            [GroupId] UNIQUEIDENTIFIER NOT NULL
        )
    END

-- Categorias dos eventos
IF NOT EXISTS (SELECT * FROM sysobjects WHERE name = 'category' AND xtype = 'U')
    BEGIN
        CREATE TABLE [category] (
            [Id] UNIQUEIDENTIFIER NOT NULL,
            [Name] VARCHAR(30) NOT NULL,
            [CreatedAt] DATETIME DEFAULT GETDATE(),
            CONSTRAINT [pk_category] PRIMARY KEY ([Id])
        )
    END

-- Eventos com referência para categoria e organizador
IF NOT EXISTS (SELECT * FROM sysobjects WHERE name = 'event' AND xtype = 'U')
    BEGIN
        CREATE TABLE [event] (
            [Id] UNIQUEIDENTIFIER NOT NULL,
            [Title] VARCHAR(80) NOT NULL,
            [Description] VARCHAR(200),
            [CategoryId] UNIQUEIDENTIFIER NOT NULL,
            [CreatedAt] DATETIME DEFAULT GETDATE(),
            [EventDate] DATETIME,
            [OrganizerId] UNIQUEIDENTIFIER NOT NULL,
            [Certificate] BIT DEFAULT 0,
            [Link] VARCHAR(255),
            CONSTRAINT [pk_event] PRIMARY KEY ([Id])
        )
    END
O comando USE [events] troca o banco ativo sem exigir uma nova conexão. Claro, isso só funciona se o usuário que executa a query tiver permissão nos dois bancos.
Do contrário, crie uma nova conexão direto com o banco events, informando as credenciais de um usuário válido. Nesse caso, siga os mesmos passos da seção de conexão.
Em ambientes de produção, na prática, o SQL Server costuma separar permissões por banco. Portanto, o USE é mais comum em ambientes locais de estudo.
Boas práticas nos scripts
O script segue três características que valem para qualquer projeto de SQL Server na prática:
- Verificar se o objeto que será criado já existe.
- Escrever as palavras reservadas das queries sempre em letras maiúsculas.
- Declarar nomes de bancos, tabelas e colunas sempre entre colchetes.
A terceira regra, aliás, tem um motivo técnico. Nomes como user e group são palavras reservadas do T-SQL, e os colchetes permitem usá-los como identificadores sem erro.
Outro detalhe é a consulta à sysobjects, uma visão de compatibilidade herdada do SQL Server 2000. A Microsoft recomenda trocá-la pelo catálogo sys.objects em novos projetos, porque ela será removida em uma versão futura.
Como declarar as colunas
O comando CREATE TABLE recebe, dentro dos parênteses, as colunas da tabela, uma por linha. Cada coluna segue o padrão [Name] TYPE(SIZE) DEFINITION.
Primeiro vem o nome entre colchetes, depois o tipo com o tamanho entre parênteses. Por último, você define NOT NULL quando o campo é obrigatório, ou deixa em branco para aceitar valores nulos.
A documentação do CREATE TABLE recomenda declarar explicitamente NULL ou NOT NULL. Afinal, configurações da sessão podem alterar a nulidade padrão de uma coluna.
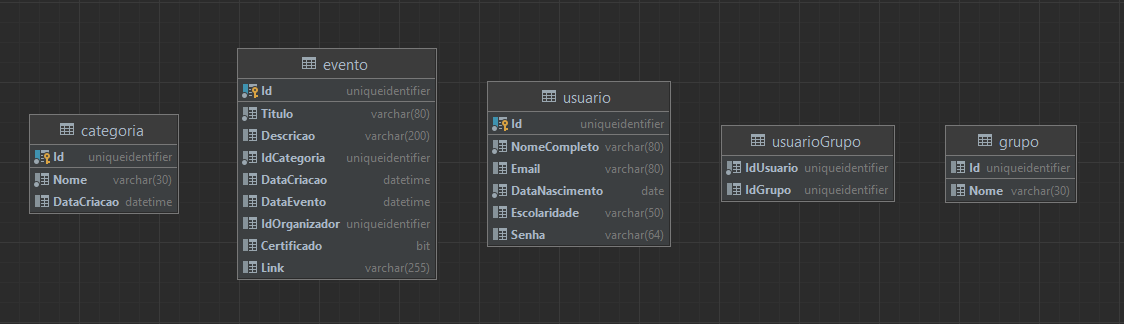
O banco gerado, ainda sem relacionamentos, fica assim:
Foreign keys no SQL Server na prática
As foreign keys, ou chaves estrangeiras, ligam tabelas por meio de colunas que representam um relacionamento. A tabela userGroup é um bom exemplo disso.
Esse tipo de tabela, chamada de tabela de ligação, guarda o Id de um usuário e o Id de um grupo. Com isso, você descobre quais usuários pertencem a um grupo e vice-versa.
Além disso, as foreign keys garantem que um usuário só seja ligado a um grupo existente. Da mesma forma, um evento só nasce com uma categoria e um organizador que já existam.
O trecho abaixo cria esses relacionamentos:
USE [events]
GO

-- Usuário da tabela de ligação precisa existir
IF NOT EXISTS (SELECT * FROM sys.objects o WHERE o.object_id = object_id(N'[dbo].[fk_userGroup_user]'))
    BEGIN
        ALTER TABLE [dbo].[userGroup]
            ADD CONSTRAINT [fk_userGroup_user] FOREIGN KEY ([UserId])
                REFERENCES [dbo].[user] ([Id]);
    END

-- Grupo da tabela de ligação precisa existir
IF NOT EXISTS (SELECT * FROM sys.objects o WHERE o.object_id = object_id(N'[dbo].[fk_userGroup_group]'))
    BEGIN
        ALTER TABLE [dbo].[userGroup]
            ADD CONSTRAINT [fk_userGroup_group] FOREIGN KEY ([GroupId])
                REFERENCES [dbo].[group] ([Id]);
    END

-- Evento precisa de uma categoria existente
IF NOT EXISTS (SELECT * FROM sys.objects o WHERE o.object_id = object_id(N'[dbo].[fk_event_category]'))
    BEGIN
        ALTER TABLE [dbo].[event]
            ADD CONSTRAINT [fk_event_category] FOREIGN KEY ([CategoryId])
                REFERENCES [dbo].[category] ([Id]);
    END

-- Evento precisa de um organizador existente
IF NOT EXISTS (SELECT * FROM sys.objects o WHERE o.object_id = object_id(N'[dbo].[fk_event_user]'))
    BEGIN
        ALTER TABLE [dbo].[event]
            ADD CONSTRAINT [fk_event_user] FOREIGN KEY ([OrganizerId])
                REFERENCES [dbo].[user] ([Id]);
    END
Cada bloco verifica, pela visão sys.objects, se a constraint já existe. Só então o ALTER TABLE adiciona a chave estrangeira apontando para a chave primária da outra tabela.
Esse padrão de verificação torna o script idempotente, ou seja, você pode executá-lo várias vezes no SQL Server sem erro, o que ajuda muito na prática.
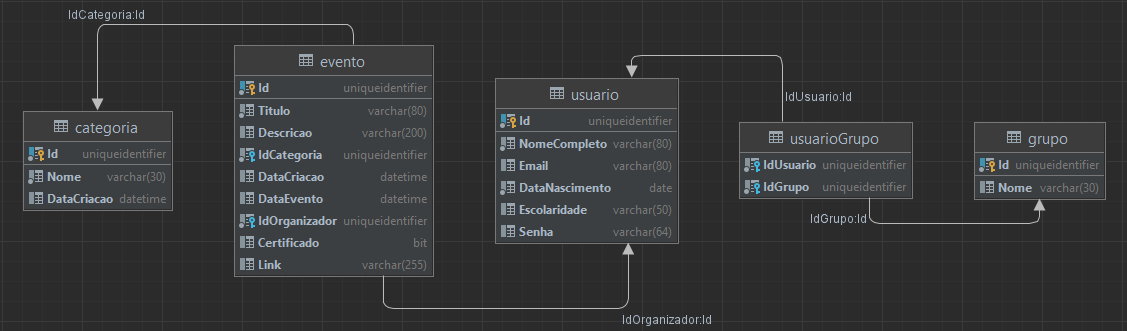
Pronto, os relacionamentos entre as tabelas estão definidos, como mostra o diagrama:
Inserindo registros no SQL Server na prática
Com o banco construído, chegou a hora de populá-lo. Então, crie um registro nas tabelas de categoria, grupo e usuário:
BEGIN TRANSACTION
    INSERT INTO [category] VALUES (
        NEWID(),
        'Lecture',
        GETDATE()
    )

    INSERT INTO [group] VALUES (
        NEWID(),
        'Speaker'
    )

    INSERT INTO [user] VALUES (
        NEWID(),
        'Brewerton Santos',
        'mail@mail.com',
        '2022-01-20 20:00:47.093',
        'Undergraduate (in progress)',
        '1a2b3C%'
    )
ROLLBACK
O comando INSERT INTO [table] VALUES () funciona também sem a transação. Porém, fechar o bloco com ROLLBACK permite executar o comando sem salvar nada.
Assim, você confirma na prática que o script roda no SQL Server sem erros. Quando tiver certeza do resultado, troque o ROLLBACK por COMMIT para gravar as alterações no banco.
A função NEWID() gera um GUID para as colunas do tipo UNIQUEIDENTIFIER. Isso é necessário porque, ao contrário das colunas IDENTITY, o SQL Server não gera esses valores sozinho.
Dois cuidados extras valem a pena. Primeiro, a documentação do INSERT mostra que listar as colunas, como em INSERT INTO [group] ([Id], [Name]), deixa o script imune a mudanças na ordem das colunas.
Segundo, a senha aparece em texto puro apenas para fins didáticos. Em um sistema real, grave somente o hash da senha, nunca o valor original.
Para continuar, você precisa dos identificadores gerados nos registros anteriores. Por isso, o próximo passo é aprender o SELECT.
Lendo registros com SELECT no SQL Server na prática
O comando SELECT consulta as informações gravadas no banco. É com ele que você descobre o Id da categoria, do grupo e do usuário, praticando SQL Server na prática com dados reais.
A consulta mais simples fica assim:
SELECT
    *
FROM [events].[dbo].[category]
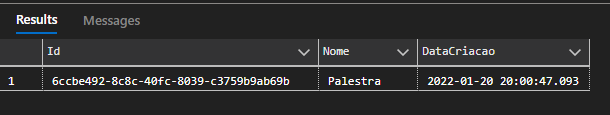
O asterisco indica que você quer todas as colunas da tabela. Neste contexto, isso não é problema, porque existe apenas um registro.
Em um cenário com muitos registros, entretanto, é necessário filtrar a consulta. Assim, você reduz o número de linhas e colunas retornadas, o que na prática alivia o SQL Server e a rede.
Limitando o resultado com TOP
Agora, consulte apenas a primeira linha da tabela de grupos para ver uma busca mais específica:
SELECT TOP (1)
    [Id]
FROM [events].[dbo].[group]
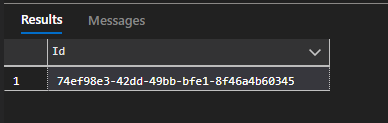
O TOP (1) limita o retorno ao primeiro registro encontrado. Além disso, a consulta pede somente a coluna Id, que é o dado necessário para os próximos passos.
Como só existe um grupo, o retorno é o Id do grupo de palestrantes. Em tabelas maiores, porém, combine o TOP com um ORDER BY, que é a única forma de prever quais linhas ele retorna.
Filtrando com WHERE e LIKE
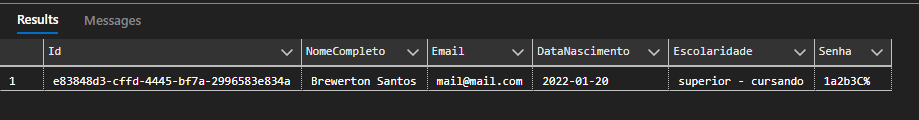
Para consultar o usuário, filtre pelo sobrenome Santos. Como existe apenas um registro com esse sobrenome, a consulta traz o usuário cadastrado anteriormente:
SELECT
    [Id],
    [FullName],
    [Email],
    [BirthDate],
    [Education],
    [Password]
FROM [events].[dbo].[user]
    WHERE [FullName] LIKE '%Santos%'
O operador LIKE, seguido de um texto entre aspas simples e sinais de porcentagem, procura esse trecho em qualquer posição da coluna. Ou seja, o % representa qualquer sequência de caracteres.
Concluindo os registros no SQL Server na prática
Com os Ids do grupo, da categoria e do usuário em mãos, você pode continuar a popular as tabelas. Primeiro, associe o usuário ao grupo:
BEGIN TRANSACTION
    INSERT INTO [userGroup] VALUES (
        'e83848d3-cffd-4445-bf7a-2996583e834a',
        '74ef98e3-42dd-49bb-bfe1-8f46a4b60345'
    )
ROLLBACK
O primeiro identificador é o Id do usuário, e o segundo é o Id do grupo de palestrantes. Lembre-se de trocar esses valores pelos GUIDs gerados no seu banco.
Agora, confira se os dados ficaram corretos com uma consulta um pouco mais avançada. Com o INNER JOIN, você junta tabelas diferentes e exibe o resultado em uma única linha:
SELECT
    [user].[Id] AS UserId,
    [user].[FullName],
    [user].[Email],
    [group].[Id] AS GroupId,
    [group].[Name] AS GroupName
FROM [user]
INNER JOIN [userGroup] ON [userGroup].[UserId] = [user].[Id]
INNER JOIN [group] ON [group].[Id] = [userGroup].[GroupId]
    WHERE [FullName] LIKE '%Santos%'
A consulta lista as colunas desejadas e usa o operador AS para renomear as colunas exibidas. Em seguida, cada INNER JOIN acrescenta uma tabela usando o relacionamento definido pelas chaves estrangeiras.
Note que a condição do primeiro join compara [userGroup].[UserId] com [user].[Id]. Sem qualificar a coluna com o nome da tabela, a junção ficaria ambígua e poderia trazer linhas erradas.
Por fim, o WHERE restringe o resultado aos registros que têm Santos no nome.
Esse tipo de junção é um dos recursos mais usados no SQL Server na prática, porque quase toda tela de sistema combina dados de várias tabelas.
Considerações finais sobre o SQL Server na prática
Neste artigo, você passou pela conexão e pela criação do banco, pela estrutura das tabelas e pelas chaves estrangeiras. Depois, inseriu e consultou dados, sempre com transações para testar antes de gravar.
Na próxima parte do SQL Server na prática, você aprende consultas avançadas, views, edição de registros e alterações de tabelas. Também verá como remover dados com segurança.
Para estudar cada comando com mais detalhes, o curso Fundamentos do SQL Server, do balta.io, aprofunda os conceitos apresentados aqui.
FAQ
Preciso instalar o SQL Server no Windows para seguir o artigo?
Não, porque o SQL Server roda em containers Docker no Windows, no Linux e no macOS. O artigo usa um container rodando através do WSL.
Por que usar colchetes nos nomes de tabelas e colunas?
Os colchetes delimitam identificadores e permitem usar palavras reservadas como user e group. Além disso, deixam o script mais legível e padronizado.
Qual a diferença entre ROLLBACK e COMMIT?
O ROLLBACK desfaz todas as alterações feitas desde o BEGIN TRANSACTION. Já o COMMIT torna as alterações permanentes no banco.
O Azure Data Studio ainda pode ser usado?
Ele foi aposentado em 28 de fevereiro de 2026 e não recebe mais atualizações. A Microsoft recomenda migrar para o VS Code com a extensão MSSQL.
Por que usar UNIQUEIDENTIFIER em vez de INT nas chaves primárias?
O GUID é único entre bancos e servidores, o que facilita integrações e replicação. Em troca, ele ocupa 16 bytes e não gera valores sequenciais com o NEWID.