Memória de agentes: componentes e dreaming no Claude
A memória de agentes é o conhecimento que um agente de IA ganha com a experiência e guarda entre sessões. Em novembro de 2026, a Anthropic publicou um estudo de pesquisa que detalha como o Claude escreve, organiza e corrige essa memória.
A tese do estudo é simples: notas escritas durante o trabalho são úteis, mas nem sempre estão certas. Por isso, a Anthropic combina notas em tempo real com um processo offline chamado dreaming.
O que é memória de agentes
Para a Anthropic, a memória do agente é o que o Claude aprende com usuários e tarefas. Além disso, esse conhecimento sobrevive ao fim da sessão, porque fica salvo como contexto para leitura futura.
A definição exclui três coisas que costumam se misturar com o tema. Primeiro, ela exclui mudanças nos pesos do modelo, que acontecem no treinamento.
Em seguida, ela exclui o aprendizado em contexto, que vale só dentro de uma conversa. Por fim, ela exclui a compactação, em que o Claude resume turnos antigos para seguir em uma nova janela.
Na prática, portanto, a memória de agentes costuma ser uma pasta de arquivos que o agente escreve e relê. Um formato comum é um conjunto de notas em markdown.
A Anthropic faz um paralelo com o cérebro humano. Nós registramos experiências o tempo todo, mas boa parte da consolidação acontece durante o sono.
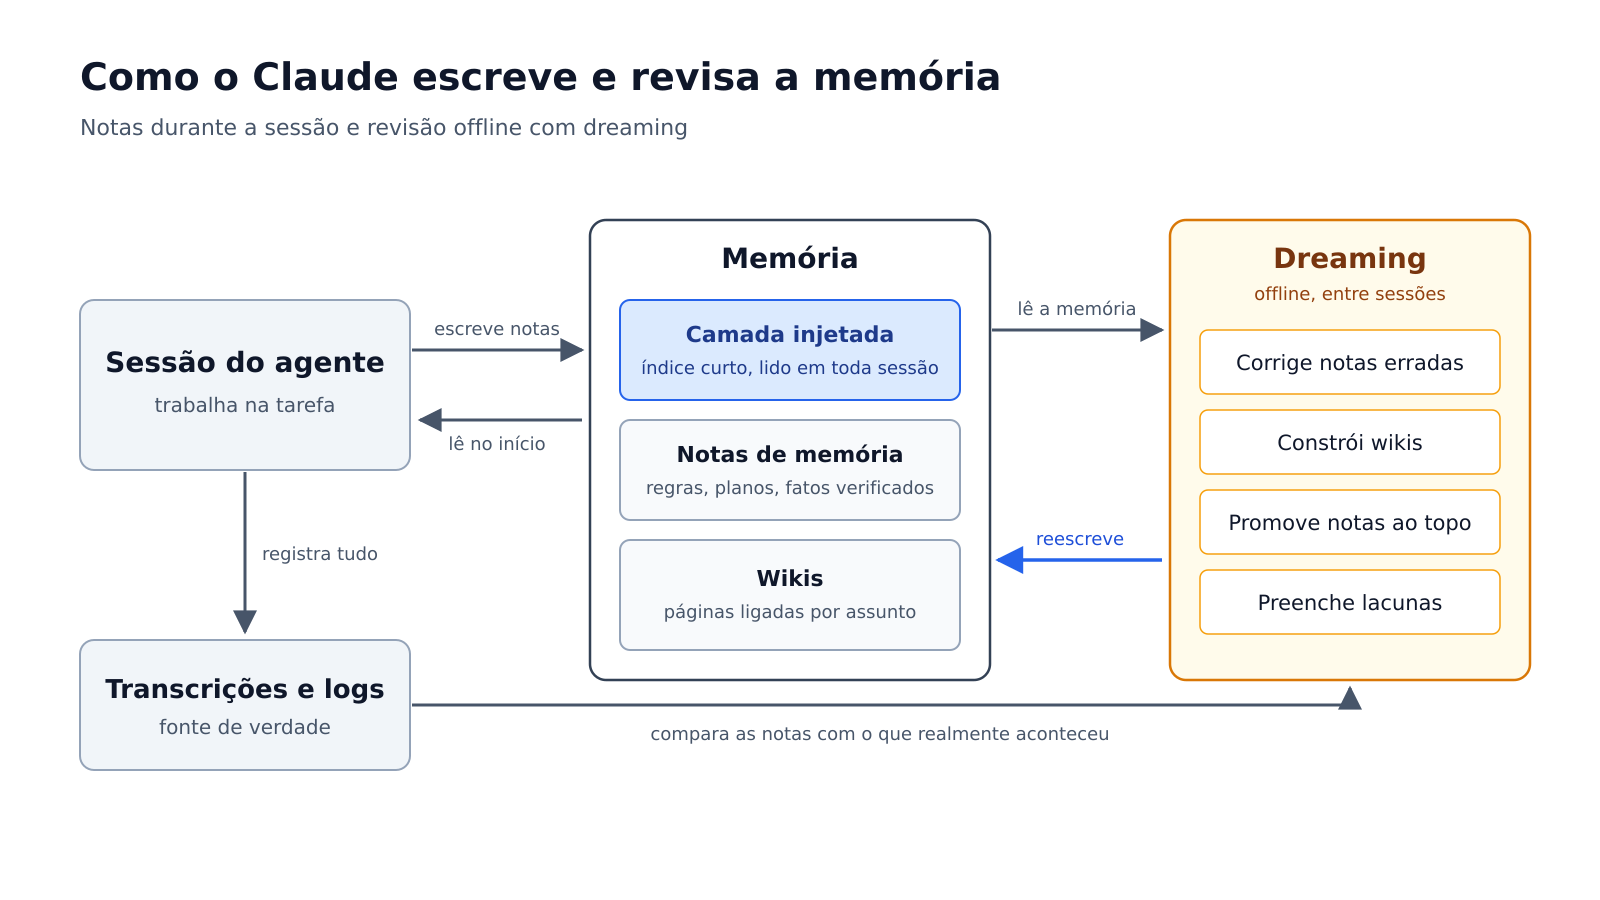
Da mesma forma, o agente registra o trabalho em logs e transcrições. Depois, um processo separado revisa esse material e melhora a memória do agente.
Esse processo é o dreaming. A ideia vem do sleep-time compute, proposto por pesquisadores da Letta e da UC Berkeley para aproveitar o tempo ocioso entre interações.
Por que a memória de agentes é uma previsão
Toda nota salva carrega uma aposta sobre o futuro. Ou seja, quando o agente escreve uma regra na memória, ele prevê que aquele padrão vai voltar.
Da mesma forma, um fato verificado é uma aposta de que a próxima sessão vai confiar nele sem checar. Segundo a Anthropic, o Claude ficou muito melhor nesse tipo de previsão.
O ciclo de aprendizado no CL-Bench
Para medir isso, a equipe usou o Continual Learning Bench 1.0. Na tarefa escolhida, o Claude responde perguntas consultando um banco de dados.
Depois de cada resposta, o Claude recebe a solução correta e pode escrever uma nota. Assim, a memória do agente vira um ciclo: registrar a falha, levantar hipóteses, testar e criar uma regra.
O teste rodou no Claude Managed Agents. Cada pergunta começava em uma sessão nova, e só o diretório de memória passava de uma sessão para a outra.
Como cada modelo evoluiu
O Claude Sonnet 4.6 parou na etapa das hipóteses. Por isso, sua memória tinha arquivos espalhados, cheios de palpites que nunca foram testados.
Já o Claude Opus 4.7 juntou as notas em um único documento de referência. Além disso, ele marcava quais fatos tinha confirmado e quais ainda eram dúvidas.
O Claude Sonnet 5 deu mais um passo. Ele marcava cada resposta como confirmada após a correção e registrava uma retificação quando errava.
O Claude Opus 5 foi o primeiro a fechar o ciclo. Suas entradas traziam a regra, a prova de que ela era verdadeira e alertas sobre armadilhas.
O Claude Opus 5.5 e o Claude Sonnet 5.5 também fecharam o ciclo. Com memória, os dois empataram com o Opus 5, mas tiveram desempenho um pouco maior sem memória.
Saliência: o que guardar na memória de agentes
Saber o que vale a pena lembrar é tão importante quanto lembrar. A Anthropic testou esse julgamento de saliência com o jogo Pokémon Red.
Cada modelo recebia uma pasta de memória para ler e escrever durante a partida. Então, a equipe comparou o Claude Sonnet 3.7 e o Claude Fable 5 perto do passo 10 mil.
O Sonnet 3.7 tratou tudo como importante na memória do agente. Ele criou 413 arquivos em 225 pastas e conquistou apenas uma insígnia.
O Fable 5, por outro lado, escreveu nove arquivos em duas pastas, além de um global.md. Com uma memória muito menor, ele conquistou quatro insígnias.
Por que guardar menos funcionou melhor
O estado do jogo muda o tempo todo. Dessa forma, o registro detalhado do Sonnet 3.7 envelhecia rápido e consumia esforço que deveria ir para o jogo.
Em um trecho, por exemplo, ele passou 17 passos criando seis arquivos e apagando nove. Nesse intervalo, não fez nenhuma ação no jogo.
O Fable 5 seguiu outra lógica. Ele não salvava o que a tela mostra a cada turno, como dinheiro ou posição no mapa.
Em vez disso, ele guardava estratégias, planos e regras testadas, que só existem se o agente as descobre. A estrutura ficou assim:
memory/
├── global.md        # current goal, gym plan, memory rules
├── locations/       # route navigation plans
└── gameplay/        # tested rules about game mechanics
O global.md funcionava como um painel, com o objetivo atual e as regras de uso da memória. Já o Claude Opus 5.5 manteve uma pasta igualmente pequena e terminou o jogo.
Como orientar o Claude a escrever memória
Uma das conclusões mais úteis do estudo é sobre instruções. Segundo a Anthropic, vale explicar para que a memória serve, mas não como usá-la.
No CL-Bench, a equipe apenas avisou que havia uma pasta de memória. Para o Opus 4.7 e o Opus 5, isso bastou para um ganho claro.
Em seguida, a equipe testou regras específicas sobre o que salvar. Com a regra de registrar só falhas, os dois modelos perderam boa parte do ganho.
Em outras palavras, regras fixas atrapalham a memória de agentes mais capazes. Para eles, decidir sozinhos o que é saliente funcionou melhor.
Com modelos antigos, no entanto, a orientação ajudou bastante. O Sonnet 4.6 muitas vezes não lia a própria memória nem testava hipóteses.
Quando a equipe pediu essas duas ações, a pontuação dele quase dobrou. O Sonnet 5, por sua vez, lê a memória sozinho em 9 de cada 10 respostas.
Por isso, com modelos de fronteira, a Anthropic dá uma orientação simples. O agente cria notas quando a pessoa pede ou quando algo claramente merece registro.
Para levar essas ideias para produção, vale ver como montar automações confiáveis com Claude Managed Agents.
O que é dreaming
Dreaming é o processo em que o Claude revisa sessões anteriores, fora da tarefa, para organizar a memória. A Anthropic lançou o recurso em maio de 2026, em prévia de pesquisa no Claude Managed Agents.
O estudo mostra cinco usos para o dreaming na memória do agente. Ele corrige notas, cria representações, promove notas, foca em um objetivo e preenche lacunas.
Dreaming corrige notas erradas
Como o Claude escreve o que parece importante no momento, uma nota pode nascer errada. Mesmo assim, uma sessão futura vai confiar nela.
O exemplo vem de novo do Pokémon. Na caverna Mt. Moon, perto da entrada, existe um degrau de mão única que devolve o jogador à rota anterior.
O Claude anotou que o Centro Pokémon ficava no lado leste da montanha. Então, ao sair do prédio, marcou a travessia como concluída.
Poucos passos depois, ele caiu pelo degrau e voltou à rota anterior. Como a ferramenta de navegação não mostrava a queda, ele achou que tinha andado demais.
A equipe então rodou o dreaming sobre essa pasta. O Claude comparou a nota com a transcrição, encontrou o erro e reescreveu a nota.
Com a nota corrigida, ele voltou à caverna e chegou a Cerulean City. Com a nota original, caiu três vezes no mesmo ponto e nunca passou da montanha.
A lição é clara: a transcrição funciona como fonte de verdade. Portanto, o dreaming valida a memória de agentes contra o que realmente aconteceu.
Dreaming constrói wikis
O dreaming também cria representações para navegar pela memória. A principal é a wiki, um conjunto de páginas que o Claude escreve e mantém.
Cada página reúne o que o agente sabe sobre um assunto e aponta para outras notas da memória. Assim, os links formam um mapa para encontrar a informação certa.
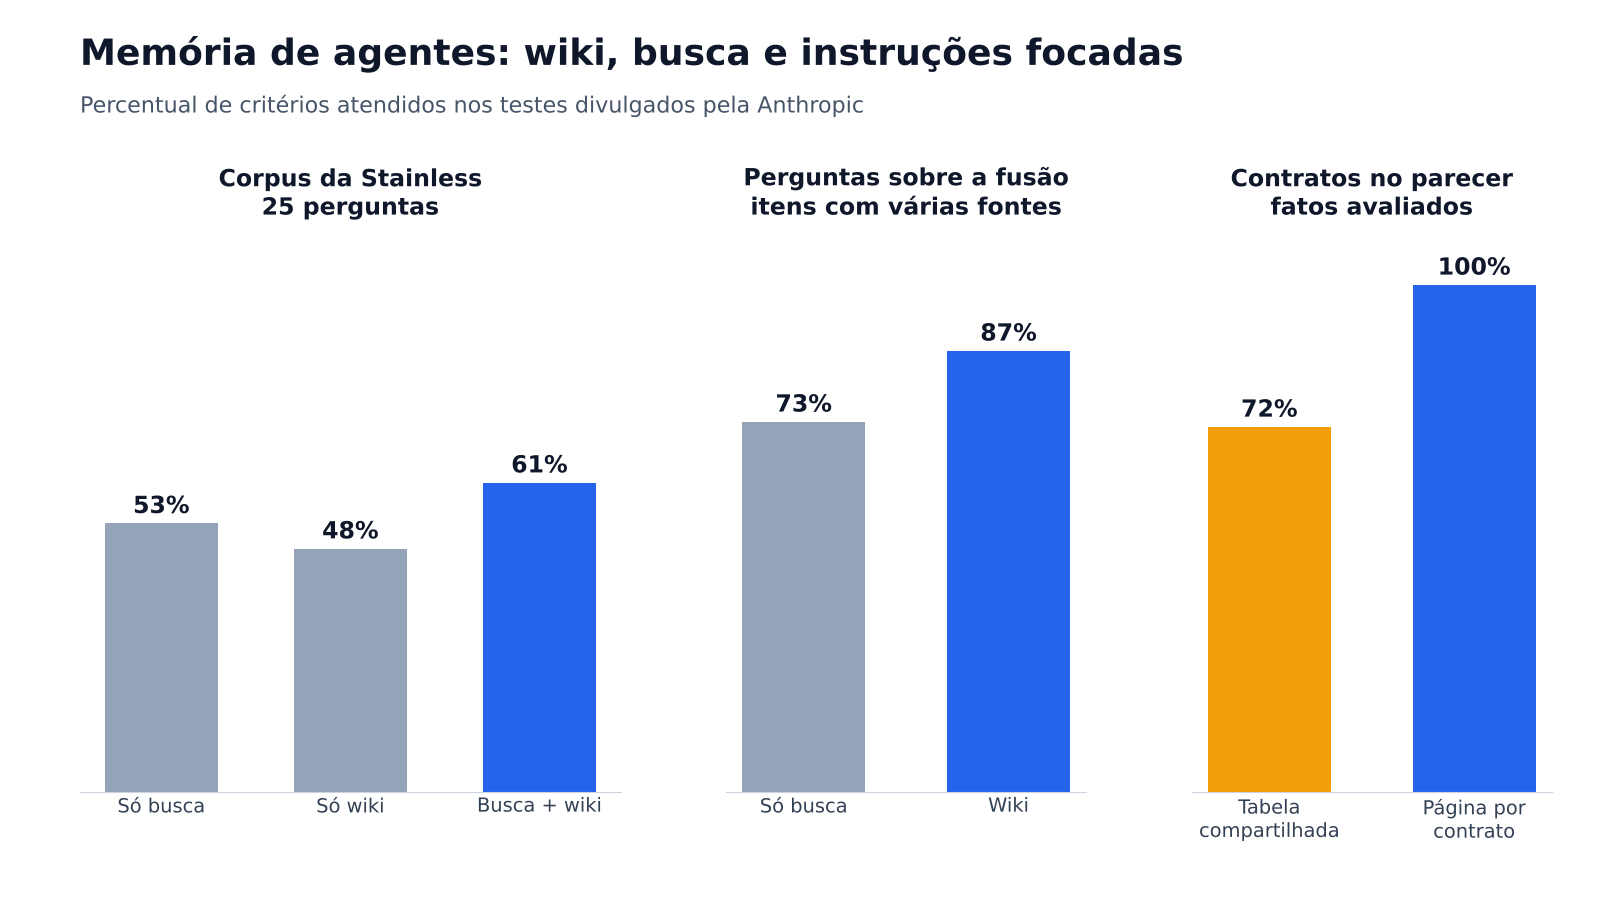
Para testar, a Anthropic usou cerca de 350 mil arquivos internos da Stainless, com perto de 420 milhões de tokens. A equipe criou 25 perguntas sobre esse material.
Ao longo de 128 sessões, agentes Opus 5 escreveram, corrigiram e uniram páginas da wiki. Cada sessão continuava o trabalho da anterior por meio de um log compartilhado.
Com isso, a nota usando só a wiki subiu de 13% para 48%. No começo, a wiki parece o conhecimento de um funcionário novo; depois, de alguém experiente.
O melhor resultado, no entanto, veio da wiki somada à busca. Com as duas, a nota subiu de 54% para 61%, contra 53% só com busca.
Além disso, a combinação economizou cerca de 20 mil tokens por pergunta. Esse ganho mostra que a memória do agente e a busca se complementam.
Quando a wiki ajuda e quando atrapalha
A Anthropic também quis saber quando a wiki compensa. Para isso, usou documentos sobre uma fusão e o benchmark Harvey LAB, que avalia pareceres jurídicos.
Em 24 perguntas sobre a fusão, mais da metade exigia cruzar vários documentos. Nesses itens, o Claude acertou 87% com a wiki, contra 73% só com busca.
Em outra tarefa, porém, quase todos os critérios estavam em um único documento. Nesse caso, a busca de texto resolvia e a wiki não trouxe ganho claro.
Houve ainda um caso em que a wiki ficou maior que os próprios documentos. A Anthropic compara isso ao mapa de Borges, tão grande quanto o império que representa.
Portanto, a wiki rende mais quando a resposta junta várias fontes. Quando a informação está em um lugar só, a busca direta costuma bastar.
Hierarquia da memória de agentes e injeção de contexto
O dreaming também pode levar notas para o topo da hierarquia da memória. Nesse caso, o harness do agente carrega essas notas no início de cada sessão.
Essa injeção de contexto exige cuidado. Afinal, notas injetadas consomem tokens, e uma nota errada passa a acompanhar todas as sessões.
Além disso, carregar uma nota não garante que o Claude vai segui-la. A documentação do Claude Code avisa que instruções longas reduzem a aderência.
Por isso, a camada do topo da memória de agentes precisa continuar pequena. O dreaming desce detalhes para camadas inferiores e deixa apenas links no topo.
A memória automática do Claude Code segue a mesma lógica. Ela carrega só as primeiras 200 linhas ou 25 KB do MEMORY.md, que funciona como índice.
Dreaming focado em um objetivo
O dreaming também pode direcionar como a memória cresce. Um assistente como o Claude Duet, por exemplo, ganha com memórias organizadas em torno da pessoa.
Para mostrar isso, a Anthropic usou uma tarefa do LAB que simula uma aquisição com vários contratos. O parecer é avaliado pela descrição correta dos termos.
Na primeira versão, as instruções não diziam que os termos eram o ponto central. Assim, vários agentes escreveram na mesma tabela e sobrescreveram o trabalho uns dos outros.
O parecer trouxe só 41 dos 57 fatos avaliados, ou 72%. Então a equipe deixou o Claude analisar as falhas e reescrever as próprias instruções.
Nas novas instruções, cada contrato ganhou uma página própria, com os termos citados palavra por palavra. Dessa vez, o parecer cumpriu 100% dos critérios.
O dreaming também preenche lacunas que uma sessão sozinha não enxerga. Em uma wiki, ele corrigiu nove links quebrados e criou três páginas novas, incluindo um índice.
Lições práticas para projetar memória de agentes
O estudo não traz uma receita fechada, mas deixa recomendações claras. Primeiro, explique para que a memória do agente serve e confie no julgamento dos modelos recentes.
Em segundo lugar, guarde só o que o ambiente não entrega de graça. Estratégias e regras testadas valem mais do que estado visível a cada passo.
Além disso, revise a memória contra as transcrições. Como mostrou o caso da caverna, uma nota errada pode travar o agente por muito tempo.
Também escolha a representação pela tarefa. Wikis ajudam quando a resposta cruza documentos, enquanto a busca resolve quando a informação está em um lugar só.
Por fim, mantenha pequena a camada injetada em toda sessão. Um índice curto, com links para o resto, tende a funcionar melhor.
Para quem usa a API, a documentação da ferramenta de memória mostra como o Claude lê e escreve arquivos.
Questões em aberto na memória de agentes
A própria Anthropic reconhece que há perguntas sem resposta. A primeira é quando o agente deve criar memória.
Escrever durante a tarefa captura a saliência na origem e deixa a nota disponível na hora. No entanto, isso tira a atenção do agente da tarefa principal.
O dreaming, por outro lado, leva esse trabalho para segundo plano. Em compensação, o resultado pode não estar disponível imediatamente.
A segunda pergunta é como manter a memória de agentes atualizada. O dreaming corrige erros, mas consome computação, e revisar tudo o tempo todo pode não ser viável.
Uma alternativa é focar a revisão no que muda com frequência. Outra é ajustar a cadência pela frequência de acesso de cada nota.
Também faz sentido tratar a busca em transcrições como base da memória. Nesse caso, wikis complementam a busca, desde que o Claude evite que acumulem erros.
Conclusão sobre memória de agentes
O estudo mostra que a memória de agentes tem duas metades. De um lado, o Claude escreve notas durante o trabalho, apostando no que será útil.
Do outro, o dreaming olha para trás e compara as notas com o que aconteceu. Assim, erros de previsão deixam de passar para as próximas sessões.
Os números reforçam essa visão. Modelos novos fecham o ciclo sozinhos, guardam menos e melhor, e ganham com wikis quando a tarefa cruza fontes.
Em resumo, nenhum modelo sabe o que vem nos próximos turnos. Por isso, uma boa memória do agente une julgamento na tarefa e revisão depois dela.
FAQ
O que é memória de agentes?
É o conhecimento que um agente de IA ganha com a experiência e guarda entre sessões, como arquivos que ele pode reler. Não inclui mudanças nos pesos, aprendizado em contexto nem compactação.
O que é dreaming no Claude?
É um processo offline em que o Claude revisa sessões anteriores para corrigir notas, criar representações e reorganizar a memória. A Anthropic lançou o recurso em prévia de pesquisa no Claude Managed Agents.
Devo dar regras detalhadas sobre o que o agente deve salvar?
Para modelos recentes, a Anthropic indica explicar para que a memória serve e deixar o julgamento com o modelo. Regras fixas, como salvar só falhas, reduziram o ganho do Opus 5 e do Opus 4.7.
Uma wiki sempre melhora as respostas do agente?
Não. A wiki ajudou quando a resposta exigia cruzar vários documentos, mas não trouxe ganho claro quando a informação estava em um único documento.
Por que manter pequena a memória carregada em toda sessão?
Porque ela consome tokens, pode espalhar uma nota errada para todas as sessões e reduz a aderência quando fica longa. Um índice curto com links tende a funcionar melhor.