
Claude Managed Agents: como criar automações confiáveis

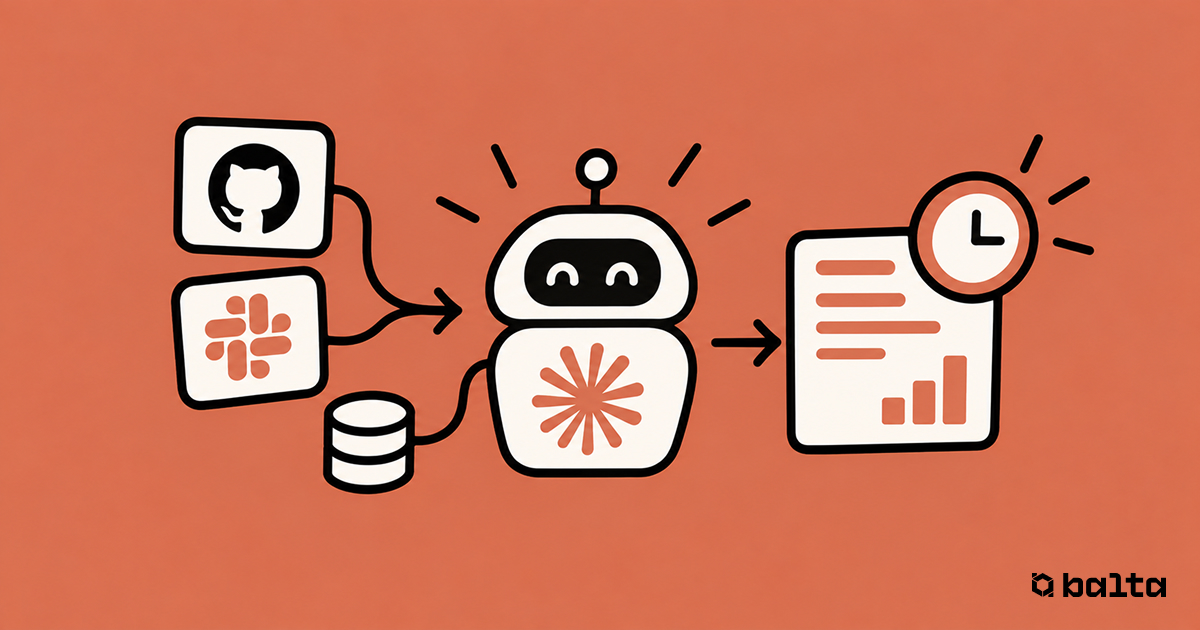
O Claude Managed Agents permite rodar um agente de IA em um agendamento, ler fontes como Slack e GitHub e publicar apenas o que importa para você. Neste artigo, vamos destrinchar a implementação de referência que a Anthropic publicou e entender cada decisão que torna essa automação confiável.
O que é o Claude Managed Agents
O Claude Managed Agents é um conjunto de APIs da Anthropic para construir e executar agentes hospedados na nuvem. Em vez de montar o loop do agente, o sandbox e o runtime por conta própria, você descreve o que o agente faz e a plataforma cuida da infraestrutura.
O serviço ainda está em beta, e todas as requisições exigem o cabeçalho managed-agents-2026-04-01. Além disso, alguns recursos, como memória e orquestração multiagente, podem exigir acesso antecipado conforme a sua conta.
Na prática, o Claude Managed Agents gira em torno de quatro conceitos. O agente define modelo, prompt e ferramentas, enquanto o ambiente define onde a sessão roda.
A sessão é uma execução concreta do agente. Por fim, os eventos são as mensagens trocadas entre a sua aplicação e essa sessão.
Esse desenho combina muito bem com automações em segundo plano. Afinal, um agente que roda às 7h32 de cada dia útil não precisa de nenhuma máquina sua ligada.
Por que automações com agentes falham
A IA acelerou o volume de informação que chega até nós, e acompanhar tudo ficou mais difícil. Por isso, times da própria Anthropic usam automações simples que leem contexto em segundo plano e avisam o que realmente precisa de atenção.
O problema é que construir uma automação eficaz dá trabalho. Um agente pode perder acesso a uma fonte sem ninguém perceber, ou então ignorar as preferências de quem lê o resumo.
Além disso, o agente pode repetir itens, esquecer outros ou chamar a manhã de hoje de "ontem".
A implementação de referência do Claude Managed Agents ataca exatamente esses pontos.
Arquitetura de uma automação com Claude Managed Agents
O exemplo da Anthropic se chama Daily brief e possui seis componentes. Primeiro vêm as fontes, que formam a lista nomeada de lugares que o agente lê.
Em seguida vem o destino, que é o único lugar onde o agente pode escrever. Depois temos o agente em si, com modelo, ferramentas e passos de execução descritos no agent.md.
O agendamento usa uma expressão cron, e a memória guarda tanto as suas preferências quanto o estado do agente. Por fim, os guardrails limitam o acesso a leitura onde o agente só lê e impõem um teto de gasto por execução.
Todos esses recursos ficam em arquivos de configuração versionáveis. Dessa forma, o projeto inteiro cabe em uma pasta simples:
daily-brief/
├── agent.md                        # modelo, ferramentas e instruções
├── deployment.md                   # agenda, fuso, orçamento e mensagem inicial
├── environment.yaml                # allowlist de rede
├── memory_store_preferences.yaml   # preferências do leitor
├── memory_store_state.yaml         # bookmarks, ledger, notas e registros
├── vault.yaml                      # cofre de credenciais
├── claude-lock.json                # IDs gerados pelo ant apply
└── slack/manifest.yaml             # app do bot no Slack
O comando ant apply, da CLI ant, lê esses arquivos e cria os recursos no seu workspace da Claude API. Em seguida, ele grava os IDs gerados no claude-lock.json, o que facilita reaplicar a configuração depois.
Fontes de dados e credenciais no Claude Managed Agents
O agente lê duas fontes por padrão: canais do Slack e pull requests do GitHub. Os canais e repositórios ficam listados no arquivo de preferências, e você pode estender o modelo para outras fontes.
No Claude Managed Agents, essas fontes funcionam apenas para leitura. O agente chega até elas por MCP ou HTTPS, sempre com credenciais vindas de um cofre.
Credenciais próprias e com escopo reduzido
No Claude Managed Agents, as credenciais moram em vaults. O agente referencia cada credencial, mas o valor real nunca entra no sandbox onde o código do Claude roda.
Para servidores MCP, como o do GitHub, o agente chama as ferramentas por meio de um proxy externo ao sandbox. Esse proxy encontra no cofre a credencial cuja URL corresponde à do servidor.
Já no caso do Slack, o agente usa curl pela ferramenta bash dentro do sandbox. Nesse caso, o sandbox guarda só um marcador opaco, $SLACK_BOT_TOKEN, e a plataforma troca pelo token real quando a requisição sai rumo a um host permitido.
Você cria o cofre com ant apply vault.yaml e depois adiciona cada credencial pelo SDK de TypeScript:
// ID do cofre, copiado do claude-lock.json
const vaultId = process.env.VAULT_ID!;

await client.beta.vaults.credentials.create(vaultId, {
  display_name: "SLACK_BOT_TOKEN",
  auth: {
    type: "environment_variable",
    secret_name: "SLACK_BOT_TOKEN",
    secret_value: process.env.SLACK_BOT_TOKEN!,
    // o token só pode sair do sandbox rumo ao slack.com
    networking: { type: "limited", allowed_hosts: ["slack.com"] },
    injection_location: { header: true },
  },
});
Por fim, copie o ID do cofre para o campo vault_ids do deployment.md. Assim, cada execução agendada recebe acesso às credenciais certas.
Bookmarks no lugar de janelas fixas
Um erro comum é pedir ao agente que leia "as últimas 24 horas". Uma execução atrasada deixa um buraco, enquanto uma execução adiantada repete itens.
A solução é dar ao agente um bookmark por fonte. Ao fim de cada execução, ele grava no bookmarks.json o timestamp do item mais novo lido em cada fonte.
{
  "slack": "2026-09-14T13:02:11Z",
  "github": "2026-09-14T12:48:03Z"
}
A próxima execução parte desses marcadores, então a janela estica ou encolhe conforme a necessidade. Os bookmarks ficam no memory store state, que a plataforma monta em /mnt/memory/ e preserva entre execuções.
Falha de leitura não significa dia tranquilo
Se um servidor MCP cair ou o token expirar, a execução começa mesmo assim, só que sem as ferramentas daquele servidor. A sessão registra um erro, mas o agente não enxerga nada da fonte e conclui que não houve novidade.
Para evitar esse engano, o agent.md traz três regras. Quando uma fonte falha, o agente mantém o bookmark dela parado, escreve o resumo com as demais fontes e encerra com uma linha avisando o que não conseguiu ler.
Com isso, o leitor sabe que "pull requests indisponíveis nesta execução" é diferente de "nenhum pull request novo".
Destino e confirmação da publicação
O modelo do Claude Managed Agents publica em um único canal do Slack, com um post datado a cada execução. O agente usa a ferramenta bash e o mesmo token do bot que utiliza para leitura.
Nenhuma aprovação humana entra nesse fluxo. A ferramenta bash nativa roda sem pedir aprovação por padrão, e o host slack.com já consta na allowlist do ambiente:
# publica o resumo do dia no canal configurado
curl -s https://slack.com/api/chat.postMessage \
  -H "Authorization: Bearer $SLACK_BOT_TOKEN" \
  -H "Content-Type: application/json; charset=utf-8" \
  -d '{"channel": "C0123456789", "text": "Daily brief, Tue Sep 15 ..."}'
Confirme antes de registrar
Depois de publicar, o agente atualiza o ledger e os bookmarks. Contudo, se esses registros divergirem do que de fato saiu, dois problemas aparecem.
Se o agente registrar um post que nunca chegou, os bookmarks avançam e aqueles itens somem para sempre. Por outro lado, se ele publicar de novo por insegurança, o leitor recebe o mesmo resumo duas vezes.
Por isso, o agente primeiro procura o título de hoje nas mensagens recentes do canal e desiste se a edição já existir. Em seguida, considera o post enviado somente quando o Slack devolve "ok": true junto com o ts da mensagem.
Só então ele atualiza ledger e bookmarks. Quando o resultado fica ambíguo, o agente marca a execução como "maybe posted" e não altera mais nada, então nenhum item se perde.
Cada execução também ganha um registro em runs/<date>.md. O agente marca "posting" antes de publicar e depois troca para "posted", com o ID da mensagem, ou para "maybe posted".
Configurando o agente no Claude Managed Agents
No Claude Managed Agents, um agente é uma configuração versionada com modelo, prompt de sistema e ferramentas. Cada execução segue os passos definidos e termina.
Na implementação de referência, essa configuração mora no agent.md:
---
name: Daily brief
model: claude-sonnet-5-5
mcp_servers:
  - type: url
    name: github
    url: https://api.githubcopilot.com/mcp/
tools:
  - type: agent_toolset_20260401
    configs:
      # o agente não precisa navegar na web
      - name: web_search
        enabled: false
      - name: web_fetch
        enabled: false
  - type: mcp_toolset
    mcp_server_name: github
    default_config:
      permission_policy:
        type: always_allow
---
O frontmatter informa nome, modelo, ferramentas e servidores MCP, enquanto o corpo traz oito passos numerados. Repare que a busca e o fetch da web ficam desligados, já que o agente só precisa das fontes declaradas.
Ferramentas MCP pedem aprovação por padrão, e ninguém estará presente para aprovar às 7h da manhã. Assim, o toolset do GitHub usa always_allow, mas o token do GitHub concede apenas leitura.
Se você ainda está decidindo qual modelo usar, vale entender quando escolher Sonnet ou Opus. Para um resumo diário, o Sonnet costuma oferecer o melhor equilíbrio entre custo e qualidade.
Mantenha o resumo curto
O passo quatro do agent.md empurra o Claude para a brevidade. Um item só ganha uma linha quando o leitor agiria sobre ele hoje ou quando ele muda uma decisão próxima.
Na dúvida, o agente deixa o item de fora, então na maioria dos dias o resumo traz poucos itens. Uma contagem como "12 revisões abertas" também não conta como item, porque o agente deve linkar apenas as revisões bloqueadas.
Um item que já está no ledger e continua aberto aparece como uma linha marcada, por exemplo "ainda aguardando, dia 3". Já um item fechado simplesmente desaparece, sem comentário.
Verifique de novo antes de publicar
O mundo muda enquanto o agente lê as fontes. Por isso, o passo cinco manda o agente checar o status ao vivo de cada item logo antes de publicar.
Se o item foi resolvido nesse intervalo, o agente o descarta. Se mudou, ele corrige a linha, e se não consegue confirmar, remove o item e anota o corte no registro da execução.
A regra parte de uma premissa simples: um "ainda aguardando você" desatualizado custa mais confiança do que dez itens ausentes. Além disso, todo link vem do campo oficial da fonte, como o html_url do pull request, e nunca de uma URL montada à mão.
Agendamento e fuso horário no Claude Managed Agents
No Claude Managed Agents, o agente é só um arquivo de configuração, e quem o executa é um deployment. O deployment nomeia o agente, o ambiente e a primeira mensagem de cada execução, além de guardar agenda, cofre, memória e orçamento.
A cada disparo da agenda, o Claude Managed Agents inicia uma sessão nova do agente. No modelo, o deployment fica no deployment.md:
---
name: Daily brief
agent: ./agent.md
environment_id: ./environment.yaml
schedule:
  type: cron
  # 7h32, de segunda a sexta
  expression: "32 7 * * 1-5"
  timezone: America/Sao_Paulo
vault_ids: [vlt_...]
resources:
  - path: ./memory_store_preferences.yaml
    access: read_only
    instructions: The reader's preferences. Re-read them every run. Never write here.
  - path: ./memory_store_state.yaml
    access: read_write
    instructions: Your state. Bookmarks, ledger, notes, proposals, and run records.
---

Write today's brief.
The reader's time zone is America/Sao_Paulo. Work out every date in that zone.

Follow your run steps in order. Today's edition is titled "Daily brief, <weekday> <month> <day>".
Depois, basta rodar ant apply deployment.md para criar o deployment. Para testar sem esperar a agenda, dispare uma execução manual com ant beta:deployments run --deployment-id <id>.
Calcule datas no seu fuso
Um bug clássico acontece quando o agente chama a manhã de hoje de "ontem". Isso ocorre porque ele calcula datas no fuso do servidor, e não no fuso do leitor.
O campo timezone define quando a execução dispara. Já a segunda linha do corpo diz ao agente qual fuso usar ao interpretar datas, e você precisa das duas coisas juntas.
Memória entre execuções no Claude Managed Agents
No Claude Managed Agents, cada execução começa em um sandbox novo, sem lembrança da anterior. Sem memória, o feedback do leitor não fica, mas uma memória desatualizada também confunde o agente.
Por isso, o modelo mantém dois memory stores montados em /mnt/memory/. O primeiro, preferences, pertence a você e o agente só lê: canais, repositórios, o que deixar de fora, limite de tamanho e destino.
O segundo, state, pertence ao agente, que lê e escreve nele. Lá ficam os bookmarks, o ledger, um registro por execução, propostas de mudança nas suas preferências e notas sobre o comportamento de cada fonte.
O ant apply deployment.md cria o store de preferências, mas não o arquivo dentro dele. Assim, antes da primeira execução, você grava o preferences.md com o script scripts/seed-preferences.sh do repositório.
Preferências relidas a cada execução
Um problema comum surge quando uma cópia das preferências fica embutida no prompt. Nesse caso, o agente continua aplicando regras que você já mudou.
A saída é fazer o agente ler o arquivo do zero em toda execução. Se a leitura falhar, ele deve parar e avisar, em vez de seguir com valores padrão.
Ledger do que já foi reportado
O agente mantém um ledger em ledger.md com cada item já reportado, o que impede o resumo de se repetir. Cada linha guarda a data, a origem, um ID estável e o último status conhecido:
2026-09-09 slack:C0123456789 1788963600.000100 refund thread: customer waiting on a decision
2026-09-11 github 481 review blocked, day 2 (still waiting)
2026-09-11 slack:C0234567891 1789117333.000300 enterprise escalation: owner named, in progress
O ID estável pode ser o timestamp de uma mensagem do Slack ou o número de um pull request. Com isso, o agente reporta a mudança de status em vez de repetir o item inteiro.
Guardrails e limites de gasto no Claude Managed Agents
Como a automação roda em segundo plano, ninguém acompanha cada passo. Portanto, os guardrails do Claude Managed Agents limitam tanto o que o agente pode fazer quanto o que ele pode gastar.
Limites sobre o que o agente pode fazer
O agente lê mensagens e issues escritas por outras pessoas, e esse texto pode conter instruções plantadas. A defesa, nesse caso, é restringir o que o agente conseguiria fazer caso as seguisse.
No exemplo, o token do GitHub e o store de preferências permitem apenas leitura, e o ambiente só alcança os hosts da allowlist. Uma instrução maliciosa ainda pode alterar o texto do resumo, mas não consegue escrever no GitHub nem editar as suas regras.
O Slack é a exceção, já que o mesmo token lê e publica. Por isso, convide o bot apenas para os canais onde ele realmente precisa ler ou postar.
Se você quiser ir além e medir como o agente usa as ferramentas que recebe, o conceito de agent experience ajuda a avaliar eficácia e custo.
Teto de gasto baseado em execuções reais
Um teto de gasto protege você de custos descontrolados. Comece com três a cinco vezes o custo de uma execução normal e depois aperte o valor conforme os números reais aparecem.
Uma execução que atinge o teto pausa em vez de falhar. Assim, um teto baixo demais parece um resumo que simplesmente ficou quieto, o que reforça a importância de observar as primeiras execuções.
budget:
  type: limit
  max_list_cost:
    # valor em centavos, como string: "500" equivale a US$ 5,00
    amount: "500"
    currency: USD
Toda execução recebe o valor integral. Quando uma delas atinge o limite, a sessão pausa com o motivo de parada budget_reached.
Como começar com o Claude Managed Agents
A forma mais rápida de começar com o Claude Managed Agents é pelo Claude Code. Primeiro, atualize a ferramenta com claude update.
Em seguida, rode a skill claude-api apontando para o artigo original:
# a skill lê o artigo, propõe a configuração e cria os recursos
/claude-api managed-agents-onboard https://claude.dev/blog/building-effective-agent-automations/
A skill grava os arquivos em uma pasta agents/ do seu projeto e cria os recursos com ant apply. Depois disso, trate o resultado como ponto de partida e ajuste fontes, destino e preferências ao seu contexto.
Você também vai precisar de um app do Slack, criado a partir do manifesto do repositório, e de um token do GitHub com permissão de leitura. Para detalhes sobre endpoints, limites e recursos em preview, consulte a documentação oficial do Managed Agents.
Conclusão
Uma automação útil depende menos do modelo e mais das regras ao redor dele. O Claude Managed Agents entrega a infraestrutura, mas a confiabilidade nasce de decisões explícitas no agent.md e no deployment.md.
Em resumo, leia cada fonte a partir de um bookmark e reporte falhas de leitura como falhas. Além disso, verifique cada item antes de publicar e só atualize o ledger depois que o Slack confirmar o envio.
Por fim, releia as preferências em toda execução, conceda apenas leitura onde o agente só lê e defina um teto de gasto realista. Com essas seis regras, o seu agente no Claude Managed Agents deixa de ser um experimento e passa a ser um colega confiável.
FAQ
O Claude Managed Agents já está disponível para uso em produção?
O serviço está em beta e exige o cabeçalho managed-agents-2026-04-01 em todas as requisições. Alguns recursos, como memória e multiagente, podem exigir solicitação de acesso.
Preciso manter algum servidor ligado para a automação rodar?
Não, porque o deployment roda na infraestrutura da Anthropic. Depois do ant apply, nenhuma máquina sua precisa ficar ligada.
Por que usar bookmarks em vez de ler as últimas 24 horas?
Uma janela fixa cria buracos quando a execução atrasa e repetições quando ela adianta. O bookmark garante que cada execução comece exatamente de onde a anterior parou.
O agente consegue ver o token real do Slack?
Não, porque o sandbox guarda apenas um marcador opaco. A plataforma injeta o token verdadeiro somente quando a requisição sai rumo a um host permitido.
O que acontece quando a execução atinge o teto de gasto?
A sessão pausa com o motivo budget_reached, em vez de falhar. Por isso, um teto baixo demais pode parecer um dia sem novidades.