
Machine Learning com o Microsoft Azure: um caso de uso típico
Machine learning no Azure permite treinar e publicar modelos preditivos sem montar infraestrutura própria, e um bom jeito de entender isso é com um problema real. Imagine que você faz parte da equipe de TI de uma empresa de telecomunicações que enfrenta, nos últimos meses, um aumento significativo nos cancelamentos de assinaturas.
Então, seu gerente traz um desafio: criar um software que analise o histórico dos clientes e preveja quem está prestes a cancelar. Com essa informação, a empresa pode oferecer uma promoção antes que o cliente vá embora.
Por que usar machine learning no Azure para esse problema
Se você acompanha a série de artigos sobre inteligência artificial do balta.io, já percebeu que esse é um caso típico de machine learning. Caso contrário, vale ler antes o artigo sobre tipos de machine learning no Azure Machine Learning, que explica os principais conceitos.
Este é o segundo artigo da série sobre IA e Microsoft Azure. O primeiro, explorando os recursos de inteligência artificial do Microsoft Azure, apresenta o panorama geral dos serviços.
Agora, o objetivo é prático: usar o Azure para treinar um modelo e aplicá-lo ao caso da empresa de telecomunicações. Além disso, você vai fazer tudo isso sem escrever uma linha de código de treinamento.
Antes de começar, você precisa de uma assinatura do Azure ativa e do Azure CLI instalado na sua máquina. O restante do fluxo acontece no portal e no estúdio do Azure Machine Learning, direto no navegador.
Em resumo, o roteiro tem quatro etapas: preparar os dados, criar o workspace, treinar com AutoML e publicar o modelo. Ao final, você terá um endpoint que responde se um cliente tende ou não a cancelar.
Previsão de churn como classificação binária
O problema da empresa se encaixa perfeitamente em um caso de classificação binária. Nesse tipo de problema, o label indica se um item pertence ou não a uma classe.
E esse é precisamente o nosso caso, porque precisamos identificar se um cliente vai ou não cancelar a assinatura. Em inglês, esse cancelamento recebe o nome de churn.
Essa abordagem permite que o modelo aprenda padrões nos dados históricos e faça previsões sobre o comportamento futuro. Por isso, a classificação binária aparece em aplicações como detecção de spam, diagnóstico médico e análise de crédito.
Se você quiser revisar os fundamentos antes de seguir, o artigo machine learning da série de fundamentos de IA explica treinamento, inferência, features e labels.
Preparando a base de dados
Para o experimento, você vai usar uma base de dados fictícia disponibilizada pela IBM e presente no notebook Customer churn prediction, no Kaggle. Segundo a IBM, o conjunto representa cerca de 7 mil clientes de uma operadora fictícia da Califórnia.
Cada linha do arquivo representa um cliente. Já cada coluna traz uma informação que, de alguma forma, influencia a chance de cancelamento.
Por exemplo, a base informa quais serviços o cliente assinou, como telefone, internet, backup, segurança e streaming. Também registra há quanto tempo ele é assinante, a forma de pagamento e o tipo de contrato.
Separando dados de treino e de teste
Para construir o modelo, você vai treinar o sistema com a base de dados e, depois, testar o resultado. Mas como testar de forma justa?
Uma solução simples é separar o arquivo em duas partes, uma para treino e outra para teste. Assim, o modelo nunca vê os registros de teste durante o treinamento.
- Primeiro, faça o download do arquivo
.csvfornecido pela IBM e salve em uma pasta do seu computador. - Depois, abra o arquivo e remova as últimas 100 linhas.
- Por fim, salve essas linhas em um novo arquivo
.csv, que você vai usar para testar o modelo após o treinamento.
Uma nota sobre a qualidade dos dados
O objetivo principal deste artigo é mostrar como usar os recursos do Azure para implantar uma solução de machine learning. Portanto, o tutorial não avalia se os dados refletem a situação atual do mercado de telecomunicações.
Na vida real, no entanto, investir tempo na coleta, limpeza e análise dos dados é fundamental. Afinal, a confiabilidade e a precisão de qualquer modelo dependem diretamente da qualidade da base.
Criando o workspace de machine learning no Azure
Com os dados prontos, chegou a hora de preparar o ambiente. O primeiro passo é entrar na sua conta pelo Azure CLI:
az login
Em seguida, crie um resource group para agrupar todos os recursos do experimento:
az group create \
  --name ml-rg \
  --location brazilsouth
Agora, crie o workspace do Azure Machine Learning. Para isso, acesse o portal do Azure e clique em "Create a resource".
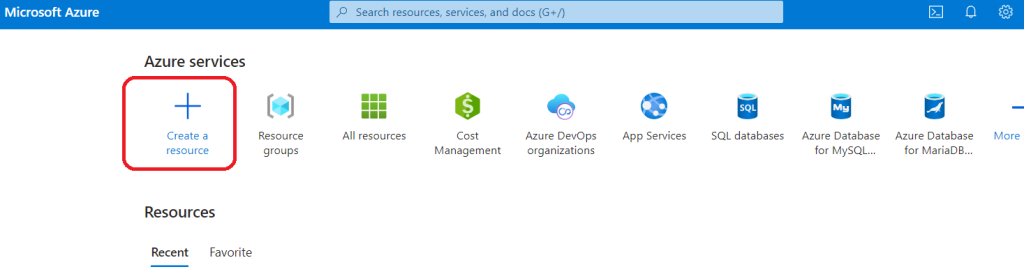
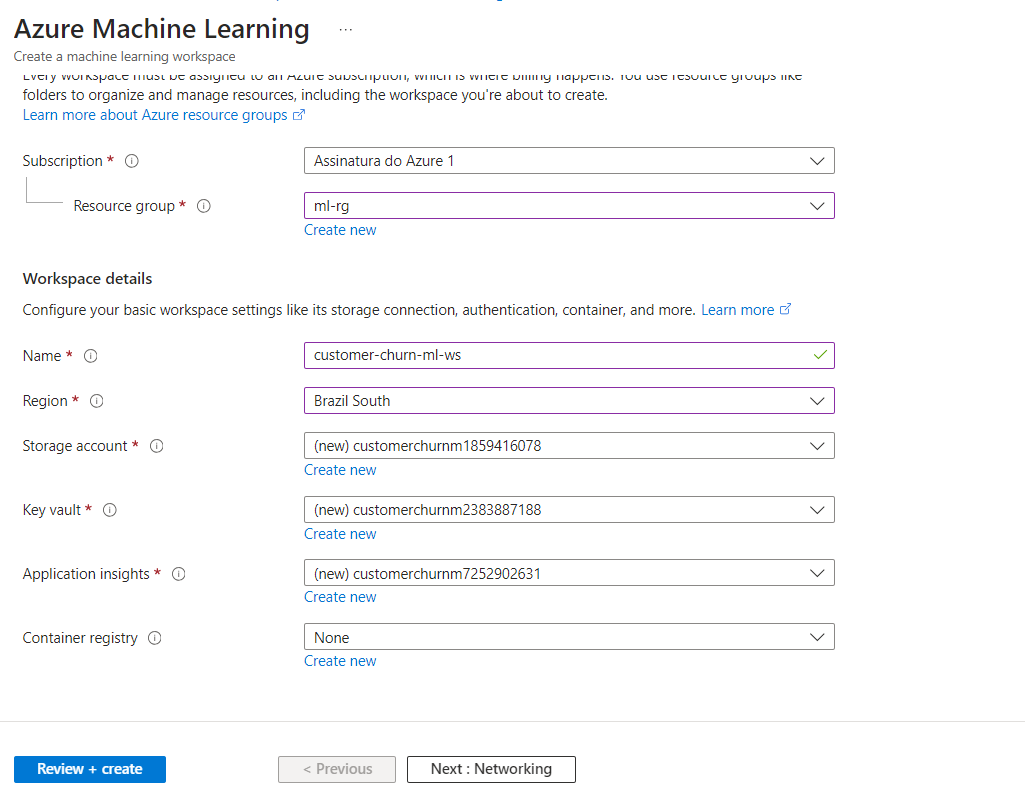
Procure por Machine Learning e crie o recurso com os parâmetros a seguir:
- Subscription: sua assinatura no Azure.
- Resource group: ml-rg.
- Name: customer-churn-ml-ws.
- Region: Brazil South.
Aceite os demais parâmetros e clique em Review + Create.
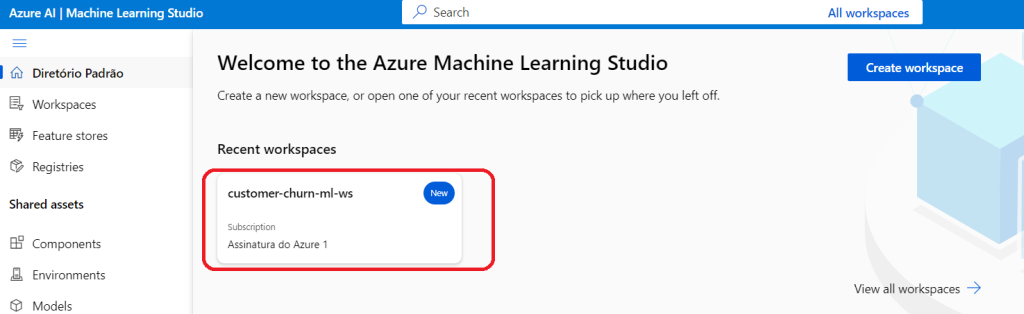
Depois que o recurso ficar pronto, abra o estúdio do Azure Machine Learning e selecione o workspace que você criou.
Treinando o modelo de machine learning no Azure com AutoML
O Azure Automated ML automatiza o processo de criação de modelos. Com ele, mesmo quem não tem experiência em machine learning consegue criar um modelo funcional.
Segundo a documentação, durante o treinamento o Azure cria vários pipelines em paralelo, testando algoritmos e parâmetros diferentes. Então, cada tentativa gera uma pontuação, e o serviço destaca o modelo que melhor se ajusta aos dados.
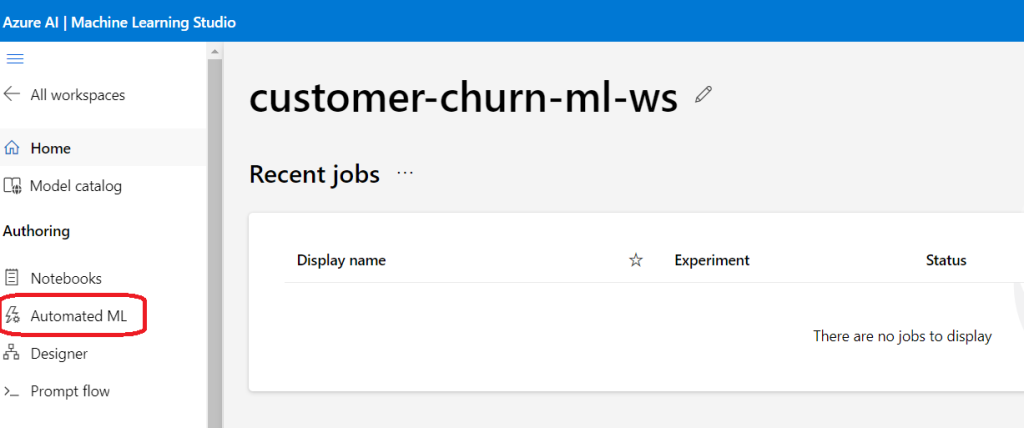
No menu do estúdio, crie um novo job de Automated ML.
Preencha as telas do assistente com os parâmetros abaixo:
Basic settings:
  Job name: telco-cust-churn-automl
  New experiment name: telco-cust-churn
  Description: ML for telco customers churn prediction
  Tags: none

Task type & data:
  Task type: Classification
  # Em Select data, clique em Create e preencha:
  Name: telco-cust-churn
  Description: Historic telco customers churn data
  Type: Tabular

Data source:
  # Selecione From local files e clique em Next
  # Selecione workspaceblobstore e clique em Next
  # Selecione Upload files or folder > Upload files e aponte para o csv de treino

Settings:
  File format: Delimited
  Delimiter: Comma
  Encoding: UTF-8
  Column headers: Only first file has headers
  Skip rows: None
  Dataset contains multi-line data: false

Schema:
  # Inclua todas as colunas, exceto Path e customerID
  # Clique em Next e depois em Create

Task settings:
  Task type: Classification
  Dataset: telco-cust-churn
  Target column: Churn

Additional configuration settings:
  Primary metric: AUCWeighted
  Explain best model: false
  Use all supported models: false
  Allowed models: [RandomForest, LightGBM]

Limits:
  Max trials: 3
  Max concurrent trials: 3
  Max nodes: 3
  Metric score threshold: 0.085
  Timeout: 15
  Iteration timeout: 15
  Enable early termination: true

Validation and test:
  Validation type: Train-validation split
  Percentage of validation data: 10
  Test dataset: None

Compute:
  Select compute type: Serverless
  Virtual machine type: CPU
  Virtual machine tier: Dedicated
  Virtual machine size: Standard_DS3_V2
  Number of instances: 1
Pronto, agora basta clicar em Submit e aguardar. O Azure treina os modelos e deixa o melhor disponível para uso.
De acordo com a documentação, a preparação do experimento pode levar até 10 minutos. Além disso, cada pipeline costuma levar mais 2 a 3 minutos para terminar.
Vale saber também que os algoritmos do AutoML têm uma aleatoriedade inerente. Por isso, se você repetir o experimento com a mesma configuração, a pontuação final pode variar um pouco entre as execuções.
Essa variação é normal e não indica erro na configuração. Ainda assim, ela reforça a importância de testar o modelo com os registros que você reservou.
Entendendo as configurações de machine learning no Azure
Os valores acima não são aleatórios, e vale entender o papel de cada grupo. Assim, você consegue adaptar o experimento a outros problemas de machine learning no Azure.
Coluna alvo e métrica principal
A coluna Churn é o label, ou seja, o valor que o modelo precisa aprender a prever. Já a coluna customerID fica de fora porque não traz informação útil, já que é apenas um identificador.
A métrica principal escolhida é a AUC ponderada, que mede a área sob a curva ROC. Na classificação binária, essa métrica vai de 0,5, o pior caso, até 1, o melhor caso.
Segundo a documentação do AutoML, métricas como a acurácia podem não otimizar bem quando as classes estão desbalanceadas. Nesse caso, a AUC ponderada costuma ser uma escolha melhor, o que faz sentido em bases de churn, onde há menos cancelamentos que permanências.
Modelos permitidos e limites
Ao desmarcar a opção de usar todos os modelos, você restringe o experimento a RandomForest e LightGBM. Com isso, o treinamento termina mais rápido e consome menos recursos.
Os limites seguem a mesma lógica. O campo Max trials define quantas combinações de algoritmo e hiperparâmetros o AutoML testa, enquanto Max concurrent trials define quantas rodam em paralelo.
Por sua vez, Metric score threshold encerra o job quando uma tentativa atinge a pontuação informada. Já Enable early termination interrompe o job quando a pontuação para de melhorar.
Os dois campos de timeout limitam, em minutos, a duração do experimento inteiro e de cada tentativa. Dessa forma, você evita surpresas na fatura.
Validação e computação
A validação do tipo Train-validation split separa 10% dos dados de treino para medir a qualidade dos modelos. Sem essa escolha explícita, o AutoML aplicaria uma técnica padrão de acordo com o número de linhas da base.
Para bases entre mil e 20 mil linhas, por exemplo, o padrão é a validação cruzada com três partições. Portanto, a escolha manual deixa o comportamento previsível.
Na computação, a opção Serverless dispensa a criação manual de um cluster. Assim, o Azure provisiona a máquina Standard_DS3_V2 apenas durante o treinamento.
Publicando o modelo como web service
Com o treinamento concluído, chegou a hora de testar se o modelo consegue prever o resultado. Essa é a hora de abrir o arquivo de teste que você reservou no início.
Clique na aba Models + child jobs e selecione o algoritmo que o treinamento escolheu. Por padrão, a lista já ordena os modelos pela métrica principal, então o melhor aparece no topo.
Em seguida, clique em Deploy e escolha Web service. Depois, preencha os campos a seguir:
Name: predict-churn
Description: Predict telco customer churn
Compute type: Azure Container Instance
Enable authentication: true
Clique em Deploy e aguarde até o status da publicação mudar para Succeeded. No tutorial oficial da Microsoft, esse processo leva cerca de 20 minutos, porque envolve registrar o modelo e configurar o serviço.
Um detalhe importante: o AutoML aplica automaticamente na inferência as mesmas transformações de dados usadas no treinamento. Portanto, você envia os dados brutos e o próprio modelo cuida da preparação.
Testando o modelo de machine learning no Azure
Com o serviço publicado, você já pode testar o modelo de machine learning no Azure diretamente pelo estúdio. No menu lateral, clique em Endpoints e selecione predict-churn.
Depois, abra a aba Test, selecione o editor JSON e preencha os campos com um registro do arquivo de teste. A ideia é informar os parâmetros e verificar se o modelo acerta o valor real da coluna Churn.
{
  "Inputs": {
    "data": [
      {
        "gender": "Female",
        "SeniorCitizen": 0,
        "Partner": false,
        "Dependents": false,
        "tenure": 48,
        "PhoneService": "Yes",
        "MultipleLines": "Yes",
        "InternetService": "Fiber optic",
        "OnlineSecurity": "No",
        "OnlineBackup": "Yes",
        "DeviceProtection": "Yes",
        "TechSupport": "No",
        "StreamingTV": "Yes",
        "StreamingMovies": "Yes",
        "Contract": "Month-to-month",
        "PaperlessBilling": true,
        "PaymentMethod": "Bank transfer (automatic)",
        "MonthlyCharges": 107.4,
        "TotalCharges": 5121.3
      }
    ]
  },
  "GlobalParameters": {
    "method": "predict"
  }
}
Clique no botão Test e confira o resultado. Em seguida, compare a previsão com o valor real do churn e veja se a máquina acertou.
Repita o teste com outros registros reservados, incluindo clientes que cancelaram e clientes que permaneceram. Assim, você tem uma ideia mais honesta do desempenho do modelo.
Como a autenticação está habilitada, qualquer aplicação que consumir esse endpoint fora do estúdio vai precisar de uma chave. Dessa forma, só sistemas autorizados conseguem pedir previsões.
Próximos passos com machine learning no Azure
Este tutorial deixou de lado muitos conceitos importantes, como engenharia de features, balanceamento de classes e interpretação de métricas. Ainda assim, ele mostra o fluxo completo de machine learning no Azure, do dado bruto até um endpoint consumível.
Um próximo passo natural é ativar a opção Explain best model e investigar quais colunas mais influenciam o cancelamento. Na prática, essa informação vale tanto quanto a própria previsão para o time de negócios.
Outro caminho é integrar o endpoint a uma aplicação real. Por exemplo, um sistema de CRM poderia consultar o modelo diariamente e gerar uma lista de clientes em risco para o time de retenção.
Limpando os recursos
O endpoint publicado e o armazenamento do workspace continuam gerando custo enquanto existirem. Por isso, quando terminar os testes, remova os recursos que não vai mais usar.
Como tudo ficou dentro do mesmo resource group, basta um único comando para apagar o experimento inteiro:
az group delete --name ml-rg
O CLI pede uma confirmação antes de remover tudo. Portanto, confira se o grupo não contém nenhum recurso que você queira manter.
Conclusão
Neste artigo, você usou machine learning no Azure para resolver um problema de classificação binária, a previsão de churn. Para isso, criou um workspace, treinou modelos com Automated ML, publicou o melhor deles e testou as previsões.
O objetivo principal era mostrar que, com o Microsoft Azure, até quem não tem experiência em machine learning consegue resolver problemas do mundo real. Contudo, quem decide se dedicar à área precisa conhecer o assunto mais a fundo.
Para isso, a própria Microsoft oferece uma série de recursos para expandir seus conhecimentos:
FAQ
Preciso saber programar para treinar um modelo no Azure Machine Learning?
Não. O Automated ML do estúdio permite configurar, treinar e publicar o modelo apenas pela interface web.
O que é churn?
Churn é o cancelamento de uma assinatura ou serviço por parte do cliente. Prever o churn ajuda a empresa a agir antes de perder o cliente.
Por que usar a AUC ponderada como métrica principal?
Porque ela costuma funcionar melhor que a acurácia quando as classes estão desbalanceadas, como acontece com cancelamentos e permanências.
Por que separar 100 linhas antes do treinamento?
Essas linhas servem para testar o modelo com dados que ele nunca viu. Assim, o teste mostra se o modelo generaliza bem.
Quanto tempo leva a publicação do modelo?
No tutorial oficial da Microsoft, a publicação como web service leva cerca de 20 minutos.