
Azure Machine Learning: Tipos de Machine Learning

Os tipos de machine learning definem como um modelo aprende a partir dos dados, e escolher o tipo certo depende sempre do que você quer prever. Neste artigo, você vai entender cada um deles, a finalidade de cada abordagem e como elas aparecem no Azure Machine Learning.
Este conteúdo é a segunda parte de uma série sobre Machine Learning e Azure Machine Learning. Se você ainda não leu a introdução, comece pela parte 1 sobre Azure Machine Learning e depois volte para cá.
O que são os tipos de machine learning
Um modelo de machine learning é, no fundo, uma aplicação que encapsula uma função. Essa função recebe um ou mais valores de entrada e calcula um valor de saída.
O processo que define essa função se chama treinamento. Depois disso, o modelo usa a função para prever novos valores, em uma etapa conhecida como inferência.
Os tipos de machine learning surgem justamente da forma como o treinamento acontece. Em outras palavras, o que muda entre eles é o tipo de dado disponível e o tipo de resposta que o modelo precisa entregar.
Por isso, antes de pensar em algoritmo, você precisa responder a uma pergunta simples: o que eu quero prever? A resposta indica qual dos tipos de machine learning faz mais sentido para o seu cenário.
Features e labels: a base dos tipos de machine learning
Antes de separar os tipos de machine learning, vale entender dois termos que aparecem em todos eles. São eles as features e os labels.
O que é uma feature
Uma feature, também chamada de característica ou atributo, é uma variável de entrada individual que o modelo usa. Ou seja, são os dados que o modelo analisa para aprender e fazer previsões.
Por exemplo, em um modelo que prevê o preço de casas, as features podem incluir a área do imóvel, o número de quartos, a idade da construção e a localização. Cada feature contribui com uma peça de informação que o modelo considera.
Na notação matemática, as features aparecem como x. Como uma observação costuma ter vários valores, x geralmente é um vetor, algo como [x1, x2, x3].
O que é um label
O label, também chamado de rótulo ou alvo, é a variável que o modelo aprende a prever. Em outras palavras, é a resposta que cada exemplo de treinamento traz consigo.
Continuando com o exemplo anterior, o label seria o preço real de cada casa. Já em uma tarefa de classificação, o label seria a categoria do exemplo, como identificar se um e-mail é spam ou não.
Na notação matemática, o label aparece como y. Assim, o treinamento busca uma função f tal que y = f(x), e a previsão gerada pelo modelo recebe o nome de ŷ, lido como "y-hat".
Supervisionado, o primeiro dos tipos de machine learning
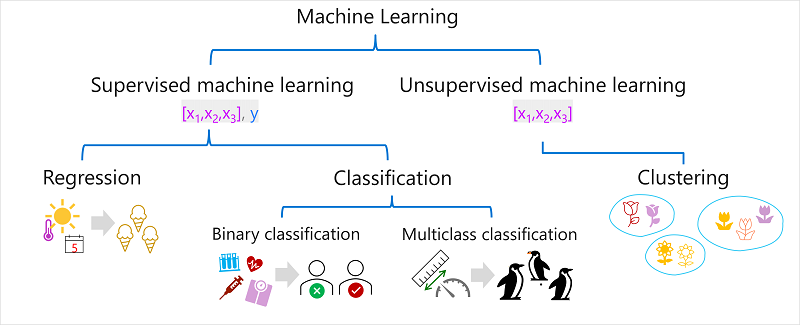
O aprendizado supervisionado (supervised machine learning) é o termo para os algoritmos cujos dados de treinamento contêm tanto features quanto labels conhecidos. Entre os tipos de machine learning, ele é o mais comum no dia a dia das empresas.
Esse tipo de aprendizado estabelece uma relação entre features e labels com base em observações passadas. Dessa forma, o modelo consegue prever labels desconhecidos para novas features no futuro.
O aprendizado supervisionado se divide em duas grandes famílias: regressão e classificação. A diferença entre elas está no formato do label.
Regressão
A regressão (regression) é uma forma de aprendizado supervisionado na qual o label previsto é um valor numérico. Portanto, sempre que a resposta for uma quantidade, um preço ou uma medida, você provavelmente está diante de um problema de regressão.
Alguns exemplos clássicos ajudam a fixar a ideia:
- O número de sorvetes vendidos em um dia, com base na temperatura, na chuva e na velocidade do vento.
- O preço de venda de um imóvel, com base na área, no número de quartos e em métricas socioeconômicas da região.
- A eficiência de combustível de um carro, com base no tamanho do motor, no peso, na largura, na altura e no comprimento.
Nesse contexto, o modelo preditivo funciona como uma ferramenta estatística. Ele analisa padrões em dados históricos para estimar resultados futuros, e por isso aparece em áreas como finanças, saúde e marketing.
Classificação binária
A classificação (classification) também é supervisionada, mas nela o label representa uma categoria, chamada de classe. Ela se subdivide em dois cenários comuns, o binário e o multiclasse.
Na classificação binária, o label indica se um item pertence ou não a uma classe específica. Em outras palavras, o modelo prevê um entre dois resultados mutuamente exclusivos.
Veja alguns exemplos:
- O risco de diabetes de um paciente, com base em peso, idade e nível de glicose no sangue.
- A chance de um cliente do banco deixar de pagar um empréstimo, com base em renda, histórico de crédito e idade.
- A resposta de um cliente de mala direta a uma oferta, com base em dados demográficos e compras anteriores.
Em todos esses casos, o modelo devolve uma resposta binária, como verdadeiro ou falso e positivo ou negativo. Além disso, a previsão vale para uma única classe.
Classificação multiclasse e multilabel
A classificação multiclasse estende a binária para prever um label entre várias classes possíveis. Por exemplo, ela identifica a espécie de um pinguim (Adelie, Gentoo ou Chinstrap) a partir de suas medidas físicas.
Outro exemplo é prever o gênero de um filme, como comédia, terror, romance, aventura ou ficção científica. Nesse caso, o modelo usa o elenco, o diretor e o orçamento como features.
Na maioria dos cenários multiclasse, as classes são mutuamente exclusivas. Afinal, um pinguim não pode ser Gentoo e Adelie ao mesmo tempo.
No entanto, existem algoritmos para classificação multilabel, em que uma observação aceita mais de um label válido. Assim, um filme pode receber as categorias drama e suspense simultaneamente.
Não supervisionado, o segundo dos tipos de machine learning
O aprendizado não supervisionado (unsupervised machine learning) treina modelos com dados que contêm somente features. Ou seja, não existe nenhum label conhecido durante o treinamento.
Nesse caso, os algoritmos determinam as relações entre as features das próprias observações. Por isso, esse grupo dos tipos de machine learning serve para descobrir estrutura onde ninguém a rotulou antes.
Clustering
A forma mais comum de aprendizado não supervisionado é o clustering, ou agrupamento. O algoritmo identifica semelhanças entre observações com base nas features e as organiza em grupos discretos.
Veja dois exemplos práticos:
- Agrupar flores semelhantes com base no tamanho, no número de folhas e no número de pétalas.
- Identificar grupos de clientes parecidos com base em atributos demográficos e comportamento de compra.
De certa forma, o clustering lembra a classificação multiclasse, porque ambos colocam observações em conjuntos discretos. A diferença é que, na classificação, você já conhece a classe de cada observação do treinamento.
Então, o algoritmo de classificação aprende a relação entre as features e o label conhecido. Já no clustering, não existe label prévio, e o algoritmo agrupa os dados puramente pela similaridade das features.
Clustering e classificação trabalhando juntos
Em alguns cenários, o clustering ajuda a descobrir quais classes existem antes de treinar um modelo de classificação. Na prática, essa combinação aparece com frequência em projetos de segmentação.
Primeiro, você aplica o clustering para segmentar os clientes em grupos. Em seguida, analisa esses grupos para nomear diferentes classes, como alto valor, baixo valor ou compra frequente.
Depois, você usa essas categorias para rotular as observações dos resultados agrupados. Por fim, os dados rotulados alimentam um modelo de classificação que prevê em qual categoria cada novo cliente se encaixa.
Esse fluxo mostra que os tipos de machine learning não competem entre si. Pelo contrário, eles se complementam ao longo de um mesmo projeto.
Semissupervisionado: um tipo intermediário de machine learning
A aprendizagem semissupervisionada combina uma pequena quantidade de dados com labels e uma grande quantidade de dados sem labels durante o treinamento. Assim, ela fica entre o aprendizado supervisionado e o não supervisionado.
No supervisionado, todos os dados de treinamento têm labels. Por outro lado, no não supervisionado, nenhum dado tem label.
Entre os tipos de machine learning, essa abordagem se torna útil quando rotular dados custa caro ou exige muito trabalho manual. Por exemplo, imagine milhares de imagens médicas em que apenas uma parte recebeu a revisão de um especialista.
Nesse caso, o modelo aproveita os poucos exemplos rotulados e extrai padrões adicionais da grande massa sem rótulo. Com isso, você reduz o custo de preparação dos dados sem abrir mão de uma referência confiável.
Reforço, o tipo de machine learning guiado por recompensas
O aprendizado por reforço é a área em que um agente aprende a tomar decisões por tentativa e erro. Ele interage com um ambiente para maximizar uma recompensa acumulada ao longo do tempo.
Esse tipo de aprendizado se inspira na forma como pessoas e animais parecem aprender certas habilidades. Ou seja, o comportamento desejado recebe recompensa, enquanto o comportamento indesejado recebe punição.
Diferente dos outros tipos de machine learning, aqui não existe um conjunto fixo de exemplos com respostas. Em vez disso, o próprio agente gera a experiência enquanto age.
Elementos do aprendizado por reforço
Cinco elementos descrevem como o aprendizado por reforço funciona:
- Agente: a entidade que toma decisões dentro do ambiente, como um robô, um jogador virtual ou um sistema automatizado.
- Ambiente: o contexto em que o agente opera, como um jogo, uma simulação física ou um mercado financeiro.
- Ações: as operações que o agente pode escolher executar.
- Estado: a representação atual do ambiente, base para cada decisão do agente.
- Recompensa: o sinal imediato que chega após cada ação e indica o quanto ela ajudou no objetivo.
Processo de aprendizagem e métodos comuns
O agente observa o estado do ambiente e escolhe uma ação com base em uma política. Essa política é um conjunto de regras, ou uma função matemática, que mapeia estados em ações.
Em seguida, o agente recebe uma recompensa e um novo estado. Então, ele ajusta a política para aumentar as recompensas futuras, e o ciclo se repete.
Entre os métodos mais comuns, destacam-se três:
- Q-Learning: um método de diferenças temporais que aprende o valor de tomar uma ação em determinado estado.
- Policy Gradient: métodos que ajustam diretamente a política do agente para maximizar a recompensa, em vez de aprender valores de estado e ação.
- Deep Reinforcement Learning: combina deep learning com aprendizado por reforço para lidar com entradas complexas, como imagens e linguagem natural.
Aplicações do aprendizado por reforço
O aprendizado por reforço aparece em cenários que exigem decisões em sequência:
- Jogos: dominar jogos complexos como Go, xadrez e videogames.
- Robótica: aprender tarefas físicas como caminhar, pegar objetos ou voar.
- Sistemas de navegação: desenvolver sistemas autônomos de condução ou voo.
- Otimização de processos: melhorar a eficiência de processos industriais, logísticos e de negócio.
De fato, a capacidade de resolver problemas com decisões sequenciais complexas torna essa abordagem central em várias aplicações avançadas de inteligência artificial.
Como escolher entre os tipos de machine learning
A escolha começa pelo formato da resposta que você espera e pelos dados que você tem. Por isso, vale seguir um raciocínio simples antes de abrir qualquer ferramenta.
| Pergunta sobre o problema | Tipo indicado |
|---|---|
| Quero prever um número? | Regressão (supervisionado) |
| Quero prever uma entre duas opções? | Classificação binária (supervisionado) |
| Quero prever uma entre várias categorias? | Classificação multiclasse (supervisionado) |
| Não tenho labels e quero descobrir grupos? | Clustering (não supervisionado) |
| Tenho poucos labels e muitos dados sem rótulo? | Semissupervisionado |
| Um agente precisa aprender agindo em um ambiente? | Aprendizado por reforço |
Além disso, lembre que os tipos de machine learning podem atuar em conjunto. Como vimos, um clustering pode preparar os labels que depois treinam uma classificação.
Outro ponto importante é a qualidade dos dados. Mesmo o tipo correto gera previsões ruins quando as features não representam bem o problema.
Tipos de machine learning no Azure Machine Learning
O Azure Machine Learning oferece o Automated ML (AutoML), recurso que treina e ajusta modelos a partir de uma métrica que você define. Nele, os tipos de machine learning aparecem como tipos de tarefa.
Para dados tabulares, o AutoML suporta classificação, regressão e previsão de séries temporais (forecasting). Além disso, ele oferece tarefas de visão computacional, como classificação de imagens e detecção de objetos, e de linguagem natural, como classificação de texto e reconhecimento de entidades.
Na prática, você escolhe o tipo de tarefa, aponta o conjunto de dados e indica a coluna alvo, que é o label. Então, o serviço testa diferentes algoritmos e combinações de parâmetros até encontrar o melhor modelo.
A previsão de séries temporais merece uma observação. Segundo a documentação oficial do AutoML, o serviço trata esse problema como uma regressão multivariada, ou seja, ela continua sendo uma forma de aprendizado supervisionado.
Se você quer entender o panorama completo dos serviços de IA da plataforma, vale ler também sobre os recursos de inteligência artificial do Microsoft Azure. Para revisar a base conceitual, o artigo sobre conceitos fundamentais de inteligência artificial complementa bem esta leitura.
Conclusão
Os principais tipos de machine learning são o supervisionado e o não supervisionado. O supervisionado usa features e labels, enquanto o não supervisionado usa apenas features.
Dentro do supervisionado, temos a regressão e a classificação, que por sua vez se divide em binária e multiclasse. Já no não supervisionado, o clustering agrupa observações apenas pela similaridade das features.
Além desses dois grupos, o semissupervisionado aproveita poucos labels e muitos dados sem rótulo. Por fim, o aprendizado por reforço ensina um agente a decidir com base em recompensas.
Você também pode combinar os tipos de machine learning, usando primeiro o clustering para segmentar e depois a classificação para categorizar novos elementos. Assim, cada técnica entra no momento em que gera mais valor para o projeto.
FAQ
Quais são os principais tipos de machine learning?
Os principais são o aprendizado supervisionado, o não supervisionado, o semissupervisionado e o aprendizado por reforço. Os dois primeiros concentram a maior parte dos casos de uso do dia a dia.
Qual a diferença entre regressão e classificação?
Na regressão, o modelo prevê um valor numérico, como um preço. Na classificação, o modelo prevê uma categoria, como spam ou não spam.
Clustering é o mesmo que classificação?
Não. A classificação aprende a partir de classes já conhecidas, enquanto o clustering descobre grupos sem nenhum label prévio.
Quando usar aprendizado semissupervisionado?
Quando você tem poucos dados rotulados e muitos dados sem rótulo, e rotular tudo seria caro ou demorado.
O Azure Machine Learning suporta quais tipos de tarefa no AutoML?
O AutoML suporta classificação, regressão e previsão de séries temporais para dados tabulares, além de tarefas de visão computacional e de linguagem natural.