
Azure Machine Learning: Introdução

Antes de usar o Azure Machine Learning, vale entender o que é machine learning e como um modelo preditivo nasce. Machine learning, ou aprendizado de máquina, é a união de duas disciplinas, ciência de dados e engenharia de software, e é um dos pilares da inteligência artificial.
Em outras palavras, é a forma pela qual ensinamos as máquinas a imitar o comportamento humano a partir de dados. Neste artigo, você vai entender os objetivos do machine learning, o papel dos modelos, as etapas de treinamento e inferência e, por fim, onde o serviço da Microsoft se encaixa.
Série sobre Azure Machine Learning
Este conteúdo é a primeira parte de uma série de artigos sobre machine learning e Azure Machine Learning. Aqui ficam os fundamentos, enquanto a segunda parte aprofunda os tipos de machine learning e a finalidade de cada um.
A ideia é construir a base conceitual primeiro. Assim, quando chegarmos às ferramentas do Azure, cada recurso terá um propósito claro.
Objetivos do machine learning
O objetivo do machine learning é criar um modelo preditivo. Depois, podemos incorporar esse modelo em nossas aplicações ou serviços para que eles façam previsões sobre novos dados.
Em resumo, o machine learning não entrega uma resposta pronta, mas sim um componente de software capaz de gerar respostas. É esse componente que os desenvolvedores conectam aos sistemas do dia a dia.
O que é um modelo preditivo
Um modelo preditivo em machine learning é uma ferramenta estatística que analisa padrões em dados históricos. Com base nesses padrões, ele faz estimativas ou prevê resultados futuros.
Esse tipo de modelo aparece em diversas áreas, como finanças, saúde e marketing, sempre com o propósito de antecipar eventos. Por exemplo, um banco pode estimar a chance de inadimplência, enquanto uma loja pode prever a demanda de um produto.
O que significa preditivo
O termo "preditivo" se refere à capacidade de prever eventos futuros ou resultados com base na análise de dados passados ou de tendências existentes.
Em contextos como negócios, tecnologia e ciência, estratégias preditivas usam modelos estatísticos e algoritmos de machine learning para identificar padrões nos dados. Com isso, elas projetam o que pode acontecer no futuro.
Na prática, essas previsões ajudam a tomar decisões mais informadas e a otimizar processos. Isso vale para marketing, finanças, saúde e também para operações industriais.
Processo do machine learning
O processo de treinamento de um modelo exige integração entre duas áreas. A primeira é a ciência de dados, cujos profissionais exploram e preparam os dados antes do treinamento.
Em seguida, entram os engenheiros de software, que integram esses modelos às aplicações. Dessa forma, as aplicações conseguem fazer previsões sobre novos dados e, com isso, gerar novos dados.
Esse processo de previsão recebe o nome de inferência, ou inferencing em inglês. Guarde esse termo, porque ele vai aparecer várias vezes ao longo da série.
A divisão entre as duas áreas também explica por que plataformas como o Azure Machine Learning existem. Elas criam um ambiente comum para que cientistas de dados e desenvolvedores trabalhem no mesmo ciclo de vida do modelo.
O que é machine learning
A origem do machine learning está na modelagem estatística e matemática, que são tópicos fundamentais dentro do assunto. Portanto, gostar de matemática ajuda bastante para entender o tema mais a fundo, inclusive antes de explorar o Azure Machine Learning.
A ideia central é usar dados de observações feitas no passado para prever valores desconhecidos. Em vez de programar cada regra manualmente, deixamos que os dados revelem a relação entre causas e efeitos.
Por exemplo, se a sua loja tem alguma sazonalidade ligada ao clima, você pode cruzar o histórico de vendas com informações climáticas. Assim, é possível tentar prever um resultado financeiro futuro.
Da mesma forma, hospitais podem usar dados clínicos de pacientes atendidos no passado. Com eles, testes automatizados conseguem prever, por exemplo, quando um paciente pode estar em risco de diabetes, com base em peso, glicose no sangue e outras métricas.
Machine learning como função
Como o machine learning se apoia em matemática e estatística, é comum pensar nos modelos em termos matemáticos. Essa visão também é a base de todo experimento que você vai rodar no Azure Machine Learning.
Um modelo de machine learning é um software que encapsula uma função. Essa função calcula um valor de saída com base em um ou mais valores de entrada.
O processo de definir essa função se chama treinamento, ou training. Depois que a função existe, podemos usá-la para prever novos valores, no processo de inferência.
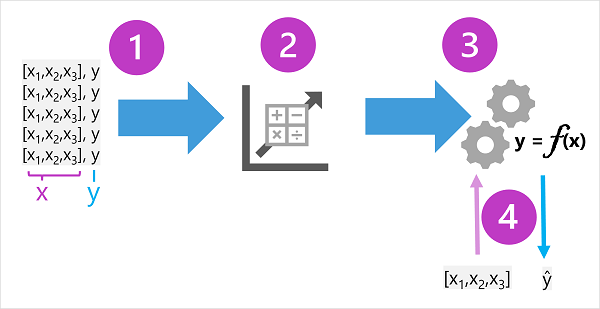
Treinamento com features e labels
O treinamento sempre parte de dados de observações passadas, e esse ponto é extremamente importante. Sem histórico, não existe padrão para o algoritmo aprender, e é por isso que o Azure Machine Learning dedica tanto espaço ao gerenciamento de dados.
Essas observações incluem os atributos daquilo que está sendo observado, chamados de features. Além disso, temos o valor que queremos que o modelo aprenda a prever, conhecido como label.
Em uma visão mais matemática, representamos esses itens como X e Y. Nesse caso, X representa as features e Y representa as labels.
Como cada observação costuma ter várias features, X é na verdade um vetor, ou seja, um array com múltiplos valores.
[x1, x2, x3, x4, ...]
Vetor ou array
Na matemática, um vetor é uma quantidade que possui magnitude e direção. Ele pode ser representado como uma lista ordenada de números, as coordenadas, que especificam sua orientação em um espaço multidimensional.
O termo "array" não é comum na matemática pura. Por outro lado, em algoritmos e programação, um array pode ser qualquer coleção sequencial de elementos, como números, strings ou outros arrays.
Na programação, um array é uma estrutura de dados que armazena uma coleção fixa de elementos do mesmo tipo. Os elementos ficam em posições sequenciais na memória, e cada um é acessível por um índice.
Já o termo "vetor" muda de sentido conforme a linguagem. Em C++, por exemplo, o vector é uma estrutura dinâmica que pode mudar de tamanho, ao contrário de um array, que tem tamanho fixo.
Entendendo o cenário
Trazendo para o mundo real, imagine um modelo cujo objetivo é prever a venda de sorvetes com base no clima. As medições do dia são as features, e a quantidade de sorvetes vendidos é a label.
| x1 | x2 | x3 | x4 | y |
|---|---|---|---|---|
| Dia | Temperatura | Pluviosidade | Vel. vento | Sorvetes vendidos |
| 1 | 28 | 1.2 | 50 | 12 |
| 2 | 32 | 1.2 | 25 | 32 |
| 3 | 27 | 1 | 10 | 17 |
| ... | ... | ... | ... | ... |
Já em um cenário médico, o objetivo pode ser prever se o paciente tem risco de diabetes. As medidas do paciente, como peso e glicose no sangue, são as features (x), enquanto o índice de diabetes é a label (y), com 0 para sem risco e 1 para em risco.
A documentação da Microsoft traz ainda um terceiro exemplo, de pesquisa na Antártida. Nele, medidas físicas de um pinguim, como o comprimento das nadadeiras e a largura do bico, servem para prever a espécie do animal.
Em todos os casos, a estrutura é a mesma que você vai encontrar ao preparar dados no Azure Machine Learning.
Algoritmo, modelo e a função f
No segundo passo do diagrama, aplicamos um algoritmo aos dados para tentar relacionar as features com as labels. Essa relação vira um cálculo que pode ser executado sobre X para obter Y.
O algoritmo escolhido varia conforme o que queremos prever e o problema que queremos resolver. Contudo, o princípio é sempre o mesmo: encontrar uma função que se ajuste aos dados, processo chamado de fit, na qual as features permitem calcular as labels.
O resultado do algoritmo é um modelo, que encapsula como uma função o cálculo derivado do algoritmo. Na notação matemática, chamamos essa função de f, o que leva à representação abaixo.
y = f(x)
Vale uma observação sobre derivadas, conceito que aparece com frequência nesse contexto. A derivada mede como uma função muda à medida que suas entradas variam, isto é, fornece a taxa de variação em relação a uma das variáveis.
Inferência e o y-hat
Uma vez pronto e treinado, o modelo pode ser usado para inferência. Em resumo, ele nada mais é do que um programa que encapsula a função gerada durante o treinamento.
A partir desse momento, podemos informar diversos conjuntos de valores de entrada. Como saída, recebemos previsões das labels correspondentes.
Como esse resultado é uma previsão calculada por uma função, e não um valor observado, ele recebe uma notação própria. Escrevemos ŷ, lido como "y-hat", para deixar clara a diferença.
Onde entra o Azure Machine Learning
Até aqui falamos de conceitos que valem para qualquer plataforma. Agora, o Azure Machine Learning é o serviço da Microsoft que oferece um ambiente gerenciado para todo esse ciclo, do preparo dos dados à publicação do modelo.
Segundo a documentação oficial do Azure Machine Learning, a plataforma permite colaborar com o time por meio de notebooks, recursos de computação e dados compartilhados. Além disso, ela ajuda a publicar modelos em escala e a governá-los com práticas de MLOps.
Workspace do Azure Machine Learning
O workspace é o recurso de nível mais alto do Azure Machine Learning. Ele centraliza todos os artefatos criados durante o trabalho, como modelos, ambientes, componentes e ativos de dados.
Também é no workspace que fica o histórico de todos os jobs, com logs, métricas, saídas e uma cópia dos scripts usados. Dessa forma, o time consegue auditar como cada modelo chegou ao resultado final.
Você pode criar um workspace pelo portal do Azure, pelo próprio studio, pela extensão do VS Code, pelo SDK de Python ou pela Azure CLI com a extensão ml. Para automação, também é possível usar templates Bicep, ARM ou Terraform.
Ferramentas do Azure Machine Learning studio
O studio é a interface web do serviço e não exige nenhuma instalação. Nele, você encontra experiências diferentes conforme o tipo de projeto e o seu nível de experiência com machine learning.
Os notebooks permitem escrever e executar código em servidores Jupyter gerenciados, integrados ao studio. Também é possível abrir esses notebooks no VS Code, na web ou no desktop.
Por sua vez, o designer oferece uma interface de arrastar e soltar para montar pipelines. Com ele, você treina e publica modelos sem escrever código, conectando dados e componentes visualmente.
Já o AutoML automatiza as tarefas repetitivas do desenvolvimento de modelos. Ele testa rapidamente muitas combinações de algoritmos e hiperparâmetros e indica o melhor modelo segundo a métrica escolhida.
Inferência no Azure Machine Learning
Lembra da divisão entre ciência de dados e engenharia de software? No Azure Machine Learning, o modelo treinado pode ser publicado como um endpoint de inferência.
Com isso, a aplicação apenas envia as features em uma requisição e recebe a previsão como resposta. Em outras palavras, o desenvolvedor consome o modelo como consome qualquer outra API.
O serviço ainda se integra ao Application Insights para monitorar esses endpoints. Assim, o time acompanha falhas, latência e uso do modelo depois que ele entra em produção.
Se você trabalha com .NET, o artigo sobre IA generativa no .NET e C# mostra outra forma de consumir modelos de IA dentro das suas aplicações.
Conclusão sobre Azure Machine Learning
Machine learning une ciência de dados e engenharia de software para criar modelos preditivos. Esses modelos são funções aprendidas a partir de dados históricos, com features como entrada e labels como saída.
O treinamento define a função, enquanto a inferência usa essa função para prever novos valores, o famoso y-hat. Com essa base, as ferramentas do Azure Machine Learning deixam de parecer mágicas e passam a fazer sentido.
Na próxima parte da série, veremos os tipos de machine learning e quando usar cada um. Para quem quer revisar a base de IA antes, os conceitos fundamentais de inteligência artificial são um bom ponto de partida.
FAQ
Qual o objetivo do machine learning?
O objetivo é criar um modelo preditivo a partir de dados históricos. Depois, esse modelo é incorporado a aplicações para prever valores desconhecidos.
Qual a diferença entre features e labels?
Features são os atributos observados, representados por x. Labels são os valores que o modelo aprende a prever, representados por y.
O que é inferência em machine learning?
É o uso do modelo já treinado para prever novos valores. O resultado é uma previsão, representada por ŷ, e não um valor observado.
Preciso saber programar para usar o Azure Machine Learning?
Não necessariamente, pois o designer e o AutoML permitem treinar modelos sem código. Para cenários avançados, porém, o SDK de Python e a CLI oferecem mais controle.
O que é o workspace do Azure Machine Learning?
É o recurso central do serviço, que guarda modelos, dados, ambientes e o histórico de todos os jobs executados.