Conexões no SQL Server: diferenças para o PostgreSQL
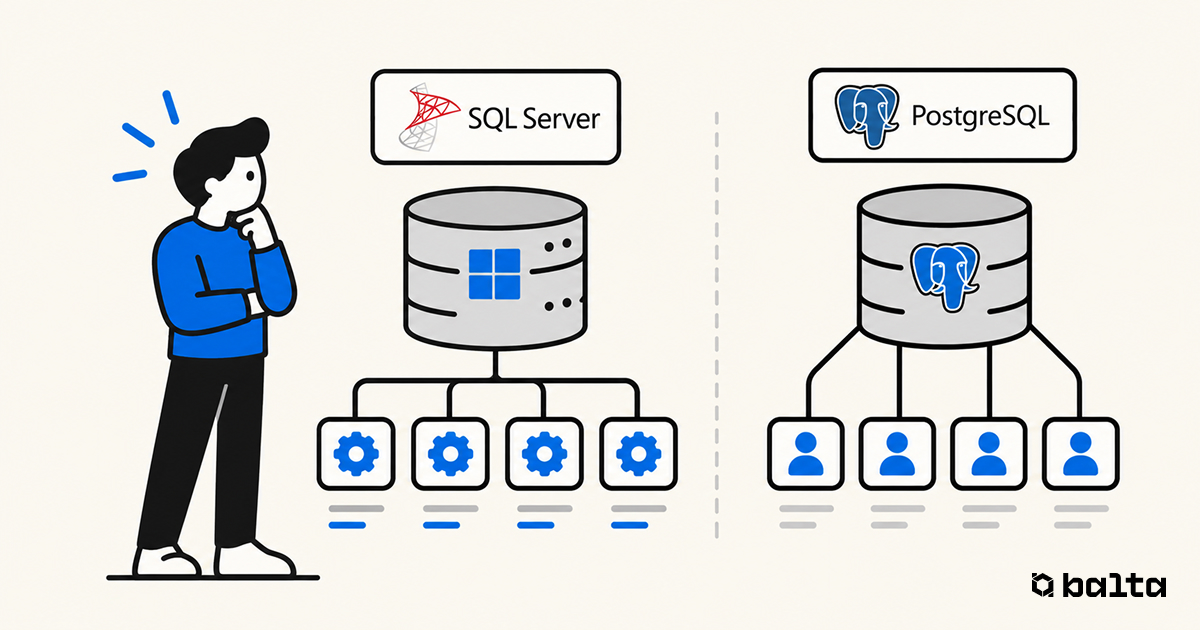
As conexões no SQL Server funcionam de um jeito bem diferente do que acontece no PostgreSQL, e entender essa diferença muda a forma como você projeta aplicações .NET. Neste artigo, vamos comparar os dois modelos, olhar para a arquitetura de workers do SQL Server e ver como o pool do ADO.NET simplifica o dia a dia.
O ponto de partida é uma série recente do Jerry Nixon no blog do Azure SQL, voltada para quem está migrando do PostgreSQL. Além disso, todo o conteúdo foi conferido na documentação oficial da Microsoft e do PostgreSQL.
Por que comparar conexões no SQL Server e no PostgreSQL
Todo acesso a um banco de dados começa com uma conexão. Por isso, a forma como o motor trata cada conexão define limites de escala, custo de infraestrutura e até decisões de arquitetura.
Quem vem do PostgreSQL costuma carregar hábitos de proteção, como limitar conexões, instalar um pooler externo e vigiar sessões ociosas. No entanto, ao trabalhar com conexões no SQL Server, boa parte desses cuidados deixa de ser obrigatória.
Isso não significa que um banco é melhor em tudo. Na prática, cada motor nasceu com premissas diferentes, e essas premissas aparecem com clareza justamente no gerenciamento de conexões.
Vale lembrar também que, no ecossistema Microsoft, o termo SQL costuma se referir ao T-SQL, a variante da Microsoft do padrão SQL. Neste artigo, usamos SQL Server para falar do motor e T-SQL para falar da linguagem.
Como o PostgreSQL trata cada conexão
Abrir uma conexão no PostgreSQL com C# é simples. O código abaixo usa o Npgsql, o provider mais comum para .NET.
using Npgsql;

// Abre uma conexão com o PostgreSQL
using var connection = new NpgsqlConnection(connectionString);
connection.Open();

// Executa o trabalho com a conexão aberta
A simplicidade do código, porém, esconde um custo. O PostgreSQL usa um processo do sistema operacional para cada conexão, então cada cliente conectado vira um processo de backend dedicado.
O custo de um processo por conexão
Cada processo de backend tem memória privada, estado de execução próprio e participa do escalonamento do sistema operacional. Consequentemente, existe um teto prático de conexões antes que o desempenho comece a cair.
A própria documentação do PostgreSQL informa que o valor padrão de max_connections costuma ser 100. Além disso, aumentar esse valor faz o servidor reservar mais recursos, incluindo memória compartilhada.
Outro detalhe importante é que esse limite vale para o servidor inteiro, e não para cada banco. Ou seja, todas as bases hospedadas na mesma instância disputam as mesmas 100 conexões padrão.
A vigilância constante sobre conexões ociosas
Uma conexão longa não é um problema por si só. Contudo, muitas conexões abertas ao mesmo tempo consomem recursos mesmo quando estão paradas.
O caso mais delicado é a transação ociosa, que aparece com o estado idle in transaction. Por isso, quem administra PostgreSQL costuma consultar a view pg_stat_activity com frequência.
-- Lista as sessões ativas e ociosas no PostgreSQL
SELECT pid, state, query, xact_start
FROM pg_stat_activity;
Quando algo foge do controle, entram em cena as funções pg_cancel_backend() e pg_terminate_backend(). Além delas, muitas equipes colocam o PgBouncer na frente do banco para reduzir o número de conexões físicas.
Transações longas e o VACUUM
No PostgreSQL, transações longas seguram versões antigas das linhas. Dessa forma, elas atrapalham o VACUUM, aumentam o inchaço das tabelas e pressionam o contador de IDs de transação.
Por esse motivo, a recomendação comum é manter transações curtas e limitar a concorrência. Em outras palavras, o modelo de conexões do banco acaba ditando decisões de arquitetura da aplicação.
Como funcionam as conexões no SQL Server
As conexões no SQL Server seguem outra lógica. Uma conexão não exige um processo dedicado do sistema operacional, porque o motor trabalha com um modelo baseado em workers.
O código de conexão em C# é praticamente igual ao do PostgreSQL. A diferença está no que acontece do lado do servidor.
using Microsoft.Data.SqlClient;

// Abre uma conexão com o SQL Server
using var connection = new SqlConnection(connectionString);
connection.Open();

// Executa o trabalho com a conexão aberta
Aqui, a aplicação em geral não precisa se preocupar em esgotar o servidor apenas porque mantém conexões abertas ou ociosas. Assim, o desenvolvedor conecta, executa o trabalho e devolve a conexão ao pool.
Conexões no SQL Server e a arquitetura de workers
Segundo o guia de arquitetura de threads e tarefas da Microsoft, uma requisição gera uma ou mais tarefas. Em seguida, cada tarefa recebe um worker, que é a representação lógica de uma thread do sistema operacional.
Cada worker, por sua vez, precisa ser colocado em um scheduler para executar. O scheduler é mapeado para um processador lógico e usa escalonamento cooperativo, com quantum máximo de 4 ms.
O detalhe que muda tudo é este: o worker só fica associado a requisições ativas. Quando a requisição termina, o worker volta para o pool, mesmo que a sessão do cliente continue aberta.
Na prática, a quantidade de conexões no SQL Server deixa de crescer na mesma proporção do consumo de recursos. Uma conexão parada ocupa pouca memória e nenhum worker dedicado.
Max worker threads e o dimensionamento automático
O número de workers disponíveis é controlado pela opção max worker threads. O valor padrão é 0, o que faz o SQL Server calcular o total automaticamente no startup, com base nos processadores lógicos.
Por exemplo, em um servidor 64 bits com até 4 CPUs lógicas, o padrão é 512 workers. Com 16 CPUs, esse número sobe para 704, conforme a tabela da documentação oficial.
A Microsoft recomenda manter o valor 0 na maioria dos casos. Afinal, quando há lentidão, a causa costuma estar em consultas longas ou bloqueios, e não na falta de workers.
Limites de conexões no SQL Server
O número que mais chama atenção de quem vem do PostgreSQL é o limite máximo. Enquanto o padrão do PostgreSQL gira em torno de 100, as conexões no SQL Server podem chegar a 32.767 por instância.
A opção user connections define esse teto. O valor padrão é 0, que libera o máximo permitido, e o próprio motor ajusta a alocação conforme a demanda.
Você pode consultar o limite diretamente com a função @@MAX_CONNECTIONS.
-- Retorna o máximo de conexões simultâneas da instância
SELECT @@MAX_CONNECTIONS AS MaxConnections;
Em uma instância configurada normalmente, o resultado é 32767. Além disso, o SQL Server também aceita até 32.767 bancos de dados por instância.
Conexões no SQL Server e no Azure SQL Database
No Azure SQL Database, os limites seguem a camada de serviço escolhida. Nas tabelas do modelo vCore, o número de sessões simultâneas chega a 30 mil, enquanto workers e logins simultâneos variam conforme a quantidade de vCores.
Por exemplo, um banco General Purpose com 2 vCores suporta 200 workers simultâneos. Com 16 vCores, esse limite sobe para 1.600, mas as 30 mil sessões continuam iguais.
Essa separação mostra bem a ideia central. Sessões são baratas, enquanto o recurso realmente disputado pelas conexões no SQL Server é o worker que executa as consultas.
Limite alto não significa recurso infinito
É importante ler esses números com cuidado. A capacidade real depende da carga, do hardware, da camada de serviço e de outros recursos do servidor.
A própria documentação da opção user connections lembra que cada conexão tem algum custo, mesmo sem uso. Portanto, abrir milhares de conexões sem necessidade continua sendo um desperdício.
O pool de conexões do ADO.NET
A outra metade da história das conexões no SQL Server fica do lado do cliente. O Microsoft.Data.SqlClient mantém um pool de conexões habilitado por padrão, sem nenhuma configuração extra.
Abrir uma conexão física envolve socket, handshake, autenticação e várias verificações. Por isso, o pool guarda conexões já abertas e as reaproveita a cada chamada de Open.
Quando a aplicação chama Close ou Dispose, a conexão física não é encerrada. Em vez disso, ela volta para o pool e fica pronta para a próxima requisição.
Como o pool organiza as conexões no SQL Server
O ADO.NET cria um pool para cada string de conexão distinta. Assim, duas strings com os mesmos valores em ordem diferente geram pools separados.
O tamanho máximo padrão do pool é 100 conexões. Se o pool lotar, a nova requisição entra em fila e aguarda até 15 segundos antes de lançar uma exceção.
Conexões ociosas saem do pool depois de cerca de 4 a 8 minutos. Do mesmo modo, o pool é limpo automaticamente quando ocorre um erro fatal, como um failover.
Você encontra todos esses detalhes na documentação oficial sobre pool de conexões do SQL Server, que vale a leitura completa.
Ajustando o pool pela string de conexão
Na maioria dos cenários, os valores padrão funcionam bem para as conexões no SQL Server. Mesmo assim, você pode ajustar o comportamento do pool com palavras-chave na string de conexão.
using Microsoft.Data.SqlClient;

// Ajusta o tamanho do pool pela string de conexão
var builder = new SqlConnectionStringBuilder
{
    DataSource = "sql-server-host",
    InitialCatalog = "OrdersDb",
    IntegratedSecurity = true,
    MinPoolSize = 5,
    MaxPoolSize = 200,
    ConnectTimeout = 15
};

await using var connection = new SqlConnection(builder.ConnectionString);
await connection.OpenAsync();
O MinPoolSize mantém um número mínimo de conexões prontas. Já o MaxPoolSize define o teto do pool para aquela string de conexão.
Abrir e fechar cedo continua sendo a regra
Mesmo com um servidor tolerante, a boa prática segue valendo. Abra a conexão o mais tarde possível e devolva o quanto antes, sempre dentro de um bloco using.
using Microsoft.Data.SqlClient;

public sealed class OrderRepository(string connectionString)
{
    public async Task<int> CountOrdersAsync(CancellationToken cancellationToken)
    {
        // A conexão volta ao pool ao sair do bloco using
        await using var connection = new SqlConnection(connectionString);
        await connection.OpenAsync(cancellationToken);

        await using var command = new SqlCommand("SELECT COUNT(*) FROM dbo.Orders;", connection);
        var result = await command.ExecuteScalarAsync(cancellationToken);

        return Convert.ToInt32(result);
    }
}
A documentação da Microsoft reforça esse ponto. Conexões que não são fechadas explicitamente podem não voltar ao pool, o que causa esgotamento do lado do cliente.
Monitorando conexões no SQL Server
Ter menos preocupação com as conexões no SQL Server não significa perder o controle. O SQL Server oferece DMVs para enxergar sessões, requisições e workers em detalhe.
A view sys.dm_exec_sessions é a equivalente mais próxima da pg_stat_activity. Com ela, você lista as sessões de usuário e o estado de cada uma.
-- Lista as sessões de usuário ativas na instância
SELECT session_id, login_name, status, host_name, program_name
FROM sys.dm_exec_sessions
WHERE is_user_process = 1;
Se precisar encerrar uma sessão específica, basta usar o comando KILL com o ID da sessão.
-- Encerra a sessão informada
KILL 57;
Para entender melhor o que cada sessão está executando, a view sys.dm_exec_requests mostra as requisições em andamento. Do mesmo modo, sys.dm_os_workers e sys.dm_os_schedulers revelam o estado dos workers.
Monitorar é exceção, não estratégia
No SQL Server, encerrar sessões deve ser o último recurso. Segundo o próprio artigo da Microsoft, gerenciar manualmente a contagem de conexões sem um motivo concreto costuma ser um antipadrão.
Ainda assim, bancos com muito volume e muita consulta merecem monitoramento de recursos. Afinal, o motor não torna os recursos infinitos, apenas evita que conexões ociosas ocupem processos dedicados.
Erros comuns com conexões no SQL Server
Mesmo com um modelo tolerante, alguns erros aparecem com frequência em aplicações .NET. Conhecer esses padrões ajuda a evitar surpresas em produção.
O primeiro erro é esquecer de fechar a conexão. Nesse caso, o pool do cliente lota antes do servidor, e a aplicação passa a receber exceções de timeout ao chamar Open.
O segundo erro é montar strings de conexão dinâmicas com valores que mudam a cada requisição. Como o ADO.NET cria um pool por string distinta, isso gera dezenas de pools pequenos e pouco reaproveitamento.
O terceiro erro é manter uma conexão aberta durante uma chamada HTTP externa ou um processamento demorado. Dessa forma, a conexão fica presa sem executar nada útil para o banco.
Por fim, muita gente confunde lentidão de consulta com falta de conexões. Antes de aumentar o Max Pool Size, vale olhar o plano de execução, os índices e os bloqueios, porque as conexões no SQL Server raramente são a causa raiz.
O que muda na migração de conexões para o SQL Server
Para quem está migrando, algumas decisões sobre conexões no SQL Server podem ser revistas. O PgBouncer, por exemplo, deixa de ser uma peça necessária, porque o pool do ADO.NET e o modelo de workers já resolvem o problema que ele atacava.
Do mesmo modo, limites artificiais de concorrência criados só para proteger o banco podem ser removidos ou relaxados. Nesse caso, vale medir antes, porque outros gargalos podem estar escondidos atrás desses limites.
Também é uma boa hora para revisar a lógica que vive no banco. Se você mantém procedures muito grandes, vale conferir como dividir uma stored procedure em componentes menores durante a migração.
Por outro lado, transações longas continuam sendo ruins em qualquer banco. No SQL Server, elas seguram locks e espaço de log, então manter transações curtas segue sendo uma boa prática.
Conclusão
A principal diferença entre os dois bancos está no modelo de execução. Enquanto o PostgreSQL dedica um processo a cada cliente, as conexões no SQL Server compartilham um pool de workers que só entra em ação quando há trabalho.
Somando isso ao pool automático do ADO.NET, o desenvolvedor .NET ganha liberdade para abrir e fechar conexões no ritmo da aplicação. Com isso, o foco volta para o que importa, que são consultas eficientes e transações curtas.
Portanto, se você está vindo do PostgreSQL, comece desligando o reflexo de vigiar cada conexão. Entenda o modelo de workers, confie no pool e monitore os recursos quando a carga realmente pedir.
FAQ
Qual é o limite de conexões no SQL Server?
O SQL Server aceita até 32.767 conexões simultâneas de usuário por instância. A capacidade real, porém, depende do hardware e da carga de trabalho.
Preciso de um pooler externo como o PgBouncer no SQL Server?
Em geral, não. O pool do ADO.NET já vem habilitado por padrão no cliente, e o servidor usa workers compartilhados em vez de processos dedicados.
Conexões ociosas consomem recursos no SQL Server?
Consomem pouco. A sessão ocupa alguma memória, mas não mantém um worker dedicado enquanto está parada.
Qual é o tamanho padrão do pool do ADO.NET?
O tamanho máximo padrão é de 100 conexões por string de conexão. Você pode alterar esse valor com a palavra-chave Max Pool Size.
Qual view substitui o pg_stat_activity no SQL Server?
A view mais próxima é a sys.dm_exec_sessions, que lista as sessões e o estado de cada uma. Para requisições em execução, use a sys.dm_exec_requests.