Verificação formal com IA: como o Claude prova código
A verificação formal deixou de ser um luxo de projetos críticos e passou a funcionar em escala com IA. Em outubro de 2026, a Anthropic e a Theorem mostraram o Claude provando propriedades de segurança em 123 bibliotecas open source.
O resultado chama atenção pelo volume e pelo método. A seguir, você entende o que foi provado, como o processo funciona, quais bugs surgiram e quais limites existem.
O que é verificação formal
A verificação formal transforma o código em um modelo matemático e tenta provar que ele sempre obedece a um conjunto de regras. Em vez de testar alguns casos, ela cobre todos os comportamentos possíveis do programa.
Se a prova falha, existe a possibilidade de um bug que viola alguma regra. Além disso, a forma como a prova falha costuma indicar onde está o problema.
O ciclo, então, é simples de descrever. Primeiro você tenta provar, depois corrige a causa da falha e repete o processo até a prova fechar.
Quando a prova fecha, a verificação formal entrega uma garantia forte. Ou seja, o código não contém nenhum bug capaz de violar aquelas regras.
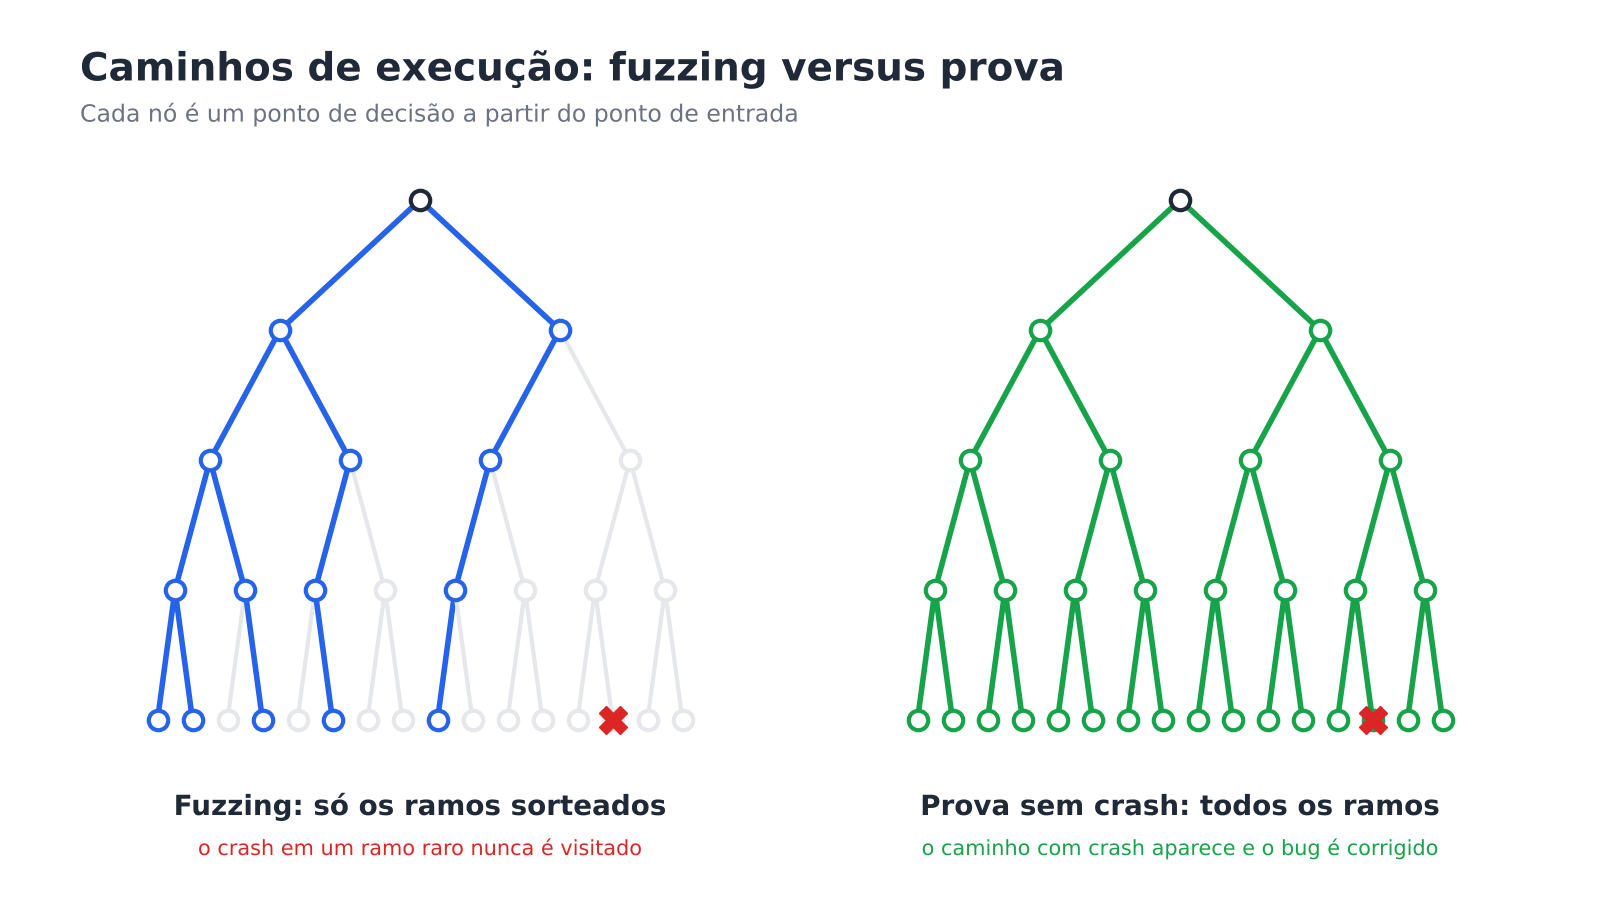
Na prática, a diferença para os testes é de natureza. Um teste cobre as entradas escolhidas, enquanto a verificação formal cobre todas as entradas do escopo.
Por que a verificação formal sempre foi cara
O problema nunca foi a ideia, e sim o custo. As provas podem ser muitas vezes maiores que o código original e exigem um conhecimento bastante especializado.
O caso do kernel seL4 ilustra bem esse desequilíbrio. A implementação levou duas pessoas-ano, enquanto a prova levou vinte pessoas-ano.
Por isso, a verificação formal ficou restrita a sistemas realmente críticos, como o software de aviônica da Airbus. Para a maior parte dos projetos, o esforço simplesmente não se pagava.
Enquanto isso, o cenário de ameaças mudou. O kernel do Linux, um dos softwares mais testados do mundo, teve recentemente mais de mil vulnerabilidades divulgadas.
Além disso, os modelos de fronteira encadeiam cada vez melhor bugs inofensivos até chegar a falhas críticas. Nesse contexto, a Anthropic defende que as defesas tradicionais já não bastam.
Como a Anthropic transformou testes em provas
Para provar que um programa está correto, primeiro é preciso definir o que significa correto. Essa definição se chama especificação, ou spec.
Em alguns casos a spec é clara, como em um decodificador PNG que segue a RFC 2083. No entanto, definir o que é um editor de texto ou um navegador correto é bem mais difícil.
A saída encontrada foi reaproveitar algo que os projetos já têm: os testes. A equipe converteu suítes de teste existentes em especificações que dizem, basicamente, que aquele teste sempre passa.
Essa ideia conversa diretamente com o que discutimos no artigo sobre spec driven development. Em ambos os casos, a especificação é a fonte da verdade, e a ferramenta trabalha para cumpri-la.
Fuzzing: força bruta sem garantia
O ponto de partida foram os fuzz tests. Nesses testes, o desenvolvedor escreve um ponto de entrada que recebe dados. Qualquer entrada que cause um crash representa um bug relevante.
Em seguida, o fuzzer gera uma quantidade enorme de entradas semialeatórias e mutadas para tentar derrubar esse ponto de entrada. Quanto mais tempo ele roda, mais bugs consegue encontrar.
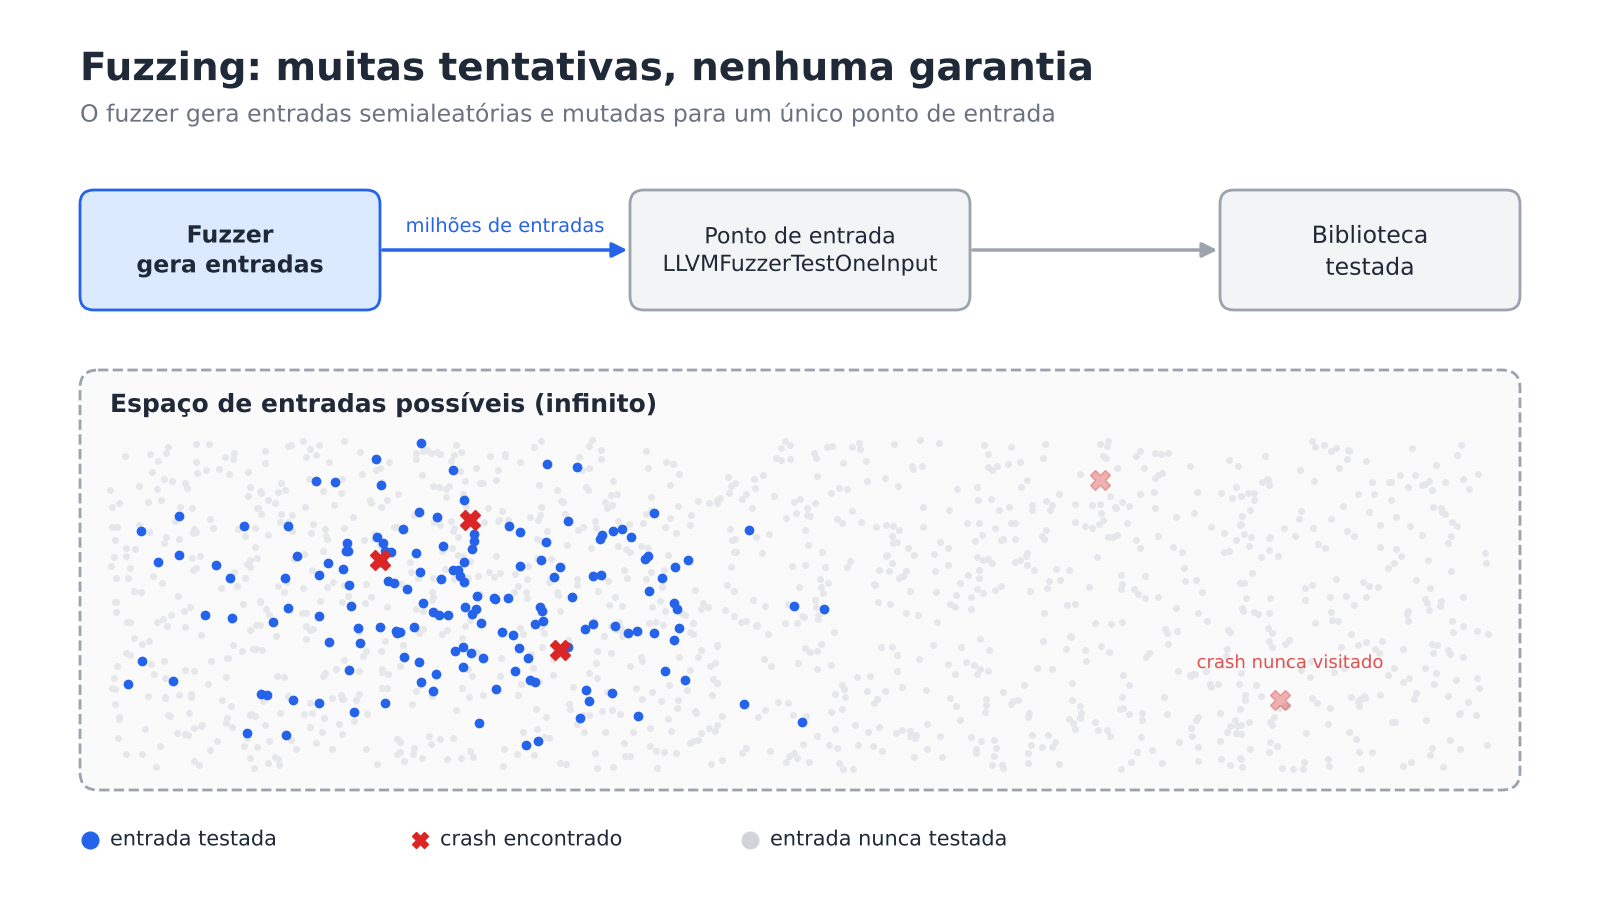
O problema é que esse processo é força bruta. Como existem infinitas entradas possíveis, não há garantia de que todos os caminhos do código sejam exercitados.
Um exemplo de ponto de entrada no estilo do OSS-Fuzz ajuda a visualizar a ideia. O teste abaixo comprime uma entrada, descomprime o resultado e exige que o dado volte idêntico:
#include <assert.h>
#include <stdint.h>
#include <string.h>
#include "compressor.h"

// Ponto de entrada chamado pelo fuzzer com cada entrada gerada
int LLVMFuzzerTestOneInput(const uint8_t *data, size_t size) {
    uint8_t compressed[MAX_COMPRESSED_SIZE(size)];
    uint8_t restored[size];

    size_t compressedSize = compress_buffer(data, size, compressed);
    size_t restoredSize = decompress_buffer(compressed, compressedSize, restored);

    // Se a ida e volta não preservar os dados, o programa cai
    assert(restoredSize == size);
    assert(memcmp(data, restored, size) == 0);
    return 0;
}
O fuzzer chama a função LLVMFuzzerTestOneInput milhões de vezes. Mesmo assim, ele só observa uma fração minúscula das entradas possíveis.
Da entrada do fuzz test à especificação
A virada está em tratar esse mesmo teste como uma afirmação matemática. A spec passa a dizer que o fuzz test não causa crash para nenhuma entrada menor que 64 MB.
Se o Claude consegue provar essa afirmação, rodar o fuzzer naquele ponto de entrada se torna desnecessário. Afinal, a prova já garante que ele nunca encontraria um bug ali.
A equipe aplicou essa verificação formal a projetos do OSS-Fuzz, iniciativa do Google de fuzzing contínuo. O OSS-Fuzz instrumenta programas C e C++ com o AddressSanitizer, que derruba o programa a cada acesso indevido à memória.
Com isso, provar que não há crash também significa provar a ausência dos erros de memória que o AddressSanitizer detecta. Essa classe de erro está entre as principais causas de vulnerabilidades em software.
O pipeline de verificação formal com Rocq
O pipeline começa compilando a biblioteca e o fuzz test para um executável RISC-V. RISC-V é uma arquitetura de processador, assim como x86 e ARM.
Depois, o executável se junta às semânticas formais de RISC-V e de Linux da Theorem e à propriedade sem crash. Dessa combinação sai, mecanicamente, a especificação da prova.
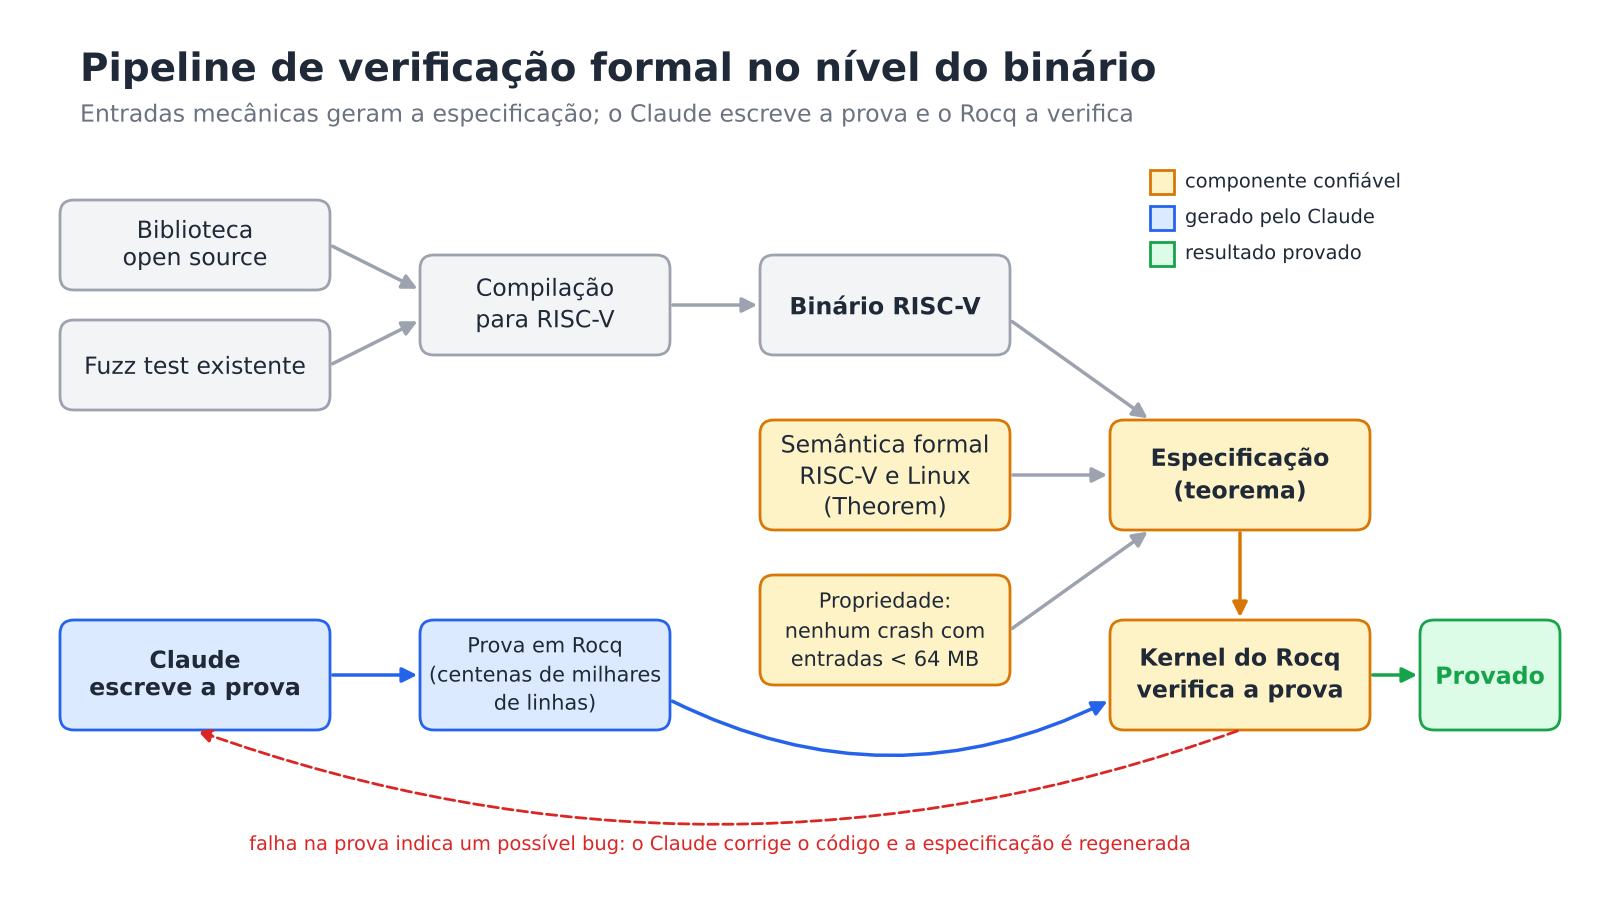
Então o Claude escreve a prova, e o kernel do assistente de provas Rocq a verifica contra a especificação. Se o verificador aceita, a propriedade está provada, desde que os componentes confiáveis estejam corretos.
Um detalhe importante é que tudo acontece no nível do binário. Assim, a abordagem dispensa reescrever o projeto em outra linguagem para conseguir uma garantia formal.
Os números da verificação formal no OSS-Fuzz
Em poucas semanas, o Claude corrigiu os bugs que encontrou e provou a ausência de crashes em 239 pontos de entrada. Eles estão espalhados por 123 bibliotecas do OSS-Fuzz.
As provas somam cerca de 180 milhões de linhas de Rocq. Uma prova típica tem cerca de 600 mil linhas para cobrir binários com mediana de 18 mil instruções RISC-V.
| Métrica | Valor |
|---|---|
| Bibliotecas do OSS-Fuzz | 123 |
| Pontos de entrada provados | 239 |
| Linhas de Rocq no total | cerca de 180 milhões |
| Tamanho típico de uma prova | cerca de 600 mil linhas |
| Mediana de instruções por binário | 18 mil instruções RISC-V |
| Limite de tamanho da entrada | 64 MB |
Segundo a Anthropic, é o primeiro esforço em larga escala de verificação formal com IA sobre software de produção no nível do assembly. O detalhamento completo está no artigo original da Anthropic.
A garantia, porém, vale sob certas premissas. O programa precisa rodar como binário estático, com uma thread e memória fixa, em RISC-V com Linux.
O que você ainda precisa confiar
Ninguém vai revisar 180 milhões de linhas de prova à mão, e isso não é necessário. O verificador do Rocq garante que a prova satisfaz a especificação.
Dessa forma, a verificação formal exige confiança em apenas três artefatos. São eles os modelos de RISC-V e de Linux, os enunciados dos teoremas e o verificador do Rocq.
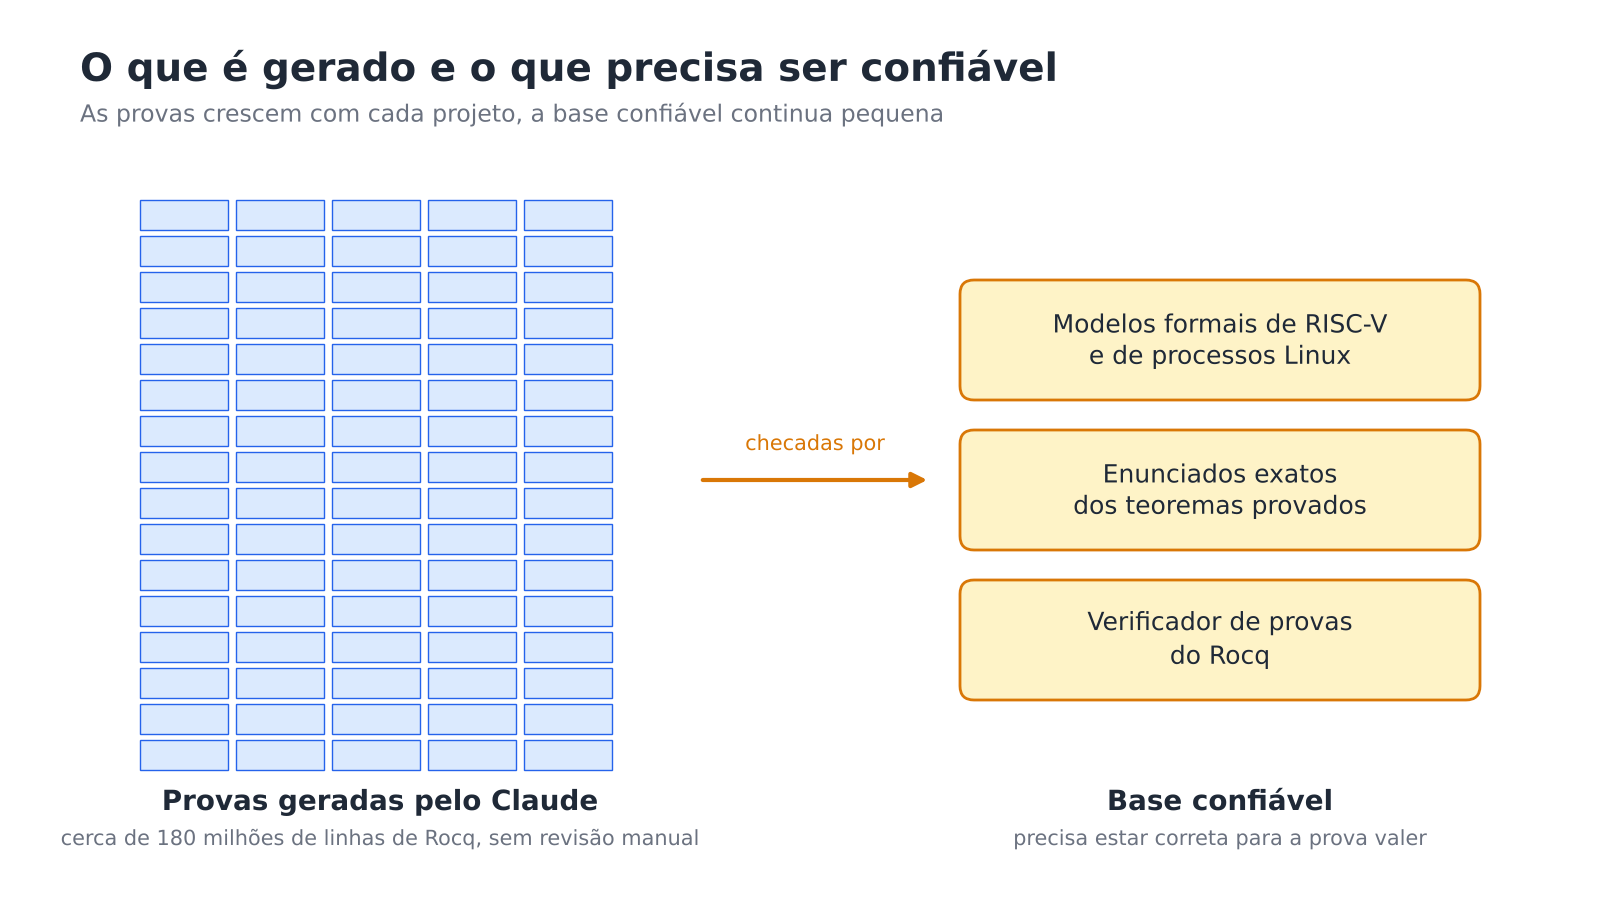
Isso não significa que as bibliotecas estejam livres de bugs. Significa que qualquer bug restante está nesses artefatos confiáveis ou fora do escopo da prova.
Reforçar esses componentes ainda dá trabalho. Contudo, é bem mais tratável do que depurar cada linha, porque a base confiável não cresce com o número de projetos.
A Anthropic publicou os componentes confiáveis que ainda não eram públicos. Também liberou provas dos fuzz tests sem correção e as specs que a equipe não conseguiu provar.
Bugs encontrados durante a verificação formal
Tentar provar centenas de pontos de entrada revelou centenas de bugs. Para não depender de uma pessoa a cada falha, a equipe deixou o próprio Claude corrigir o código.
O Claude aplicava a correção, a spec nascia de novo com o código corrigido e a prova seguia. Para evitar atalhos indevidos, a equipe penalizou correções e auditou os patches.
Muitos desses bugs dificilmente apareceriam com fuzzing. Afinal, os fuzzers mutam entradas pequenas, em geral de até 1 MB, guiados por cobertura de código.
Entre os exemplos citados pela Anthropic estão:
- um underflow em um descompressor que causava escrita fora dos limites, só com entradas de cerca de 20 MB e layout raro;
- uma leitura fora dos limites em um decodificador de imagens que exigia entrada de 64 MB e mais de 2 GB de memória;
- uma leitura fora dos limites que exigia chamadas específicas em dois handles do mesmo arquivo;
- a redescoberta da CVE-2026-56132 na libexpat, que precisava de uma entrada profundamente aninhada.
O Claude também encontrou bugs de lógica que nunca causam crash. Em uma biblioteca, um recurso que restringe quais arquivos a aplicação pode carregar nem sempre funcionava.
Portanto, mesmo quando a verificação formal não chega ao fim, a tentativa já rende bugs reais.
Provando mais do que segurança de memória
Provar que um fuzz test nunca cai vale mais do que parece. Muitos deles checam propriedades de alto nível, como ida e volta, idempotência e leis algébricas.
O fuzz test do LZO é um bom exemplo. Ele exige que comprimir e descomprimir devolva o original, então provar que ele nunca cai prova a própria propriedade.
Às vezes, a prova exige propriedades que ninguém escreveu. No caso da cpp-httplib, o Claude precisou descartar um estouro de pilha causado por recursão no destrutor de std::set.
Para isso, ele provou no código de máquina que a árvore rubro-negra da libc++ mantém profundidade logarítmica. Em outras palavras, um teste simples levou à verificação formal de um algoritmo clássico.
Outros estudos de caso de verificação formal
A conversão de fuzz tests em provas é apenas uma das frentes. A Anthropic também testou a verificação formal com LLMs em outros cenários.
No primeiro, o Claude escreveu uma spec formal da RFC 1950, que define o formato zlib. Depois, provou que o zlib do kernel Linux segue essa spec, sobre o binário x86 e com semânticas de x86 geradas por ele.
O processo se repetiu em meia dúzia de outras bibliotecas populares. Os bugs achados eram pequenos e não exploráveis, sinal de que essas bases já são quase corretas e de que a prova de ponta a ponta é viável.
No segundo, o Claude desenvolveu em Rust um interpretador para um grande subconjunto de Python. Em seguida, usou o Verus, ferramenta de verificação formal para Rust, para provar aderência à semântica do CPython.
A equipe comparou o comportamento em mais de 1,7 milhão de programas Python aleatórios. O resultado bateu com o CPython em 99,95% dos testes.
Por fim, provar propriedades simples de segurança revelou problemas em aplicações críticas. Em uma delas surgiu um bug de lógica escondido havia mais de uma década. Em um leitor de PDF, a equipe achou em uma semana tantos bugs de segurança quanto se reportam em um ano.
Custo em tokens e reuso de provas
A principal limitação prática da verificação formal com IA é o custo. As provas podem consumir centenas de milhões de tokens.
Ainda assim, há bons motivos para esperar que a eficiência melhore. A Anthropic apresenta dois deles.
Modelos novos gastam menos tokens
A equipe montou 36 pequenas tarefas de verificação a partir de código real do OSS-Fuzz. O Opus 5.5 prova metade delas com cerca de 40% menos tokens que o Opus 5.
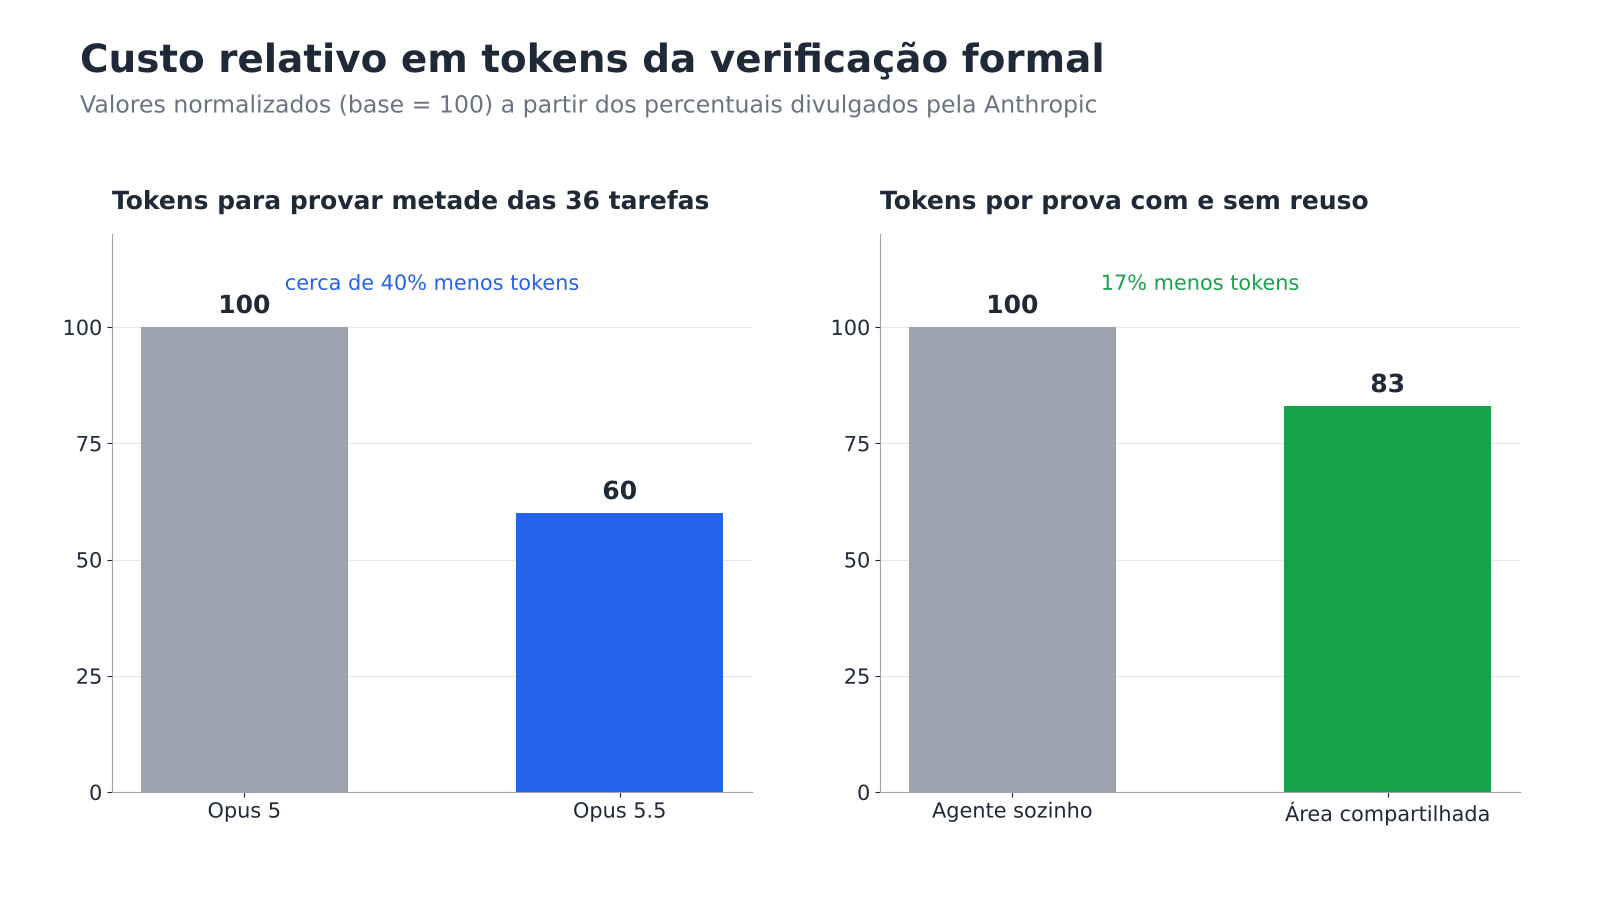
A expectativa é que essa tendência continue à medida que os modelos forem treinados em tarefas longas de verificação. Ou seja, o custo de cada prova tende a cair com cada nova geração.
Provas reaproveitáveis entre programas
Assim como o software, as provas nascem de provas menores, que tendem a ser reutilizáveis. Para medir isso, a equipe deixou os agentes copiarem provas uns dos outros.
Com esse acesso, os agentes precisaram de 17% menos tokens do que sozinhos. Além disso, o custo solo foi maior em 30 das 34 provas concluídas.
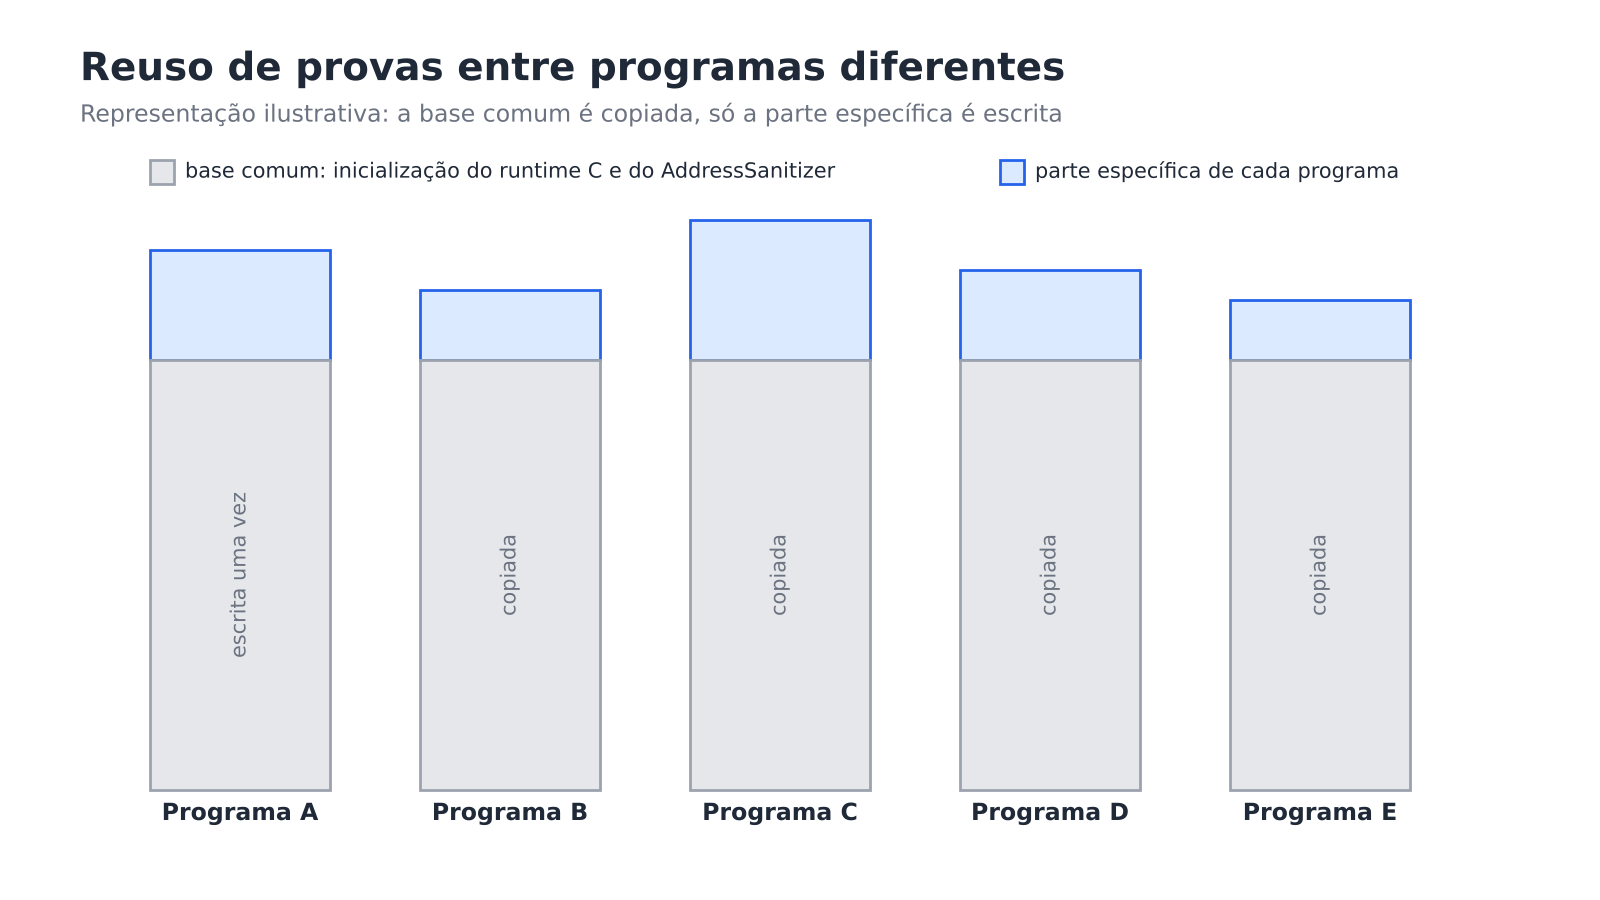
O mesmo efeito apareceu em escala no OSS-Fuzz. A maior parte de cada prova trata da inicialização do runtime C e do AddressSanitizer, presente em todo programa.
Por isso, programas muito diferentes acabam com provas bastante sobrepostas. As equipes de agentes copiavam a prova pronta de outra equipe e só adaptavam o trecho específico do seu programa.
A Anthropic compara isso ao Mathlib, biblioteca de matemática formal em Lean com quase 300 mil teoremas. Como as dependências seguem uma lei de potência, provar poucas bibliotecas compartilhadas já cobre uma fatia enorme do software.
Limitações da verificação formal com IA
Formalmente verificado não significa livre de bugs. O verificador garante que o programa satisfaz a spec, mas não consegue dizer se a spec corresponde à realidade.
Quando um bug aparece em código verificado, a causa está na diferença entre a spec e o mundo real. Por outro lado, isso indica onde procurar os bugs restantes.
A primeira lacuna é a máquina real fazer algo que o modelo não descreve. As provas tratam de binários RISC-V estáticos com musl libc. No entanto, a maioria roda essas bibliotecas em x86 ou ARM com glibc dinâmica.
A segunda lacuna é o enunciado não cobrir tudo o que importa. O AddressSanitizer não detecta todo bug de memória, e nem todo ponto de entrada passou por verificação formal.
Mesmo assim, a biblioteca inteira não estaria coberta, sobretudo com código morto. Além disso, quem chama a biblioteca pode usá-la de forma errada.
Para fechar essas lacunas, seriam necessários modelos de sistema mais próximos dos ambientes reais, como semânticas precisas de x86. Também seria preciso especificar o que cada chamador deve respeitar em cada função pública.
O que muda para quem desenvolve software
Para começar, muda a expectativa. A Anthropic recomenda experimentar verificação formal com LLMs, principalmente para quem tentou com modelos antigos e desistiu.
A Theorem, parceira do projeto, se ofereceu para rodar o mesmo pipeline em outros projetos open source. Ela também publicou uma skill do Claude para ajudar desenvolvedores a começar a verificar o próprio código.
Outra mudança é na estratégia de dependências. No nível do binário, cada pacote passa pela verificação formal uma única vez e serve a todos os seus dependentes.
A Theorem descreve um roteiro para verificar todo o ecossistema Nix, incluindo componentes críticos como glibc, OpenSSL e cURL. Se esse roteiro avançar, boa parte do software que usamos diariamente ganhará garantias formais sem precisar ser reescrita.
Para quem escreve testes hoje, a mensagem é animadora. Os fuzz tests e as asserções que você já mantém podem virar a especificação de uma prova amanhã.
Conclusão: verificação formal como parte do fluxo
A Anthropic aposta que a verificação formal vai ficar tão prática quanto o fuzzing é hoje. Assim como tipos estáticos e frameworks de teste, ela deve virar parte do processo.
O experimento com 123 bibliotecas mostra que isso já não é ficção. Testes existentes viraram especificações, o Claude escreveu as provas, e o Rocq garantiu que elas estavam corretas.
Ao mesmo tempo, as limitações são claras e conhecidas. A garantia vale para o modelo de máquina, para os enunciados escolhidos e para o escopo definido, nada além disso.
Em um mundo em que modelos encontram vulnerabilidades com facilidade, provar propriedades de segurança deixa de ser excesso de zelo. Portanto, vale começar a olhar para os seus testes como especificações e acompanhar de perto essa evolução.
FAQ
O que é verificação formal de software?
É uma técnica que modela o código matematicamente e prova que ele sempre respeita um conjunto de regras. Ela cobre todas as entradas dentro do escopo, e não apenas os casos testados.
Verificação formal substitui os testes?
Não substitui, ela se apoia neles. No experimento da Anthropic, os fuzz tests existentes viraram a especificação que o Claude precisou provar.
Código formalmente verificado está livre de bugs?
Não. Ele está livre dos bugs que violam a especificação provada, mas ainda pode ter falhas nos modelos confiáveis ou fora do escopo da prova.
Por que as provas foram feitas sobre RISC-V?
Porque a Theorem tinha semânticas formais de RISC-V e de processos Linux prontas para modelar o binário. A Anthropic aponta semânticas de x86 como um próximo passo para chegar mais perto dos ambientes reais.
Quem precisa revisar as 180 milhões de linhas de prova?
Ninguém precisa revisar à mão. O verificador do Rocq checa as provas, e a confiança fica concentrada nos modelos formais, nos enunciados e no próprio verificador.
Como começar a usar verificação formal com IA?
A Theorem publicou uma skill do Claude para ajudar desenvolvedores a verificar o próprio código. Ela também se ofereceu para rodar o pipeline em outros projetos open source.