Queue-based load leveling: o que é e quando falha
O queue-based load leveling é o padrão que coloca uma fila entre quem produz trabalho e o serviço que processa esse trabalho. Ele nivela a carga ao longo do tempo, mas não reduz a quantidade de trabalho que chega.
Essa diferença parece pequena no dia em que a fila entra em produção. No entanto, ela aparece semanas depois, quando a fila amanhece mais funda a cada dia e ninguém sabe dizer quando o problema começou.
Este artigo usa como base o texto de Irina Dominte sobre o tema e a documentação oficial da Microsoft. Por isso, os exemplos usam Azure Service Bus e Azure Functions, mas o raciocínio vale para qualquer broker.
O que é queue-based load leveling
No queue-based load leveling, a tarefa publica uma mensagem com os dados que o serviço precisa, e a fila guarda essa mensagem até o serviço buscá-la. Dessa forma, o serviço consome no próprio ritmo, mesmo quando muitos produtores enviam ao mesmo tempo.
A documentação do Queue-Based Load Leveling pattern no Azure Architecture Center lista três benefícios. Primeiro, a disponibilidade melhora, porque atrasos no serviço não afetam o produtor de imediato.
Em seguida, a escalabilidade melhora, pois o número de filas e de consumidores pode variar conforme a demanda. Por fim, o custo cai, porque você dimensiona os consumidores para a carga média, e não para o pico.
Esse terceiro benefício esconde a armadilha principal. Afinal, a palavra média carrega uma condição que quase ninguém verifica antes de adotar o queue-based load leveling.
Uma fila é um amortecedor, não uma bomba
Pense em uma cozinha que prepara 60 pratos por hora. Na sexta, às 20h, chegam 100 pedidos dentro de uma hora.
Os pedidos se acumulam, os cozinheiros mantêm o ritmo e os clientes esperam um pouco mais. Depois das 21h, os pedidos caem para 30 por hora, e por volta das 22h30 a pilha some.
Agora mude um número só: chegam 70 pedidos por hora, a noite toda. Nesse caso, a pilha nunca desaparece.
Às 23h, há 40 pedidos esperando, e cada pedido novo espera 40 minutos. Além disso, cada hora acrescenta mais dez pedidos à pilha.
Nos dois cenários, a pilha fez o mesmo trabalho: guardou os pedidos até os cozinheiros chegarem neles. Em outras palavras, a fila armazena o excesso e o entrega depois, como um amortecedor.
O solavanco continua lá, apenas espalhado no tempo. Portanto, se os consumidores não acompanham a chegada na média, a fila transforma trabalho extra em espera, e essa espera só cresce.
A aritmética de um pico de tráfego
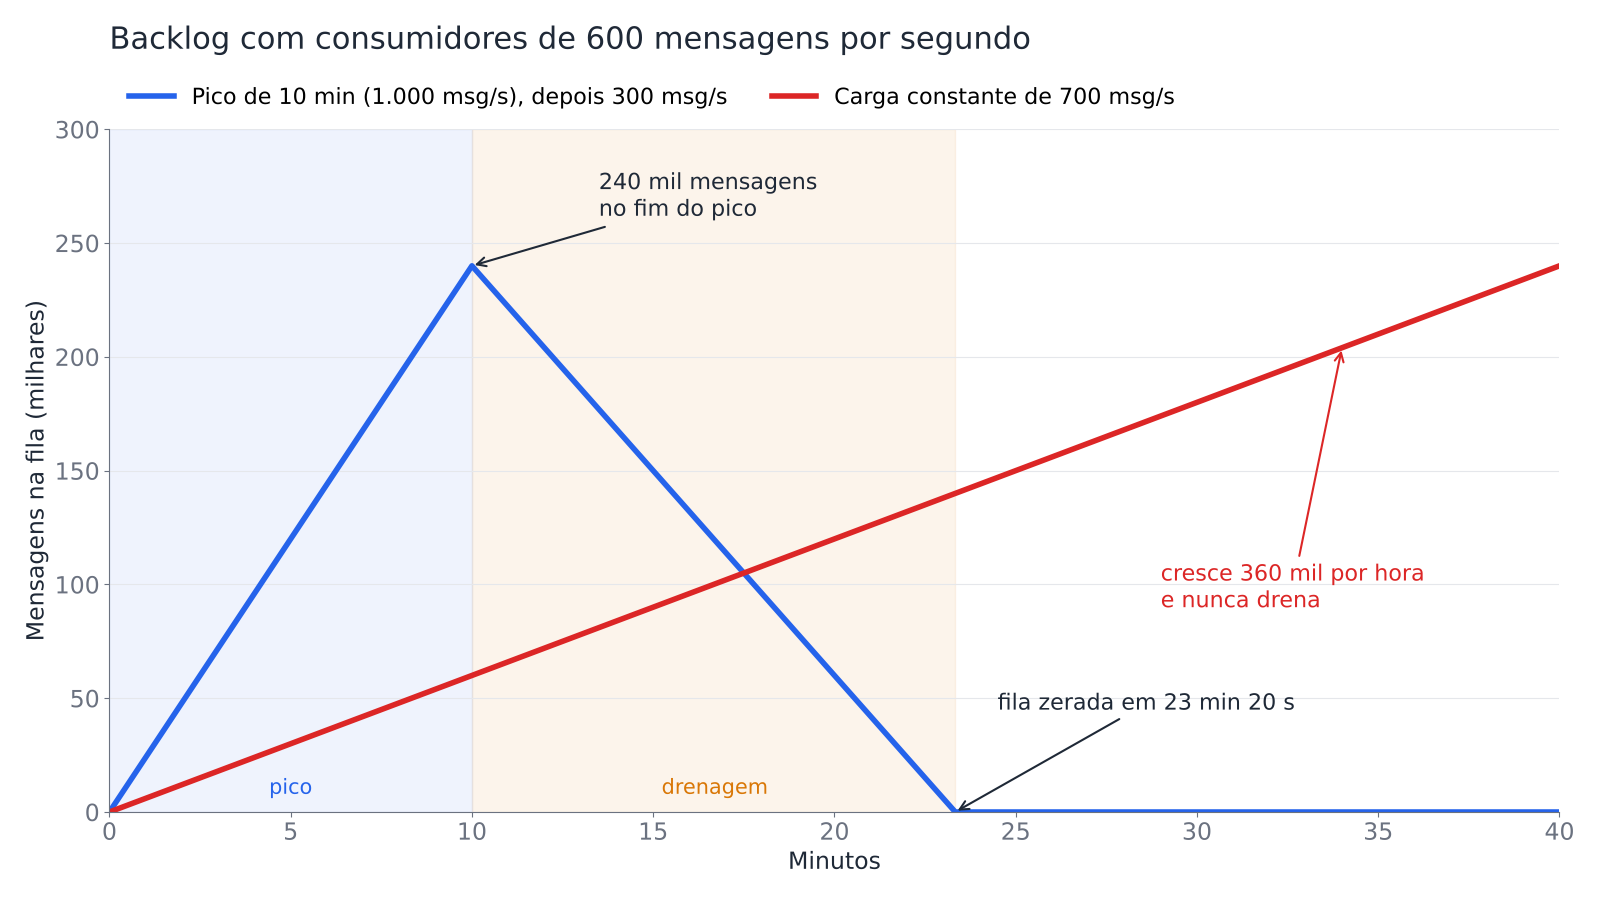
Coloque números no cenário, agora em termos de mensageria. Os consumidores processam 600 mensagens por segundo, e um pico envia 1.000 mensagens por segundo durante dez minutos.
Depois disso, o tráfego volta ao normal de 300 mensagens por segundo. Todo projeto de queue-based load leveling deveria fazer esta conta antes do deploy:
During the spike:  1,000 in, 600 out, for 600 s
Backlog:           (1,000 - 600) x 600 = 240,000 messages
Last one in waits: 240,000 / 600 = 400 s (6 min 40 s)

After the spike:   300 in, 600 out -> drains at 300 msg/s
Drain time:        240,000 / 300 = 800 s (13 min 20 s)
Ou seja, um pico de dez minutos custa 23 minutos e 20 segundos de latência elevada. A drenagem dura mais do que o próprio pico.
Headroom define o tempo de drenagem
A velocidade da drenagem depende do headroom, ou seja, da capacidade menos o tráfego normal. Com 300 mensagens por segundo de folga, as 240 mil mensagens somem em pouco mais de 13 minutos.
Se o tráfego normal fosse 550 em vez de 300, a folga cairia para 50. Nesse caso, o mesmo backlog levaria 80 minutos para zerar.
Além disso, se outro pico chegar antes disso, o sistema começa o próximo evento já atrasado. Por isso, o headroom pesa tanto quanto a capacidade bruta no queue-based load leveling.
A média que justifica o queue-based load leveling
O argumento clássico do queue-based load leveling diz que você pode dimensionar os consumidores pela carga média. Isso continua verdadeiro, mas a pegadinha mora justamente na média.
Naquela hora do exemplo, a média fica em (600.000 + 900.000) / 3.600, cerca de 417 mensagens por segundo. Como 417 fica bem abaixo de 600, a fila cumpre o papel dela.
Contudo, essa média já inclui o pico. Assim, a capacidade ainda precisa de folga acima dela para drenar o backlog antes do próximo pico.
Quando a média já é o problema
Agora mude um único número. O tráfego fica em 700 mensagens por segundo, de forma constante, contra os mesmos 600 de capacidade.
Isso significa 100 mensagens extras por segundo, ou 360 mil por hora. Dessa forma, cada hora de tráfego acrescenta dez minutos à espera.
Depois de um dia, a fila guarda 8,64 milhões de mensagens, e a mais nova espera quatro horas. Nada drena, porque não existe período calmo para drenar.
Nesse cenário, o queue-based load leveling deixa de nivelar e passa apenas a acumular.
Nenhuma fila resolve isso, e uma fila maior também não. Em outras palavras, uma fila sem limite apenas adia a falha.
O Azure Service Bus, por exemplo, acaba dizendo não por você. Quando a fila atinge o limite de tamanho, o envio falha com uma ServiceBusException cujo motivo vale QuotaExceeded.
try
{
    await sender.SendMessageAsync(new ServiceBusMessage(payload));
}
catch (ServiceBusException ex) when (ex.Reason == ServiceBusFailureReason.QuotaExceeded)
{
    // a fila chegou ao limite: este é o pior momento para descobrir
    logger.LogError(ex, "Queue {QueueName} reached its size quota", queueName);
    throw;
}
A documentação de exceções do Service Bus mostra um exemplo com o limite padrão de 1 GB por entidade. Em geral, esse erro vem de duas causas: a dead-letter queue lotada ou um consumidor que parou de ler.
Monitorando um queue-based load leveling saudável
Observe a direção da profundidade da fila, e não um limite fixo. Uma profundidade de 50 mil mensagens durante uma promoção pode ser normal.
Por outro lado, uma profundidade maior no fim de cada dia do que no começo indica problema. Esse sinal de tendência importa mais do que qualquer número isolado no queue-based load leveling.
Também vale medir a idade das mensagens diretamente. No Service Bus, a propriedade EnqueuedTime de ServiceBusReceivedMessage mostra quanto tempo cada mensagem esperou, e esse número traduz o que o usuário sente.
processor.ProcessMessageAsync += async args =>
{
    var waited = DateTimeOffset.UtcNow - args.Message.EnqueuedTime;

    // a idade da mensagem é a latência que o usuário percebe
    queueAgeHistogram.Record(waited.TotalSeconds);

    await HandleOrderAsync(args.Message.Body);
    await args.CompleteMessageAsync(args.Message);
};
Quando a média fica alta demais, restam duas saídas honestas. Você adiciona capacidade real ou descarta trabalho no produtor, antes que ele entre na fila.
Na prática, um 503 com o cabeçalho Retry-After na porta de entrada trata o cliente melhor do que uma espera de quatro horas sem aviso. O exemplo abaixo usa Minimal APIs no .NET 10 para recusar pedidos quando a fila passa de um limite.
app.MapPost("/orders", async (CreateOrderRequest request, QueueHealth health, ServiceBusSender sender) =>
{
    // descarta trabalho antes de ele entrar na fila
    if (health.ActiveMessageCount > health.MaxAcceptedDepth)
    {
        return Results.Problem(
            title: "Service is busy, try again later",
            statusCode: StatusCodes.Status503ServiceUnavailable,
            extensions: new Dictionary<string, object?> { ["retryAfterSeconds"] = 60 });
    }

    await sender.SendMessageAsync(new ServiceBusMessage(BinaryData.FromObjectAsJson(request)));
    return Results.Accepted();
});
Nesse exemplo, QueueHealth representa um serviço seu que lê periodicamente a contagem de mensagens ativas. Além disso, um middleware pode transformar o campo retryAfterSeconds no cabeçalho Retry-After da resposta.
Escalar os consumidores pode mover a sobrecarga
A correção óbvia no queue-based load leveling é escalar os consumidores pela profundidade da fila. Assim, mais instâncias leem da mesma fila e cada uma pega a próxima mensagem, no padrão Competing Consumers.
O Azure Functions faz isso nativamente. Com o target-based scaling em um gatilho do Service Bus, o número desejado de instâncias vem do tamanho da fila dividido por maxConcurrentCalls, que vale 16 por padrão.
Aplique essa conta ao backlog de 240 mil mensagens. A fórmula pede 15 mil instâncias.
No plano Flex Consumption, porém, o limite padrão fica em 100 instâncias, então você recebe 100. Isso significa 1.600 handlers simultâneos, ou mais em planos com vários núcleos, onde maxConcurrentCalls se multiplica pelo número de núcleos.
Todos esses handlers agora atacam o banco de dados que o queue-based load leveling deveria proteger. Ou seja, a fila esvaziou, mas a sobrecarga apenas desceu um nível.
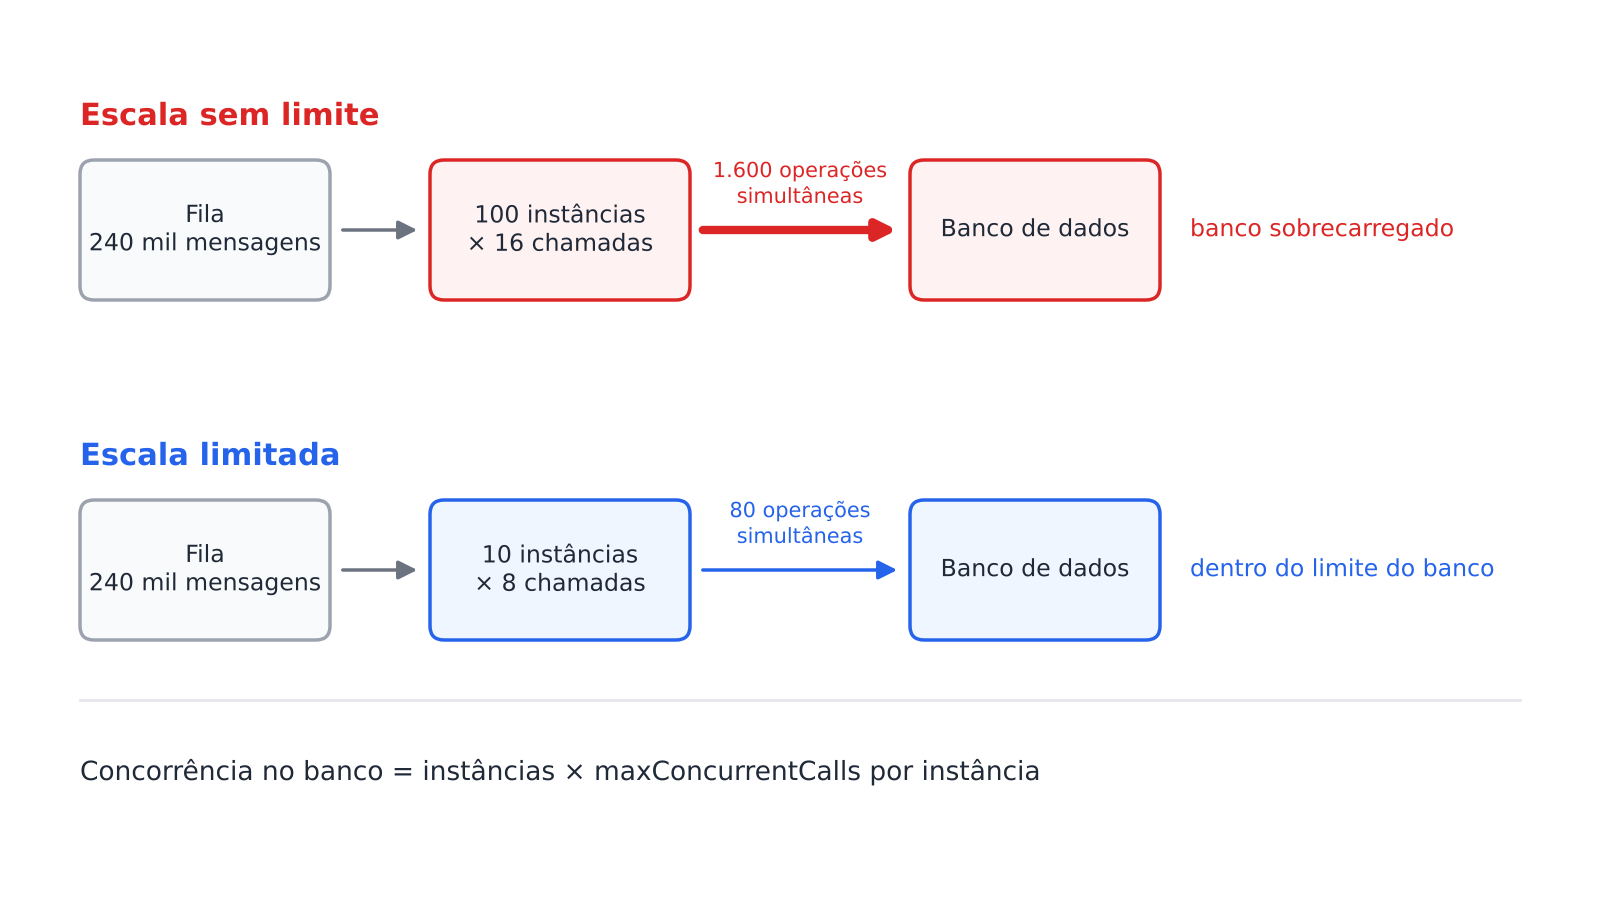
A própria documentação da Microsoft faz o mesmo alerta. Segundo ela, o autoscaling sem um teto na taxa agregada dos consumidores só transfere a sobrecarga para as dependências seguintes.
Como limitar a escala no Azure Functions
O número que importa é instâncias vezes concorrência por instância. Além disso, esse número precisa nascer da capacidade do banco ou do serviço que fica atrás dos consumidores.
No Azure Functions, isso significa limitar os dois valores. Primeiro, o maxConcurrentCalls no host.json define quantos handlers rodam em cada instância.
{
  "version": "2.0",
  "extensions": {
    "serviceBus": {
      "maxConcurrentCalls": 8
    }
  }
}
Em seguida, o limite de instâncias define quantas cópias do app podem existir. No Flex Consumption, você usa o parâmetro --maximum-instance-count.
# limita o app a 10 instâncias por grupo de funções
az functionapp scale config set \
  --resource-group orders-rg \
  --name orders-worker \
  --maximum-instance-count 10
Nos planos Consumption e Premium, a configuração equivalente se chama functionAppScaleLimit. Com 10 instâncias e 8 chamadas cada, o banco recebe no máximo 80 operações simultâneas.
Sem esse teto, o queue-based load leveling devolve ao banco o mesmo pico que deveria absorver.
Portanto, multiplique os dois números antes de confiar em qualquer um deles.
Se você já usa o Functions com gatilho do Service Bus, o artigo sobre Serverless e Azure Functions revisa os gatilhos disponíveis.
Mensagens que envelhecem no queue-based load leveling
Algumas mensagens envelhecem bem. Um e-mail de fatura enviado com 20 minutos de atraso continua útil.
Por outro lado, uma notificação dizendo que o motorista chega em dois minutos vira ruído depois de 20 minutos. Lembre dos 6 minutos e 40 segundos do exemplo do pico.
Se o dado de uma mensagem vale por menos tempo do que a pior drenagem do seu queue-based load leveling, processá-lo tarde desperdiça trabalho. Pior ainda, esse processamento atrasa a drenagem das mensagens que ainda importam.
Por isso, o Service Bus permite definir o TimeToLive de cada mensagem.
var message = new ServiceBusMessage(payload)
{
    // notificação de chegada só faz sentido nos próximos 5 minutos
    TimeToLive = TimeSpan.FromMinutes(5)
};

await sender.SendMessageAsync(message);
Nos tiers Standard e Premium, o TTL padrão equivale ao maior valor possível de um inteiro de 64 bits, ou seja, na prática nada expira se você não pedir. No tier Basic, o padrão e também o máximo ficam em 14 dias.
Além disso, o broker descarta as mensagens expiradas, a menos que a fila tenha o DeadLetteringOnMessageExpiration ligado. Ative essa opção e trate o que chegar à dead-letter queue.
Por exemplo, você pode avisar o usuário que a operação demora mais do que o normal. Também pode mandar o trabalho para um caminho mais lento, como um e-mail no lugar de uma notificação push.
TTL não substitui um prazo no handler
A expiração no Service Bus funciona de forma preguiçosa. O broker pode remover as mensagens expiradas mais tarde, e uma mensagem já travada por um consumidor continua no processamento.
Assim, trate o TTL como regra de limpeza. Se você precisa de um prazo rígido, confira esse prazo também dentro do handler.
processor.ProcessMessageAsync += async args =>
{
    // a mensagem pode chegar travada mesmo depois de expirar
    if (args.Message.ExpiresAt < DateTimeOffset.UtcNow)
    {
        await args.DeadLetterMessageAsync(args.Message, "Expired", "Message reached the handler after its deadline");
        return;
    }

    await SendArrivalNotificationAsync(args.Message.Body);
    await args.CompleteMessageAsync(args.Message);
};
Vale lembrar que a maioria das filas entrega cada mensagem pelo menos uma vez. Por isso, o handler também precisa de idempotência, tema do artigo Quando o código idempotente mente para você.
Quando o queue-based load leveling é a resposta errada
Se quem chama precisa de uma resposta síncrona, o queue-based load leveling não ajuda. Afinal, essa chamada espera o mesmo backlog que todo o resto.
Seis minutos e 40 segundos atrás de um pico funcionam bem para um e-mail. No entanto, para uma requisição HTTP que alguém observa na tela, esse tempo parece uma eternidade.
Além disso, a fila só nivela carga se o buffer sobreviver. Se o broker não persiste as mensagens, uma queda leva o backlog junto, e no exemplo do pico isso significa 240 mil mensagens.
Um queue-based load leveling com fila em memória, como um Channel<T> dentro da API, sofre exatamente desse problema. O artigo sobre Background Services em C# e .NET explica quando ela basta e quando você precisa de um broker externo.
Por fim, se o tráfego é baixo e estável, a fila não nivela nada. Nesse caso, você ganha apenas um broker para operar e mais um salto para depurar.
Checklist antes de adotar queue-based load leveling
Antes de colocar uma fila para nivelar carga, calcule alguns números. Esse trabalho leva poucos minutos e evita semanas de investigação.
- Taxa média de chegada, em um período que inclua os picos. Se ela fica igual ou acima da vazão sustentada dos consumidores, pare, porque a fila não vai ajudar.
- Headroom, ou seja, capacidade menos tráfego normal. Divida o pior backlog esperado por ele e você tem o tempo de drenagem.
- Limite do serviço seguinte. Mantenha instâncias vezes concorrência por instância abaixo do que o banco ou a API aguenta.
- Validade das mensagens. Defina
TimeToLivepara tudo que perde valor, com dead-lettering na expiração.
Em seguida, crie alertas para a tendência da profundidade e da idade das mensagens ao longo de horas. Com isso, você enxerga a fila que não drena antes de o QuotaExceeded aparecer.
Também decida com antecedência o que o produtor faz quando a fila fica funda demais. Essa decisão sai muito melhor numa terça à tarde do que no meio de um incidente.
Conclusão
Uma fila é uma promessa de fazer o trabalho depois. O queue-based load leveling funciona enquanto esse depois de fato chega, ou seja, enquanto o pico termina e os consumidores têm folga para alcançar a fila.
Quando a média de chegada passa da capacidade, a fila apenas acumula promessas que o sistema não consegue cumprir. Por isso, faça as contas de média, headroom, limite do serviço seguinte e validade antes de adotar o padrão.
Depois, monitore a tendência e a idade das mensagens, e não só a profundidade. Assim, o queue-based load leveling continua sendo um amortecedor, e não uma fila que nunca esvazia.
FAQ
O queue-based load leveling aumenta a vazão do sistema?
Não. A fila apenas guarda o excesso e o entrega depois, então a vazão continua limitada pela capacidade dos consumidores.
Como saber se a minha fila nunca vai drenar?
Compare a taxa média de chegada, medida em um período que inclua os picos, com a vazão sustentada dos consumidores. Se a chegada fica igual ou acima, a profundidade cresce de forma contínua.
Escalar consumidores automaticamente resolve o backlog?
Resolve o backlog, mas pode transferir a sobrecarga para o banco ou a API seguinte. Limite instâncias e concorrência por instância com base no que essa dependência aguenta.
O TimeToLive garante que uma mensagem expirada não será processada?
Não. A expiração no Service Bus é preguiçosa e não afeta mensagens já travadas, então confira o prazo também no handler.
Quando não usar uma fila para nivelar carga?
Quando quem chama precisa de resposta síncrona e de baixa latência, ou quando o tráfego é baixo e estável. Também evite brokers que não persistem as mensagens.