ID gerado pelo banco: por que gerar o ID antes de salvar
O ID gerado pelo banco parece a escolha mais natural em qualquer aplicação, porque o cliente chama a API, a API insere o registro e o banco devolve o identificador. Contudo, essa decisão aparentemente pequena limita o design do sistema assim que surgem processamento assíncrono, mensageria, fluxos de trabalho longos e múltiplas fronteiras de serviço.
Este artigo usa como base a análise de Derek Comartin, do CodeOpinion, sobre um sistema de logística com envios (shipments). Além disso, ele mostra como aplicar a mesma ideia no .NET com Guid.CreateVersion7, Minimal APIs, mensagens e EF Core.
O que é um ID gerado pelo banco
Um ID gerado pelo banco é o identificador que o próprio banco de dados cria no momento do insert. Na prática, ele aparece como uma coluna de autoincremento, uma sequência, um IDENTITY ou um UUID com valor padrão definido no schema.
O fluxo típico tem três passos: o cliente chama a API, a API insere o registro e o banco devolve o identificador. Em seguida, a API repassa esse valor ao cliente na resposta.
Quem trabalhou bastante com CRUD conhece esse modelo de cor. Por isso, quase ninguém questiona a origem do identificador.
A pergunta central do artigo de Comartin é justamente essa: por que o banco de dados é o responsável por gerar o ID? De fato, a resposta muda bastante a forma como o sistema inteiro se organiza.
Onde o ID gerado pelo banco começa a atrapalhar
O problema não aparece em telas simples de cadastro. Ele surge quando a criação de um recurso deixa de ser uma operação instantânea e passa a envolver regras de negócio, filas e outros serviços.
Criar algo nem sempre é um CRUD
No exemplo de logística, criar um envio não se resume a gravar uma linha. Antes de concluir a operação, o sistema precisa validar a transportadora, checar conformidade, calcular previsões de chegada, definir a rota e aplicar várias regras de negócio.
Esse processo não é necessariamente curto. Portanto, manter tudo dentro da requisição HTTP deixa o cliente esperando e aumenta o risco de timeouts.
Processamento assíncrono e a pergunta sobre o ID
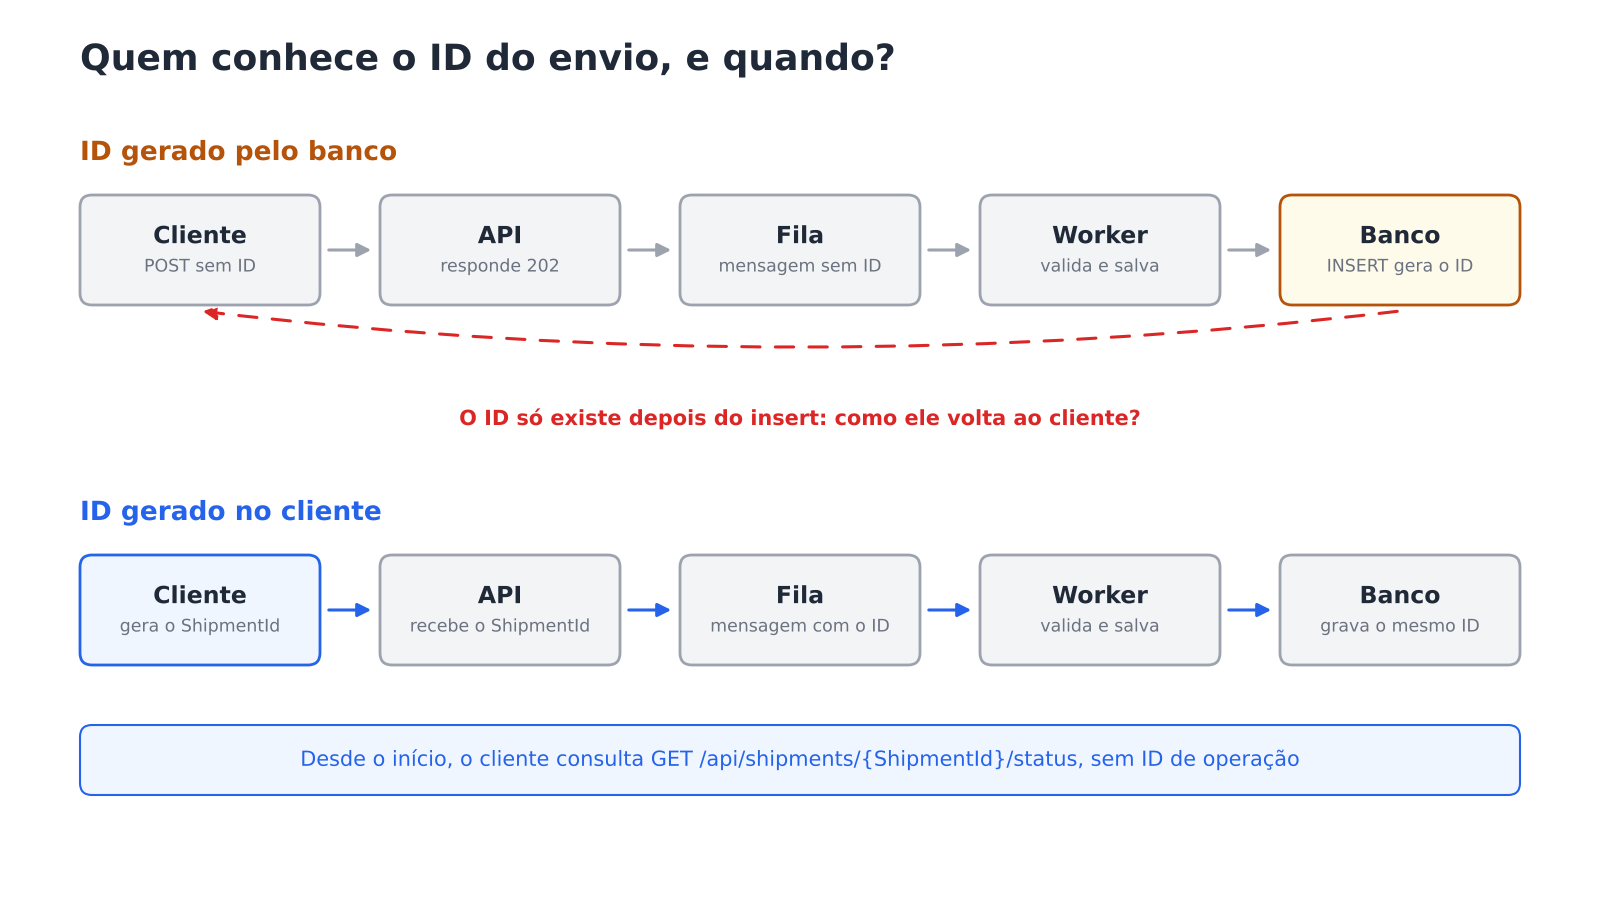
A alternativa natural é processar o pedido de forma assíncrona. Assim, a API coloca uma mensagem em uma fila e responde ao cliente que o envio será criado, sem esperar o processamento terminar.
Depois disso, um worker consome a mensagem, executa as validações e, por fim, salva o envio no banco. Nesse ponto aparece a pergunta incômoda: se o ID gerado pelo banco só existe depois do insert, como o cliente descobre o identificador do envio?
Contornos comuns para o ID gerado pelo banco
Existem duas saídas frequentes para esse impasse. A primeira é criar um registro inicial no banco, só para obter o identificador antes de enfileirar o restante do trabalho.
A segunda é gerar um ID de operação separado e devolvê-lo imediatamente ao cliente. Em seguida, o cliente consulta o status dessa operação até descobrir o ID real do envio.
Ambas funcionam, mas Comartin aponta o que realmente está acontecendo. Em outras palavras, o time está desenhando o sistema ao redor do fato de que o ID gerado pelo banco nasce tarde demais.
O registro inicial adiciona uma ida extra ao banco e um estado intermediário que precisa ser tratado. Já o ID de operação cria um segundo identificador para o mesmo conceito, com o mapeamento entre os dois para manter.
Dar identidade ao envio antes de persistir
A proposta é simples: gerar o ID antes mesmo de enviar a requisição. Dessa forma, o cliente cria um UUID, um GUID ou qualquer identificador que ele já conhece.
Quando o cliente chama a API, o ID do envio segue no corpo da requisição. Da mesma forma, a mensagem que vai para a fila também carrega esse identificador.
O processamento continua assíncrono, com as mesmas validações e regras de negócio de antes. Contudo, agora o cliente já sabe a identidade do envio antes de qualquer gravação.
A distinção fundamental é esta: o envio tem uma identidade antes de chegar ao banco de dados. Com isso, o ID gerado pelo banco deixa de ser um pré-requisito para o restante do fluxo.
Exemplo com Minimal API e fila
O exemplo abaixo mostra uma Minimal API que recebe o identificador do cliente. Em vez de inserir o envio, o endpoint apenas publica um comando em uma fila e responde com 202 Accepted.
// O cliente envia o ID do envio junto com os dados
public sealed record CreateShipmentRequest(
    Guid ShipmentId,
    Guid OrderId,
    Guid CarrierId);

// Comando que segue para a fila com o mesmo identificador
public sealed record CreateShipment(
    Guid ShipmentId,
    Guid OrderId,
    Guid CarrierId);

app.MapPost("/api/shipments", async (
    CreateShipmentRequest request,
    IMessageBus bus) =>
{
    if (request.ShipmentId == Guid.Empty)
        return Results.BadRequest("ShipmentId is required.");

    await bus.SendAsync(new CreateShipment(
        request.ShipmentId,
        request.OrderId,
        request.CarrierId));

    // O cliente já conhece o ID e pode consultar o status
    return Results.Accepted($"/api/shipments/{request.ShipmentId}/status");
});
A interface IMessageBus representa qualquer transporte de mensagens, como Azure Service Bus, RabbitMQ ou NServiceBus. O ponto importante é que o ShipmentId atravessa todas as etapas sem depender do insert.
Do lado do worker, o handler recebe o comando, aplica as regras e grava o envio com o identificador recebido. Portanto, nenhuma etapa precisa esperar o banco devolver um valor.
public sealed class CreateShipmentHandler(AppDbContext db)
{
    public async Task HandleAsync(CreateShipment command, CancellationToken ct)
    {
        // Idempotência: a mesma mensagem pode chegar mais de uma vez
        var exists = await db.Shipments.AnyAsync(s => s.Id == command.ShipmentId, ct);
        if (exists)
            return;

        var shipment = Shipment.Create(
            command.ShipmentId,
            command.OrderId,
            command.CarrierId);

        db.Shipments.Add(shipment);
        await db.SaveChangesAsync(ct);
    }
}
Consultando o status com o ID conhecido
Como o cliente já tem o identificador, ele pode consultar o status do envio mesmo antes do processamento terminar. Nesse caso, a API responde que o envio ainda está pendente, sem precisar de um segundo ID.
app.MapGet("/api/shipments/{shipmentId:guid}/status", async (
    Guid shipmentId,
    AppDbContext db) =>
{
    var shipment = await db.Shipments
        .AsNoTracking()
        .FirstOrDefaultAsync(s => s.Id == shipmentId);

    // Ainda não processado: o envio existe apenas na fila
    return shipment is null
        ? Results.Ok(new { shipmentId, status = "Pending" })
        : Results.Ok(new { shipmentId, status = shipment.Status.ToString() });
});
Correlação no fluxo sem depender do ID gerado pelo banco
O processamento assíncrono é apenas a forma mais fácil de ilustrar a ideia. No entanto, Comartin mostra que o impacto vai bem além disso.
Considere o fluxo simplificado de um envio em uma aplicação de logística. Primeiro, um pedido fica disponível para despacho; depois, uma transportadora é atribuída; então, o despacho do pedido cria o envio.
A partir daí surgem vários eventos ao longo do tempo. O caminhão chega ao embarcador, a carga é carregada, o veículo chega ao destinatário, a carga é descarregada e, por fim, a entrega é concluída.
Esse ciclo de vida inteiro costuma envolver consumidores diferentes, em serviços diferentes. Além disso, esses serviços também publicam eventos relacionados ao mesmo envio.
A pergunta então é como correlacionar todos esses eventos. A resposta é o ID do envio, definido logo no início do fluxo e conhecido por todos os participantes.
Se o sistema dependesse do ID gerado pelo banco, cada serviço precisaria esperar o insert do despacho para saber como se referir ao envio. Assim, a correlação ficaria presa à ordem das gravações.
Não existe um serviço de envio
Comartin propõe olhar o problema por outro ângulo. Segundo ele, não existe um serviço de envio, nem uma única fronteira dona do conceito de envio.
O que existe são várias fronteiras que participam do mesmo fluxo de trabalho. Cada uma entende o envio à sua maneira e tem capacidades específicas sobre ele.
O despacho cuida da execução do envio, com os marcos de chegada, carregamento, descarregamento e entrega. Já o rastreamento acompanha onde o veículo está, por onde ele passa e quais são as previsões de chegada.
O faturamento se preocupa em pagar a transportadora e cobrar ou faturar o cliente. Por sua vez, a gestão de transportadoras cuida de conformidade, seguros e outras informações da transportadora.
Ou seja, não há um conceito único de envio compartilhado por todo o sistema. Cada fronteira conhece a sua visão específica do envio, ligada às demais pelo mesmo identificador.
Nesse cenário, o ID gerado pelo banco de uma única fronteira não serve como referência para as outras. Afinal, cada fronteira tem o próprio banco e não deveria depender da sequência de outra.
Eventos magros em vez de eventos gordos
Do ponto de vista do usuário, porém, existe apenas um envio. Ele não se importa com qual serviço guarda cada dado; ele quer ver todas as informações para fazer o seu trabalho.
Uma tela de envio pode exigir dados gerais, rastreamento, localização atual, previsões de chegada, motorista, transportadora, cliente e conformidade. Por isso, a reação comum é perguntar se todos esses dados precisam morar em um único serviço.
Um caminho frequente é publicar eventos grandes para distribuir os dados. Nesse modelo, o evento OrderDispatched carrega todos os detalhes do envio, para que os outros serviços tenham acesso a eles.
// Evento "gordo": replica o schema do envio para todos os consumidores
public sealed record OrderDispatched(
    Guid ShipmentId,
    Guid OrderId,
    string CarrierName,
    string DriverName,
    string OriginAddress,
    string DestinationAddress,
    DateTimeOffset EstimatedArrival,
    decimal FreightAmount,
    IReadOnlyList<ShipmentItem> Items);
Outra opção comum é usar change data capture para publicar as alterações. Contudo, a ideia acaba sendo a mesma: publicar praticamente o schema inteiro do envio por meio de eventos.
Muitas vezes, esse modelo nasce justamente do ID gerado pelo banco. Como só o despacho conhece o identificador, ele precisa distribuir tudo para que os outros serviços consigam trabalhar.
Comartin sugere voltar à origem do problema, que é gerar o ID logo no início. Se todos os participantes já conhecem o identificador, o evento pode carregar só isso.
// Evento "magro": apenas o fato e a identidade
public sealed record OrderDispatched(Guid ShipmentId);
Nenhum detalhe do envio segue na mensagem. Em outras palavras, o evento informa somente qual envio foi despachado, e cada consumidor decide o que fazer com base nos dados que já possui.
Compondo a tela a partir de várias fronteiras
Na tela de envio, o usuário continua vendo um único envio. Entretanto, os dados vivem em fronteiras definidas, cada uma responsável pela sua parte.
O rastreamento guarda as informações de rastreamento, e a gestão de transportadoras guarda os dados da transportadora. Da mesma forma, o CRM guarda os dados do cliente, a conformidade guarda os dados de conformidade e o despacho guarda as informações gerais da execução.
A interface é uma visão unificada. Ainda assim, isso não significa que todos os dados precisem estar no mesmo lugar.
Essa composição só funciona porque nenhuma fronteira depende do ID gerado pelo banco de outra. Todas compartilham a identidade definida no começo do fluxo.
No lado dos comandos, quando o despacho publica que o pedido foi despachado, outras partes do fluxo podem começar. Rastreamento, conformidade, CRM e faturamento já entendem o ID do envio, porque participaram de etapas anteriores.
Por exemplo, ao selecionar a transportadora, ela pode já estar associada ao rastreamento. Então, o rastreamento passa a seguir o veículo sem precisar de dados copiados de um serviço central.
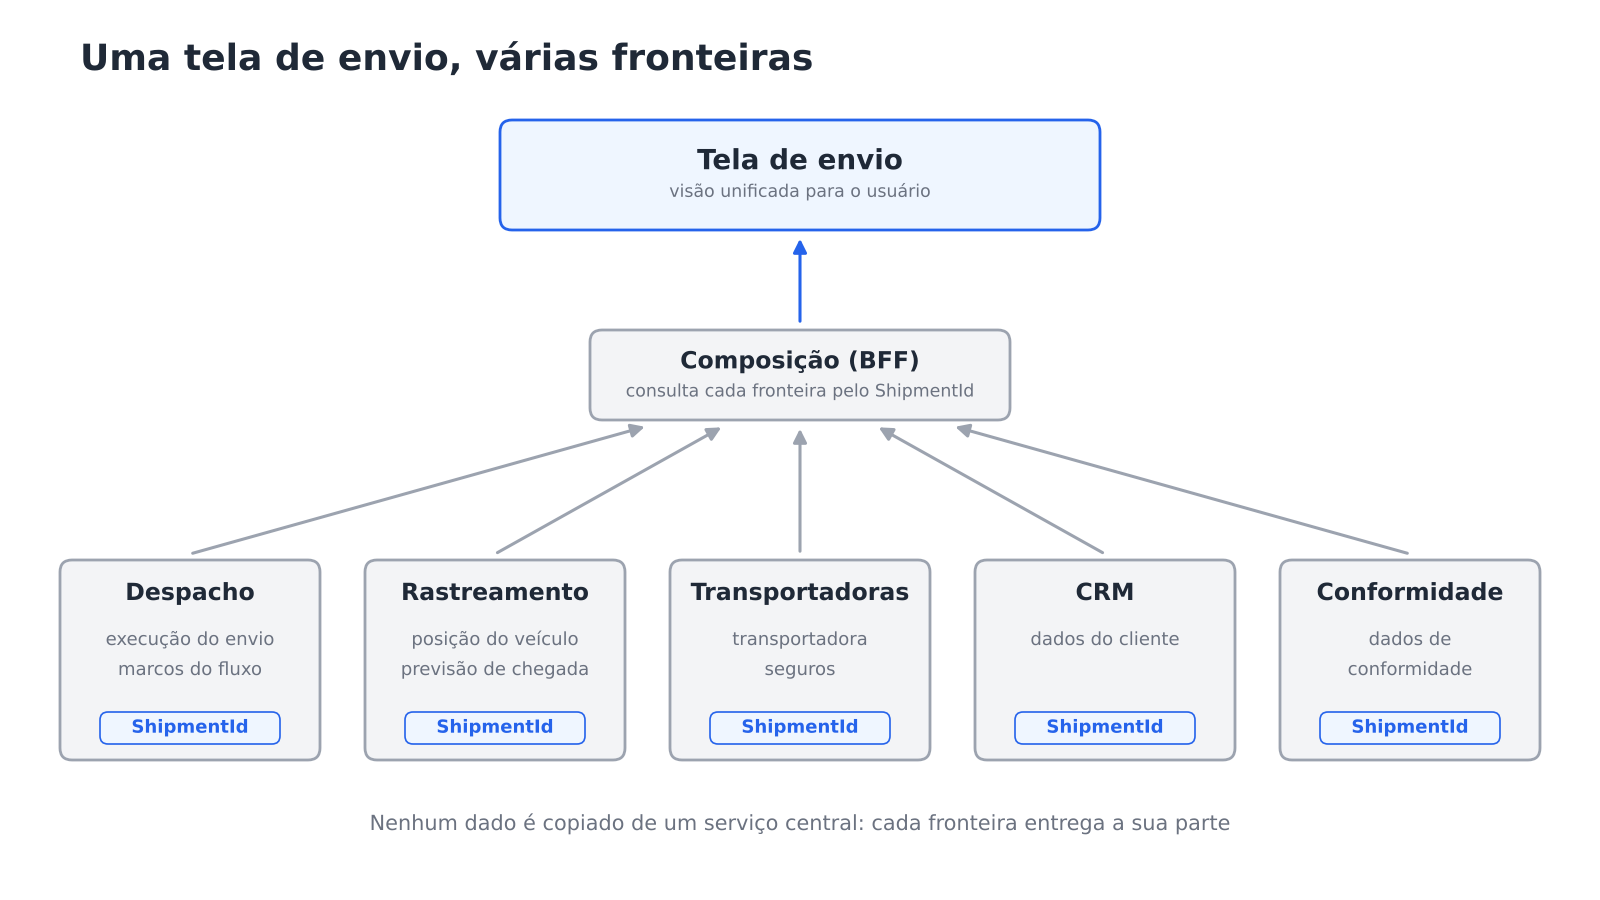
Na prática, a composição pode acontecer em um BFF ou em um gateway que consulta cada fronteira pelo mesmo identificador. O trecho abaixo mostra a ideia de forma simplificada.
app.MapGet("/api/shipments/{shipmentId:guid}", async (
    Guid shipmentId,
    IDispatchClient dispatch,
    ITrackingClient tracking,
    ICarrierClient carriers,
    ICustomerClient customers) =>
{
    // Cada fronteira responde pela sua parte do envio
    var general = dispatch.GetAsync(shipmentId);
    var position = tracking.GetAsync(shipmentId);
    var carrier = carriers.GetByShipmentAsync(shipmentId);
    var customer = customers.GetByShipmentAsync(shipmentId);

    await Task.WhenAll(general, position, carrier, customer);

    return Results.Ok(new ShipmentView(
        general.Result,
        position.Result,
        carrier.Result,
        customer.Result));
});
Gerar o ID na aplicação em vez do ID gerado pelo banco
O artigo original não depende de uma tecnologia específica, mas a ideia se aplica bem ao ecossistema .NET. A seguir, dois pontos práticos ajudam a trocar o ID gerado pelo banco por um identificador definido pela aplicação ou pelo cliente.
UUID v4 ou UUID v7
O Guid.NewGuid() gera um UUID versão 4, composto quase inteiramente por dados aleatórios. Ele resolve a unicidade, mas a ordem aleatória costuma fragmentar índices B-tree em chaves primárias.
A partir do .NET 9, o método Guid.CreateVersion7 gera um UUID versão 7, definido pela RFC 9562. Esse formato reserva parte do valor para um timestamp, então os identificadores seguem uma ordem natural de criação.
// UUID v4: totalmente aleatório
var randomId = Guid.NewGuid();

// UUID v7: ordenável pelo momento de criação
var shipmentId = Guid.CreateVersion7();

// Com TimeProvider, o timestamp fica controlável em testes
var testableId = Guid.CreateVersion7(timeProvider.GetUtcNow());
No front-end, o navegador já oferece crypto.randomUUID() para gerar um UUID v4. Assim, o cliente consegue criar o identificador sem nenhuma biblioteca extra.
Configurando o EF Core para aceitar o ID da aplicação
Por convenção, o EF Core configura chaves primárias do tipo int, long ou Guid para gerar valores no insert quando a aplicação não informa nenhum. Por isso, vale deixar explícito que o identificador vem de fora.
public sealed class ShipmentConfiguration : IEntityTypeConfiguration<Shipment>
{
    public void Configure(EntityTypeBuilder<Shipment> builder)
    {
        builder.ToTable("shipments");
        builder.HasKey(x => x.Id);

        // O ID chega pronto do cliente ou da aplicação
        builder.Property(x => x.Id).ValueGeneratedNever();
    }
}
Com ValueGeneratedNever, o EF Core nunca tenta gerar o valor da chave. Dessa forma, o modelo deixa claro para qualquer pessoa do time que a identidade nasce antes da persistência.
Cuidados ao abandonar o ID gerado pelo banco
Gerar o identificador no cliente traz liberdade, mas também exige alguns cuidados. O primeiro é nunca confiar cegamente no valor recebido.
A API deve rejeitar Guid.Empty e manter uma restrição de unicidade na chave primária. Assim, um cliente com defeito não consegue sobrescrever ou duplicar registros de outros.
O segundo cuidado é a idempotência. Como o mesmo comando pode chegar mais de uma vez pela fila, o handler precisa reconhecer um ID já processado e ignorar a repetição.
O terceiro ponto envolve exposição de dados. Um UUID v7 embute o momento de criação, então não use esse formato quando o horário de criação for uma informação sensível.
Por fim, o ID gerado pelo banco continua válido em muitos cenários, como chave interna ou numeração legível para humanos. Telas simples de cadastro, sem filas nem fronteiras, raramente sofrem com essa limitação.
ID gerado pelo banco: uma decisão pequena com grande impacto
Trocar o ID gerado pelo banco por um identificador criado antes da requisição inicial parece um detalhe de implementação. No entanto, Comartin defende que essa escolha pode ter um efeito profundo no design do sistema.
Ela não ajuda apenas no processamento assíncrono. Também importa quando o sistema tem várias fronteiras e o time começa a fazer perguntas como estas:
- Quem é dono de cada dado?
- Como as fronteiras se comunicam?
- De que forma os dados chegam compostos ao usuário?
- Como as partes de um fluxo de trabalho se correlacionam?
- Quão acopladas essas partes estão?
Gerar o identificador antecipadamente não deixa o sistema desacoplado de forma automática. Ainda assim, gerá-lo no momento certo, como parte do fluxo, remove restrições que muitas vezes passam despercebidas.
Além disso, essa decisão dá mais visibilidade sobre como o design do sistema deveria realmente ser. Para quem quer aprofundar esses temas, a carreira de arquitetura de software do balta.io reúne cursos de mensageria, Event-Driven e microsserviços com .NET.
Conclusão sobre o ID gerado pelo banco
O ID gerado pelo banco funciona bem enquanto a criação de um recurso é uma operação curta e síncrona. Porém, quando entram filas, workers e várias fronteiras, ele obriga o time a criar registros provisórios, IDs de operação e eventos gordos.
Gerar o identificador antes de salvar resolve essas tensões na origem. Com isso, o cliente consulta o status sem esperar o insert, os eventos carregam apenas a identidade e cada fronteira compõe a sua parte da visão do usuário.
No .NET, essa mudança custa pouco: Guid.CreateVersion7 para gerar o valor e ValueGeneratedNever para informar o EF Core. O ganho está no design, porque a identidade passa a ligar todo o fluxo de trabalho.
FAQ
O ID gerado pelo banco é uma má prática?
Não. Ele continua adequado para operações simples e síncronas, mas limita o design quando há processamento assíncrono, mensageria e várias fronteiras.
É seguro deixar o cliente gerar o ID?
Sim, desde que a API rejeite valores vazios, mantenha uma restrição de unicidade na chave e trate mensagens repetidas de forma idempotente.
Devo usar UUID v4 ou UUID v7?
O UUID v7 costuma ser melhor como chave primária, porque é ordenável pelo tempo de criação. Use o v4 quando não quiser expor o momento de criação no identificador.
Gerar o ID antes deixa o sistema desacoplado?
Não automaticamente. Ele remove restrições e facilita a correlação, mas o desacoplamento depende de como as fronteiras e a posse dos dados são definidas.
Como o EF Core lida com IDs gerados pela aplicação?
Basta informar um valor diferente do padrão na chave antes de salvar. Para deixar a intenção explícita, configure a propriedade com ValueGeneratedNever.