
Git: Por dentro do encanamento

Entender o Git por dentro é descobrir que uma das ferramentas mais poderosas do desenvolvimento de software se apoia em ideias extremamente simples. Neste artigo, vamos criar um repositório pequeno, abrir a pasta .git e seguir o caminho que leva de um commit até o conteúdo de um arquivo.
A base deste texto é o capítulo 10 do livro oficial Pro Git, chamado Git Internals. De fato, depois de ler esse capítulo, fica claro como o Git consegue ser tão eficiente usando conceitos tão diretos.
O que significa olhar o Git por dentro
O Git é um sistema de controle de versão que gerencia código fonte de uma forma bem simples. Basicamente, ele guarda a lista de pastas e arquivos do diretório monitorado e também uma cópia do conteúdo desses arquivos.
Para saber se algo mudou, o Git compara o conteúdo da pasta monitorada com as cópias que ele mesmo fez. Ou seja, todo o histórico de um projeto nasce dessa comparação entre o estado atual e as cópias guardadas.
Por isso, olhar o Git por dentro significa estudar onde essas cópias ficam, em que formato elas são gravadas e como uma aponta para a outra. Em outras palavras, é trocar a visão de usuário pela visão de quem constrói a ferramenta.
Comandos de encanamento e de porcelana
O livro Pro Git divide os comandos em dois grupos, inspirados em uma analogia com instalações sanitárias. Os comandos de porcelana (porcelain) são os que usamos no dia a dia, como git add, git commit e git checkout.
Já os comandos de encanamento (plumbing) fazem o trabalho de baixo nível e foram pensados para serem combinados em scripts. Por exemplo, git cat-file, git hash-object, git update-index e git write-tree pertencem a esse grupo.
Nesse sentido, os comandos de porcelana são apenas uma fachada amigável sobre o encanamento. Por isso, quem domina o Git por dentro entende o que cada git commit realmente faz no disco.
Criando um repositório para investigar
Para nos aprofundarmos nessa ideia, vamos seguir um tutorial simples, no qual criaremos, manipularemos e investigaremos um pequeno repositório. Os comandos abaixo criam uma pasta chamada git-demo, inicializam um repositório, criam um arquivo de texto e realizam um commit.
mkdir git-demo
cd git-demo
git init
echo "File 1 content" > file1.txt
git add *
git commit -m "Create file 1"
Quando o Git inicializa um repositório, ele apenas cria um diretório oculto chamado .git. Em seguida, adiciona dentro dele as pastas e os arquivos que usa para monitorar as mudanças da pasta git-demo.
Se você ainda não tem o Git instalado e configurado, o artigo sobre Git e GitHub: instalação, configuração e primeiros passos mostra o processo completo. Depois disso, basta repetir os comandos acima no seu terminal.
A pasta .git por dentro
Depois de criar o repositório, entre na pasta .git e observe o que existe lá dentro. A imagem abaixo mostra a listagem original obtida no Windows.
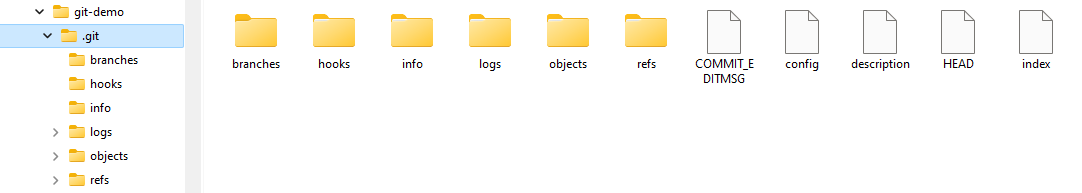
Segundo o Pro Git, quatro entradas formam o coração do repositório: o arquivo HEAD, o arquivo index, a pasta objects e a pasta refs. Além delas, o arquivo config guarda as configurações locais e a pasta hooks armazena scripts executados em eventos como commit e push.
A pasta objects guarda todo o conteúdo do banco de dados do Git. Enquanto isso, a pasta refs guarda ponteiros para commits, como branches e tags.
Por sua vez, o arquivo index representa a área de preparação (staging area). Ou seja, é nele que o git add registra o que vai entrar no próximo commit.
O arquivo HEAD e a agulha do toca discos
Algumas dessas pastas e arquivos são essenciais para entender o funcionamento interno do Git, e o primeiro deles é o arquivo HEAD. Esse arquivo funciona como a agulha em um toca discos de vinil.
A agulha sempre aponta para um único local, e a música tocada depende dessa posição. Da mesma forma, o HEAD indica para onde o Git está "olhando" no momento.
Se você abrir esse arquivo em qualquer editor de texto, verá o conteúdo abaixo.
ref: refs/heads/master
Esse tipo de conteúdo recebe o nome de referência simbólica, porque aponta para outra referência, e não para um commit. Quando você faz checkout de um commit específico, porém, o HEAD passa a guardar o hash diretamente, e o Git chama esse estado de detached HEAD.
Branches são arquivos de texto
O texto do arquivo HEAD aponta para o arquivo master, que fica dentro da pasta .git/refs/heads. Vale observar que master é o nome da branch deste exemplo, então o seu HEAD pode ser diferente se a sua branch tiver outro nome.
Desde a versão 2.28, inclusive, o Git permite definir o nome da branch inicial com a configuração init.defaultBranch. Assim, muitos repositórios novos começam com main em vez de master.
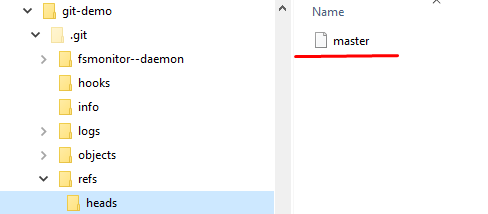
Se você exibir o conteúdo do arquivo master com cat no Linux e no macOS, ou com Get-Content no PowerShell, verá algo parecido com o trecho abaixo. Esse número grande é o hash que identifica o commit que acabamos de fazer.
cd .git/refs/heads
cat master
a0e9142e71e26205fd8eb3ed34c9f90f6ddc4a02
Portanto, o arquivo HEAD aponta para o nome da branch, enquanto o arquivo da branch aponta para o último commit feito nela. Em outras palavras, uma branch no Git por dentro é só um arquivo de 41 bytes com um hash e uma quebra de linha.
Isso explica por que criar uma branch é tão rápido. Afinal, o Git só precisa gravar um novo arquivo de texto com o hash do commit atual.
O seu hash será diferente do mostrado aqui, porque o commit inclui seu nome, seu e-mail e a data exata da criação. Ainda assim, a estrutura será idêntica à deste exemplo.
Inspecionando um commit com o Git por dentro
Agora vamos usar o hash do arquivo master para encontrar o nosso commit. Os commits ficam dentro da pasta .git/objects, junto com todos os outros objetos do repositório.
O Git usa os dois primeiros caracteres do hash para nomear a pasta e o restante para nomear o arquivo. Assim, o commit a0e9142e... fica em .git/objects/a0/e9142e71e26205fd8eb3ed34c9f90f6ddc4a02.
A imagem a seguir veio da execução original deste tutorial, na qual o hash do commit começava com 18. Por isso, ali o commit aparece dentro da pasta 18, em um arquivo cujo nome começa com 86.
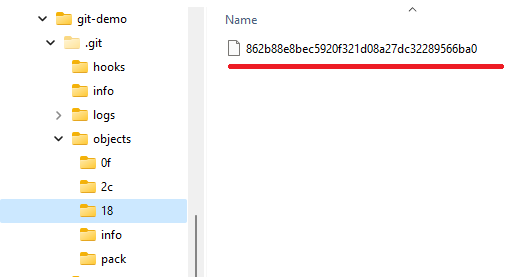
Essa divisão em subpastas existe por desempenho. Afinal, muitos sistemas de arquivos ficam lentos quando uma única pasta guarda milhares de arquivos.
Como o Git grava o objeto por dentro
Se você abrir esse arquivo com cat ou Get-Content, verá um monte de caracteres sem sentido. Isso acontece porque o Git concatena um cabeçalho ao conteúdo e depois compacta tudo com a biblioteca zlib.
x☺µŽA
Â0►=÷§{↨KÒ4K♥"‚gñà
O cabeçalho segue o formato tipo tamanho, seguido de um byte nulo. Por exemplo, um arquivo com o texto File 1 content vira a sequência blob 15\0File 1 content\n antes da compactação.
Além disso, o nome do arquivo é o hash SHA-1 dessa sequência completa, com cabeçalho e conteúdo. Por isso, o mesmo conteúdo sempre gera o mesmo hash, em qualquer máquina.
Lendo o commit com git cat-file
Felizmente, temos o comando git cat-file para ver o conteúdo desse arquivo. Ele lê o objeto, o descompacta e mostra o conteúdo sem o cabeçalho que o Git adicionou.
O parâmetro -p formata a saída de acordo com o tipo do objeto. Já o -t mostra apenas o tipo, e o -s mostra o tamanho em bytes.
git cat-file -t a0e9142e71e26205fd8eb3ed34c9f90f6ddc4a02
commit

git cat-file -p a0e9142e71e26205fd8eb3ed34c9f90f6ddc4a02
tree 8ff408626ef83a2f175fc84e04ac5526883a9864
author Oséias da Silva Martins <user@domain.com> 1651669200 -0300
committer Oséias da Silva Martins <user@domain.com> 1651669200 -0300

Create file 1
Esse comando fornece várias informações interessantes, e vale comentar cada uma delas de baixo para cima:
Create file 1é a mensagem que colocamos no commit.authorecommittervêm das configuraçõesuser.nameeuser.email, seguidas da data em segundos desde 1970 e do fuso horário.treeé a parte mais interessante, pois aponta para o objeto que lista as pastas e os arquivos do diretóriogit-demo.
Para ver suas próprias configurações de nome e e-mail, use o comando git config -l. Inclusive, quem alterna entre contas pessoais e profissionais pode seguir o guia sobre mais de uma configuração do Git em um único computador.
Inspecionando a árvore do commit
O último trecho mostrou um hash ao lado da palavra tree. Como esse hash começa com 8f, sabemos que o objeto tree está dentro da pasta .git/objects/8f.
Na execução original, o hash da tree começava com 0f, e a imagem abaixo mostra exatamente essa pasta.
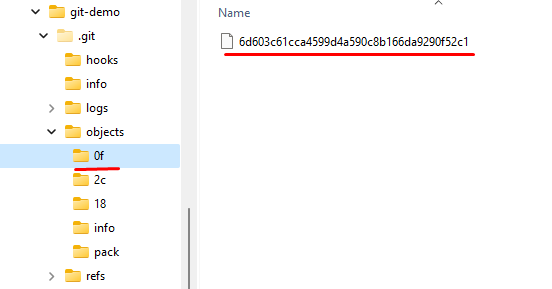
Se passarmos o hash da tree para o git cat-file, conseguimos ver o seu conteúdo. Perceba que o comando retornou quatro campos em uma única linha.
git cat-file -p 8ff408626ef83a2f175fc84e04ac5526883a9864
100644 blob f0808425c2d357546aff8c1f7b4bfae1319c2c16	file1.txt
O último campo é o nome do arquivo que criamos, enquanto o penúltimo é outro hash. Já o segundo campo indica o tipo do objeto, que aqui é um blob.
Os modos de uma entrada da tree
O primeiro campo, 100644, representa o modo do arquivo. Segundo o Pro Git, o Git usa poucos modos: 100644 para arquivos comuns, 100755 para executáveis e 120000 para links simbólicos.
Quando a entrada é uma subpasta, o modo vira 040000 e o tipo vira tree. Dessa forma, uma tree pode apontar para outras trees e representar qualquer hierarquia de diretórios.
Note também que o nome do arquivo fica na tree, e não no blob. Por isso, renomear um arquivo sem alterar o conteúdo gera uma tree nova, mas reaproveita o mesmo blob.
Encontrando o conteúdo do arquivo
Esse é o último hash do nosso percurso. Ele corresponde ao objeto que guarda uma cópia do conteúdo do file1.txt, dentro da pasta .git/objects/f0.
Vamos usar o git cat-file uma última vez para ver o conteúdo desse objeto. O comando retorna exatamente o mesmo texto que gravamos no arquivo da pasta git-demo.
git cat-file -p f0808425c2d357546aff8c1f7b4bfae1319c2c16
File 1 content
Para confirmar que o hash depende só do conteúdo, podemos calculá-lo sem criar commit nenhum. O comando git hash-object faz exatamente isso, e a opção -w ainda grava o objeto no banco de dados.
echo "File 1 content" | git hash-object --stdin
f0808425c2d357546aff8c1f7b4bfae1319c2c16
Como o resultado bate com o hash do blob, fica provado que o Git endereça objetos pelo conteúdo. Por isso, o livro descreve o Git por dentro como um sistema de arquivos endereçável por conteúdo, com uma interface de controle de versão por cima.
O que muda no segundo commit
Até aqui temos um único commit, então vale observar o que acontece quando o histórico cresce. Para isso, vamos criar um segundo arquivo e fazer mais um commit.
echo "File 2 content" > file2.txt
git add file2.txt
git commit -m "Create file 2"

git cat-file -p HEAD
tree ce9c0e0a5d4a164a0a408c1eb59bade4ee2b2e89
parent a0e9142e71e26205fd8eb3ed34c9f90f6ddc4a02
author Oséias da Silva Martins <user@domain.com> 1651669500 -0300
committer Oséias da Silva Martins <user@domain.com> 1651669500 -0300

Create file 2
Agora o commit tem uma linha parent, que aponta para o commit anterior. Assim, cada commit conhece o seu antecessor, e o histórico vira uma cadeia que o Git percorre de trás para frente.
Em seguida, veja a nova tree do commit.
git cat-file -p HEAD^{tree}
100644 blob f0808425c2d357546aff8c1f7b4bfae1319c2c16	file1.txt
100644 blob 04ef7adec5cac575624995d22b88bde447a78d0e	file2.txt
Repare que o hash do file1.txt continua igual ao do primeiro commit. Como o conteúdo não mudou, o Git simplesmente reaproveitou o blob existente em vez de gravar outra cópia.
Esse detalhe mostra como o Git por dentro economiza espaço sem nenhum mecanismo complicado. Afinal, conteúdo idêntico gera hash idêntico, e o objeto já está no banco.
Objetos soltos e packfiles dentro do Git
Os objetos que vimos até agora são chamados de objetos soltos (loose objects), porque cada um ocupa seu próprio arquivo. Depois do segundo commit, o comando git count-objects -v mostra seis deles no repositório de exemplo.
Contudo, guardar uma cópia compactada inteira de cada versão de cada arquivo ocuparia muito espaço em projetos grandes. Por isso, o Git agrupa periodicamente os objetos em arquivos chamados packfiles.
git count-objects -v
count: 6
in-pack: 0

git gc

git count-objects -v
count: 0
in-pack: 6
O comando git gc faz esse empacotamento manualmente, mas o Git também o executa sozinho em operações como push. Dentro do pack, o Git pode guardar versões parecidas como diferenças (deltas), o que reduz bastante o tamanho do repositório.
Mesmo assim, o modelo lógico continua o mesmo. Ou seja, cada objeto segue identificado pelo seu hash, e o git cat-file lê o conteúdo de um pack da mesma forma que lê um objeto solto.
Uma nota sobre SHA-1 e SHA-256
Todos os hashes deste artigo têm 40 caracteres hexadecimais, porque o Git usa SHA-1 por padrão. No entanto, o projeto também oferece suporte a repositórios com SHA-256, criados com git init --object-format=sha256.
Nesse caso, os hashes passam a ter 64 caracteres, mas a estrutura de blobs, trees, commits e referências permanece igual. Portanto, tudo o que vimos sobre o Git por dentro continua válido.
Resumo do caminho pelo Git por dentro
Vale recapitular o trajeto completo, porque ele resume o modelo de dados do Git. Partimos do HEAD, que apontou para refs/heads/master.
Em seguida, o arquivo da branch nos entregou o hash do commit. Depois, o commit nos levou à tree, e a tree nos levou ao blob com o conteúdo do arquivo.
Esse encadeamento de ponteiros é tudo o que um git checkout precisa para reconstruir uma pasta em qualquer ponto do histórico. Da mesma forma, um git log apenas segue as linhas parent de commit em commit.
Conclusão sobre o Git por dentro
Com este percurso, percebemos que o Git monitora as mudanças da nossa pasta criando cópias dos arquivos dentro de .git/objects. Além disso, o Git mantém uma tree para cada commit, o que permite saber quais arquivos existiam após cada um deles.
Por fim, os commits funcionam como "fotos" de um determinado estado da pasta. Graças a essas fotos, o Git consegue manter um histórico de todas as mudanças ocorridas no diretório.
Evidentemente, este texto apenas arranha a superfície do Git por dentro, que ainda inclui o index, o reflog e o protocolo de transferência. Ainda assim, ele já mostra como o sistema consegue ser poderoso com uma abordagem extremamente simples.
FAQ
O que fica dentro da pasta .git?
Ficam o arquivo HEAD, o index, a pasta objects com todo o conteúdo versionado e a pasta refs com branches e tags. Também ficam ali o arquivo config, os hooks e os logs de referências.
Qual a diferença entre blob, tree e commit?
O blob guarda o conteúdo de um arquivo, a tree guarda nomes, modos e hashes de arquivos e subpastas. Já o commit aponta para uma tree e registra autor, data, mensagem e commit pai.
Por que o hash do meu commit é diferente do artigo?
O commit inclui seu nome, seu e-mail e a data exata, então o hash muda em cada máquina. Já o hash do blob depende só do conteúdo e pode coincidir.
Apagar um arquivo da pasta objects é seguro?
Não, porque commits e trees podem depender daquele objeto e o repositório ficaria corrompido. Para limpar objetos inalcançáveis, use o comando git gc.
O Git guarda diferenças ou arquivos inteiros?
No modelo lógico, cada versão é um snapshot completo, e cada blob guarda o arquivo inteiro. Porém, os packfiles podem armazenar versões parecidas como deltas para economizar espaço.