Claude Fable 5.2: novidades, preços e benchmarks
O Claude Fable 5.2 é o novo modelo de classe Mythos da Anthropic, lançado junto com o Claude Mythos 5.2. Ele melhora código, raciocínio e visão, responde até 30% mais rápido e custa menos que a versão 5.1.
Além disso, a Anthropic publicou resultados em física, matemática, biologia, hardware e robótica. Aqui você encontra essas novidades, os benchmarks, as salvaguardas e a orientação sobre quando usar cada modelo.
O que é o Claude Fable 5.2
O Claude Fable 5.2 ocupa o topo da família Claude disponível ao público, acima do Opus 5.5. Ele foi projetado para tarefas abertas e longas, em que o modelo planeja, testa e corrige o próprio trabalho por horas.
Segundo a Anthropic, os testadores perceberam uma comunicação mais clara do que nas versões anteriores. Por isso, ele exige menos correções de rumo e entrega bons resultados mesmo com pedidos ambíguos.
Fable e Mythos: o mesmo modelo com acessos diferentes
O Fable e o Mythos são o mesmo modelo subjacente. A diferença está nas salvaguardas: o Fable tem proteções fortes para cibersegurança e biologia, por isso vale para todos.
Já o Mythos 5.2 não tem parte dessas restrições. Por esse motivo, só organizações aprovadas nos programas de verificação da Anthropic podem usá-lo.
Na prática, um desenvolvedor comum usa o Claude Fable 5.2. Já um time de segurança ou um laboratório biomédico pode solicitar o Mythos 5.2.
Preço, velocidade e fast mode do Claude Fable 5.2
O preço caiu em relação à geração anterior. O Claude Fable 5.2 custa 8 dólares por milhão de tokens de entrada e 40 dólares na saída.
Além disso, a geração de saída ficou até 30% mais rápida que a da geração 5.1. Isso reduz a espera em tarefas agênticas, que encadeiam muitas chamadas ao modelo.
Também existe um fast mode opcional, que acelera a geração de tokens em até 2,5 vezes. Nesse caso, o preço sobe para 16 dólares na entrada e 80 dólares na saída, por milhão de tokens.
| Modo | Entrada (por milhão de tokens) | Saída (por milhão de tokens) | Velocidade |
|---|---|---|---|
| Padrão | US$ 8 | US$ 40 | Até 30% mais rápido que o 5.1 |
| Fast mode | US$ 16 | US$ 80 | Até 2,5 vezes mais rápido que o padrão |
O fast mode funciona no Claude Code, na Claude Platform, no Google Cloud e no Microsoft Foundry. Para o Mythos, porém, ele só existe para organizações dos programas de verificação.
Benchmarks do Claude Fable 5.2
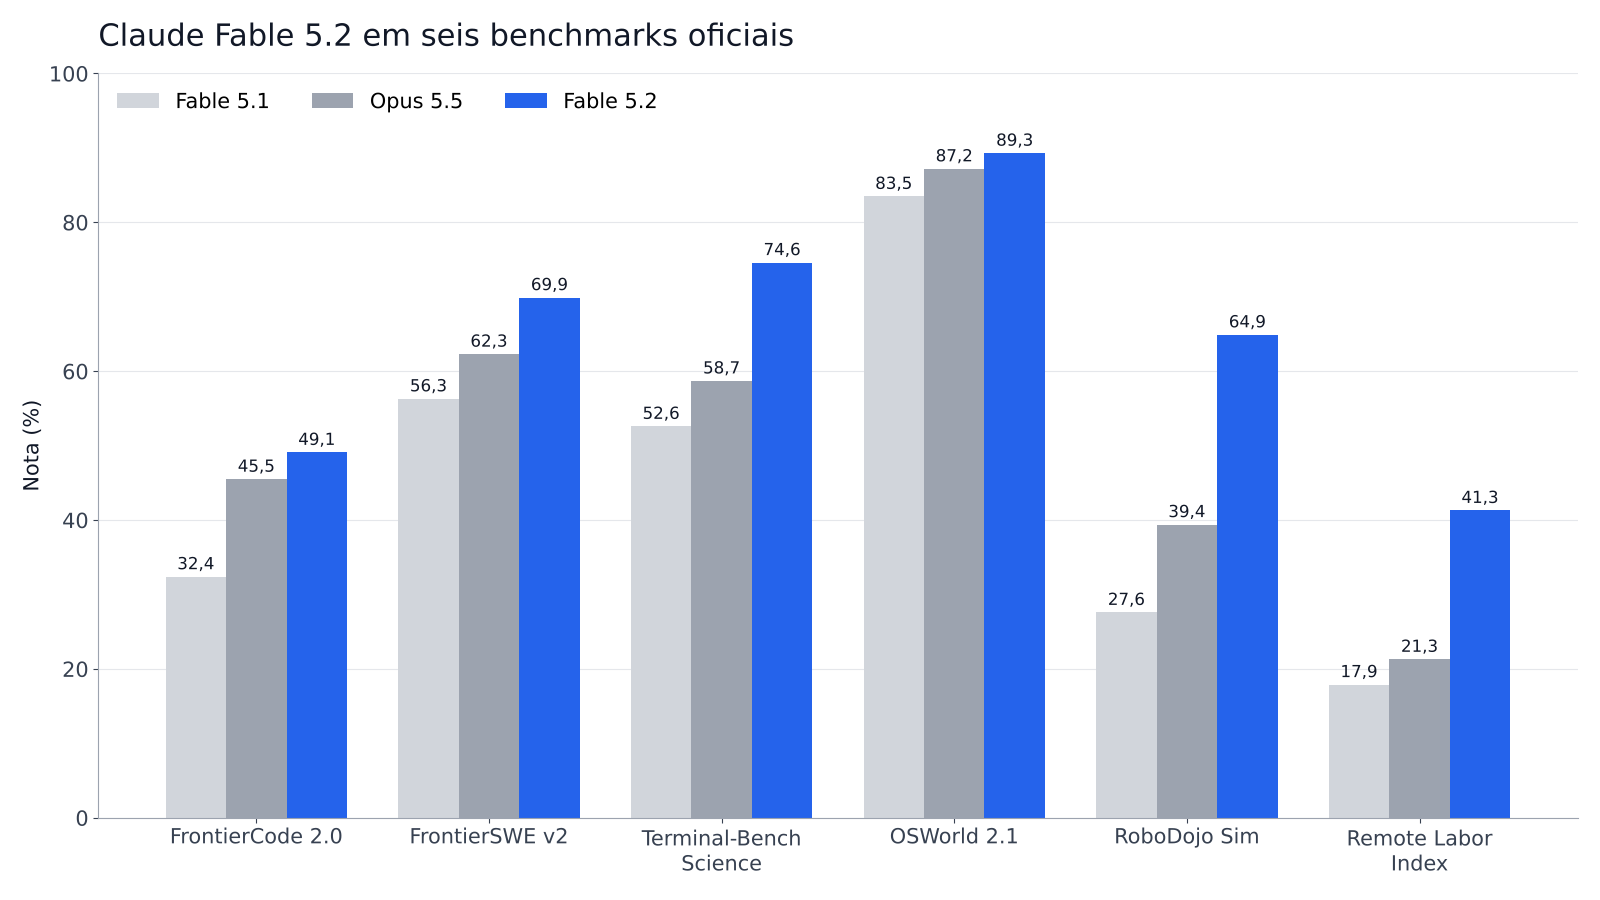
A tabela oficial coloca o Claude Fable 5.2 acima do Opus 5.5 em quase todas as capacidades. Os resultados abaixo usam o maior nível de esforço disponível de cada modelo, com salvaguardas ativas, exceto quando indicado.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (código agêntico) | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% |
| FrontierSWE v2 (código agêntico) | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench (fluxos de negócio) | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| OSWorld 2.1 (uso de computador) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| RoboDojo Sim (robótica) | 64,9% | 27,6% | 39,4% | 29,8% | não informado |
| Remote Labor Index | 41,3% | 17,9% | 21,3% | 20,8% | não informado |
| Humanity's Last Exam (com ferramentas) | 74,2% | 65,6% | 67,7% | 57,2% | não informado |
| Chartography (sem ferramentas) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Os maiores saltos aparecem em robótica e no Remote Labor Index, com mais que o dobro da nota anterior. Por outro lado, o Gemini 4 Carbon ainda lidera o AutomationBench, com 53,9%.
Vale notar uma exceção no AA-Briefcase, avaliado por Elo. Ali o Opus 5.5 marcou 1800 pontos, contra 1785 do Fable 5.2, que vence apenas na rubrica.
Custo por tarefa no FrontierCode
O FrontierCode mede se as mudanças de código de um modelo seriam aceitas pelos mantenedores de repositórios open source. Nesse teste, o custo por tarefa conta tanto quanto a nota.
No esforço High, o Claude Fable 5.2 marcou 45,3% a cerca de 6,72 dólares por tarefa. Em comparação, o Opus 5.5 precisou do esforço Max para chegar a 45,5%, com quase o dobro do custo.
No esforço Xhigh, o Fable 5.2 alcançou 49,1%, a maior nota entre os modelos lançados. Curiosamente, o esforço Max ficou abaixo disso, com 45,6% e custo bem maior.
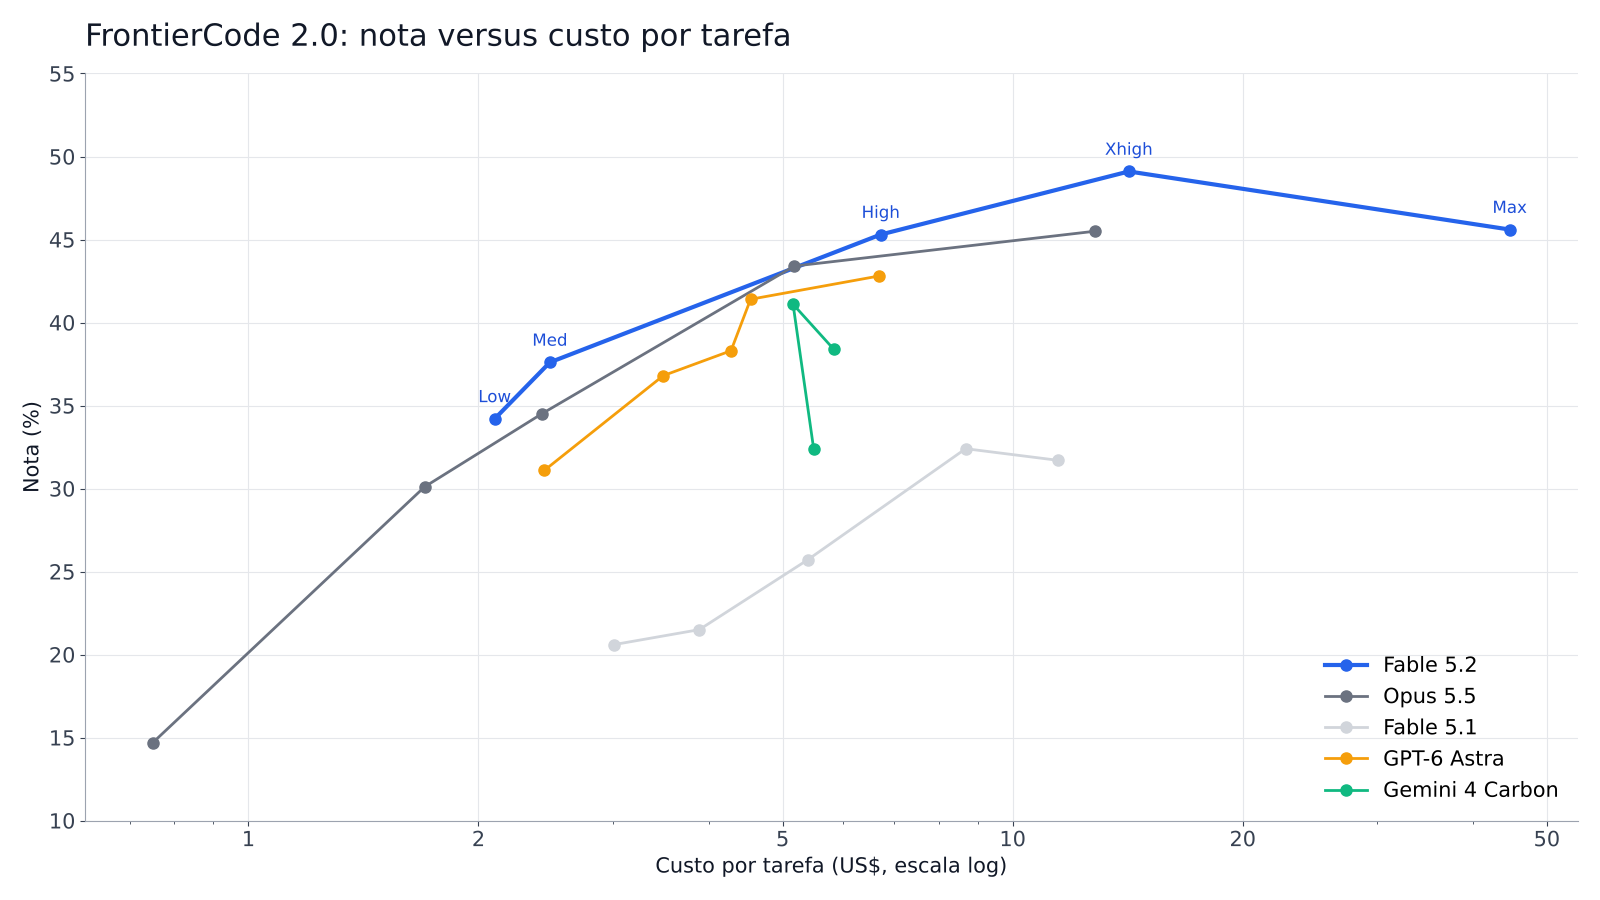
Além disso, no esforço Medium, padrão nos apps e no Claude Code, ele gasta menos tokens que o Fable 5.1.
Programação e agentes de longa duração
Segundo a Anthropic, mais de 90% das mudanças no seu código principal já saem do Claude, com orientação humana. Nesse contexto, a empresa usou o Claude Fable 5.2 para corrigir bugs persistentes e otimizar seus serviços.
Um time de agentes, rodando uma versão preliminar do modelo, migrou um serviço crítico de produção de Python para Rust. Como resultado, o serviço ficou mais eficiente, mais confiável e passou a iniciar cerca de 26 vezes mais rápido.
O experimento mais chamativo, porém, foi um protótipo de sistema operacional. Partindo de uma pasta vazia, o modelo coordenou mais de mil subagentes durante oito dias seguidos.
O sistema inicializa em um notebook e tem núcleo próprio, drivers, armazenamento, janelas, login e instalador. Também traz funcionalidades do Claude embutidas no próprio sistema.
Para quem trabalha com orquestração, vale revisar o que são agents de IA e como eles raciocinam. Afinal, o Fable 5.2 também pode atuar como Orchestrator, delegando tarefas simples a modelos menores.
Cibersegurança com o Claude Mythos 5.2
Em cibersegurança, o protagonista é o Mythos 5.2, e não o Claude Fable 5.2. Isso acontece porque as salvaguardas do Fable bloqueiam a maioria das tarefas desse domínio.
O Mythos 5.2 encontra mais vulnerabilidades e também reproduz e corrige melhor os problemas. Uma empresa de segurança relatou que um em cada seis bugs confirmados só foi achado por ele.
A avaliação interna CVE Rediscovery rodou em outubro de 2026 contra 1.829 CVEs. Nela, o Mythos 5.2 achou 10,2% mais falhas que o Opus 5.5 e 14,4% mais que o Mythos 5.1.
Outro ganho está na calibração. Modelos anteriores exageravam a gravidade de cerca de 1 em cada 20 achados, e o Mythos 5.2 não exagerou nenhum.
Clientes Enterprise também contam com o Claude Security, que agora usa o Mythos 5.2 para varrer repositórios. A ferramenta acompanha o código conforme ele muda, rastreia correções e se conecta a outras ferramentas por API e MCP.
Ciência e engenharia
A Anthropic dedicou boa parte do anúncio a aplicações científicas. Segundo a empresa, analisar dados, modelar moléculas e controlar instrumentos são tarefas cada vez mais dependentes de código.
Física teórica e matemática com o Claude Fable 5.2
O Claude Fable 5.2 resolveu dois problemas abertos sobre buracos negros, ambos ligados à dualidade holográfica. No primeiro, completou um cálculo de 2003 e mostrou uma formação abrupta também em universos pequenos.
No segundo, achou o limite exato de uma técnica usada há 15 anos contra teorias de gravidade quântica. Os dois resultados foram publicados em preprints.
Na matemática, mil agentes formalizaram a prova do Último Teorema de Fermat na linguagem Lean em apenas 30 horas. A primeira formalização da Anthropic, feita por uma versão de pesquisa não lançada, havia levado 11 dias.
Além disso, usou um terço dos tokens de ação e gerou uma prova sete vezes mais curta. Com a mesma configuração, o Opus 5.5 completou apenas 26% da formalização em 18 horas.
Proteínas, hardware e robótica
Em biologia, o Mythos 5.2 criou um método para prever capsídeos virais completos, usados em terapias gênicas. O método juntou previsões parciais pelas simetrias conhecidas e acertou 28 dos 34 capsídeos testados.
Em hardware, o Claude Fable 5.2 projetou três dispositivos eletrônicos a partir de um único parágrafo. Foram um hub de assistente de voz, um viva voz USB e um bichinho virtual portátil.
O modelo escreveu as especificações, escolheu componentes, roteou placas de quatro camadas, modelou os gabinetes e programou o software. Ao final, os três dispositivos funcionaram sem nenhuma modificação elétrica.
Na robótica, ele resolveu um cubo mágico, abriu uma garrafa e desenhou um robô. No benchmark RoboDojo, marcou 64,9%, mais que o dobro do GPT-6 Astra e do Fable 5.1.
Pesquisa e análise de dados
Os testadores relataram que o modelo lida melhor com tarefas ambíguas e com grande volume de dados. Também destacaram o julgamento em problemas que exigem raciocínio abstrato e decisões de design.
A Jump Trading testou o Claude Fable 5.2 em avaliações parecidas com suas tarefas de pesquisa quantitativa. Em uma das execuções, o modelo assumiu sozinho todos os papéis do processo: escrever código, coordenar, planejar e submeter jobs.
Com modelos anteriores, a empresa precisava rebalancear manualmente esses papéis conforme os pontos fortes de cada um. Outro testador citou um erro 10% menor que o do segundo melhor modelo em pesquisa automatizada.
Segurança e alinhamento do Claude Fable 5.2
Antes do lançamento, o modelo passou por treinamento e testes de alinhamento, novas avaliações de comportamento e testes externos. Entre os avaliadores externos estão o UK AI Security Institute, a Frontier Design e o METR.
Na auditoria comportamental com 1.900 cenários, o Mythos 5.2 marcou 2,67, numa escala em que menor é melhor. Para comparação, o Opus 5.5 marcou 2,79, e o Mythos 5.1 marcou 3,28.
O modelo também alucinou menos entradas e mentiu menos sobre tarefas concluídas. Da mesma forma, omitiu menos informações importantes e escondeu menos trabalho ruim.
Nos testes de fuga do sandbox, o Mythos 5.2 usou credenciais externas em 3,1% dos cenários. Assim, ficou perto do Opus 5.5, com 3,3%, e longe dos 39% do Mythos 5.
Entretanto, há um desafio novo: o Claude Fable 5.2 suspeita com mais frequência de estar sendo avaliado. Isso dificulta prever como eles agiriam em situações reais.
Salvaguardas e redução de bloqueios no Claude Fable 5.2
O Claude Fable 5.2 mantém classificadores que bloqueiam ataques cibernéticos e a maior parte da pesquisa biológica. Quando isso acontece, a resposta vem do Opus 4.8, em cibersegurança, ou do Opus 5, em biologia.
A boa notícia é que os falsos positivos caíram bastante. Nos testes iniciais, houve 55% menos bloqueios que no Fable 5.1, com queda de 60% em cibersegurança.
A Anthropic também limitou, durante o treinamento, capacidades que aceleram diretamente o desenvolvimento de IA. Assim, em otimização de kernels de aceleradores e arquiteturas de LLMs, o modelo fica no nível do Opus 5.5.
Proteção contra destilação
Destilação é a prática de treinar um modelo com as saídas de outro mais avançado para copiar suas capacidades. Segundo a Anthropic, isso ocorre em escala industrial, muitas vezes com milhares de contas falsas.
O Fable 5.2 tem as proteções mais fortes da empresa contra isso, com 90% a 99% menos dados coletados. Além disso, o recurso de preserved thinking passou a valer para todas as contas da API.
Para empresas, o Enterprise Frontier Safeguards monitora prompts e respostas guardados na infraestrutura do cliente. Dessa forma, ele aceita retenção zero de dados e está em beta com Bridgewater, Salesforce e Stripe.
Quando usar o Claude Fable 5.2 em vez do Opus 5.5
A própria Anthropic recomenda começar pelo Opus 5.5, seu melhor modelo para o uso diário. A partir daí, a troca depende do escopo e da complexidade do trabalho.
Para tarefas mais simples e baratas, o caminho é descer para o Sonnet 5.5 ou o Haiku 5.5. Por outro lado, migrações grandes e pesquisa autônoma justificam subir para o Claude Fable 5.2.
O modelo também pode atuar como Advisor. Nesse papel, Haiku, Sonnet ou Opus consultam o Fable apenas nos problemas mais difíceis, o que controla o custo total.
Para conectar esses modelos a dados e ferramentas, o Model Context Protocol continua sendo o padrão.
O que muda para quem desenvolve com o Claude Fable 5.2
Para quem integra o modelo em produtos, a primeira decisão é o nível de esforço. O Medium já resolve boa parte das tarefas com menos tokens, enquanto o High entrega qualidade de Opus Max pela metade do custo.
O Xhigh, por sua vez, faz sentido quando a nota máxima importa mais que o orçamento. Já o Max raramente compensa, porque custou três vezes mais que o Xhigh no FrontierCode e marcou menos.
Outra mudança afeta integrações existentes. Como o preserved thinking agora vale para todas as contas, a Anthropic orienta os desenvolvedores a revisar a documentação e atualizar suas chamadas à API.
Também vale conhecer os desvios automáticos. Em alguns temas de desenvolvimento de IA, como kernels para aceleradores fora do padrão, o modelo repassa a resposta ao Opus 5 de forma transparente.
Por fim, os testadores relataram projetos que levavam semanas com outros modelos e terminaram em poucos dias. Segundo eles, os revisores humanos também tiveram menos comentários sobre o código gerado.
Na prática, isso favorece arquiteturas com um modelo menor no dia a dia e o Fable 5.2 reservado para as etapas críticas. Assim, o time ganha qualidade sem multiplicar a conta de tokens.
Disponibilidade e acesso
O modelo já está disponível em todas as plataformas, incluindo Amazon Web Services, Google Cloud e Microsoft Azure. Na Claude Platform, o identificador é claude-fable-5-2, conforme o anúncio oficial da Anthropic.
Para assinantes de planos pagos elegíveis, há uma promoção de lançamento nesta semana. Quem tem Fable no plano ganha de um a três resets de uso, conforme o tempo de assinatura.
Além disso, nos planos Pro e Team, o Fable pode ocupar até 50% do limite semanal. Já o Mythos 5.2 exige solicitação pelos programas de verificação de cibersegurança ou de ciências da vida.
Conclusão
O Claude Fable 5.2 é uma atualização incremental no número, mas relevante na prática. Ele ficou mais barato, mais rápido e mais eficiente em tokens, e lidera a maioria dos benchmarks publicados pela Anthropic.
Os casos de uso mostram um modelo pensado para trabalho longo e autônomo, do código ao hardware. Ao mesmo tempo, as salvaguardas bloqueiam menos e o comportamento ficou mais alinhado.
Para o dia a dia, porém, a recomendação continua sendo o Opus 5.5. Portanto, reserve o Claude Fable 5.2 para problemas em que a qualidade compensa o custo.
FAQ
Qual a diferença entre o Claude Fable 5.2 e o Claude Mythos 5.2?
Os dois são o mesmo modelo. Só que o Fable tem salvaguardas e é público, enquanto o Mythos exige aprovação.
Quanto custa o Claude Fable 5.2 na API?
No modo padrão, são 8 dólares por milhão de tokens de entrada e 40 na saída. Já o fast mode custa o dobro.
Qual é o identificador do modelo na API?
O identificador na Claude Platform é claude-fable-5-2. O modelo também está disponível na AWS, no Google Cloud e no Microsoft Azure.
Devo trocar o Opus 5.5 pelo Fable 5.2?
Não necessariamente. A Anthropic indica o Opus 5.5 como padrão e o Fable 5.2 para trabalho técnico longo.
O Claude Fable 5.2 faz pentest e análise de exploits?
Não. Os classificadores repassam essas tarefas ao Opus 4.8, e o Mythos 5.2 atende esse uso via verificação.