
Agent experience (AX): o que é e como medir

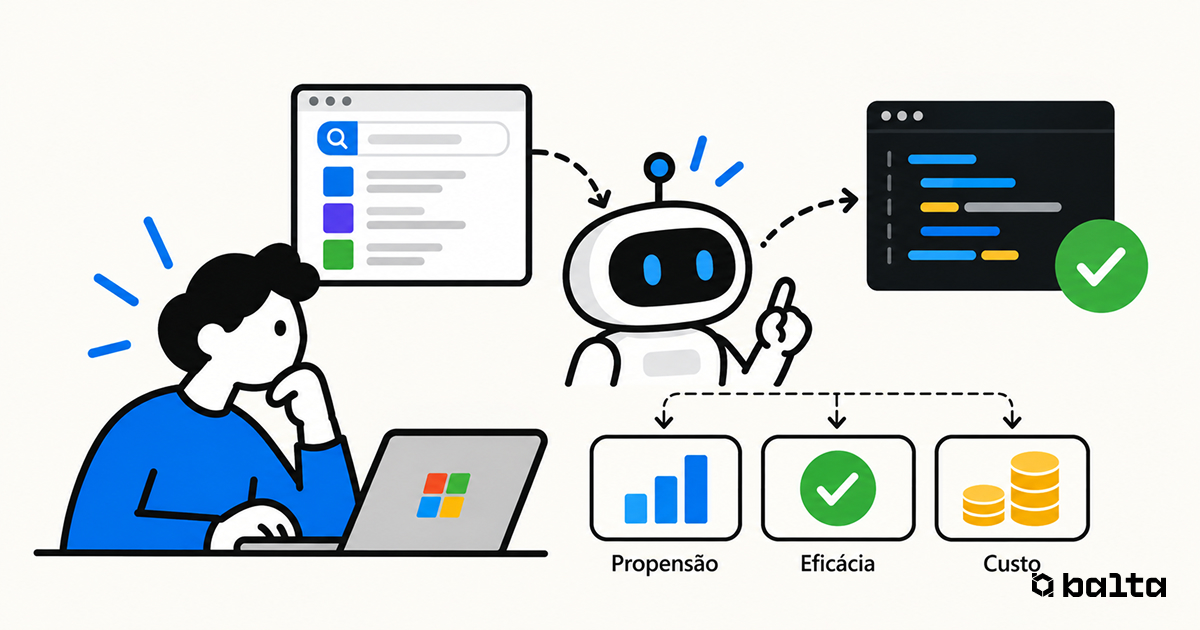
Agent experience (AX) é a experiência que um agente de IA tem quando descobre, escolhe e usa a sua tecnologia. Praticar AX significa melhorar essa experiência de forma sistemática e, principalmente, medir se a melhoria aconteceu de fato.
O que é agent experience
Hoje, boa parte dos desenvolvedores pede para um agente de IA construir algo com o seu SDK, a sua API ou a sua CLI. Por isso, eles passam a julgar a sua tecnologia pelo resultado que o agente entrega, e não apenas pela qualidade da documentação.
Se o agente escolhe um serviço concorrente, chama uma API que você já depreciou ou declara sucesso em um build quebrado, a sua tecnologia parece quebrada. Isso acontece mesmo quando a documentação é excelente para pessoas.
Mathias Biilmann, CEO da Netlify, propôs o termo em janeiro de 2025. Ele descreveu a agent experience como a experiência completa que agentes de IA terão como usuários de um produto ou plataforma.
Em outubro de 2026, Waldek Mastykarz publicou no Microsoft Developer Blog uma visão bastante prática do conceito. Neste artigo, usamos essa visão como base e acrescentamos contexto para quem desenvolve no ecossistema Microsoft.
O conceito vale para qualquer agente. Por exemplo, ele cobre tanto um agente de código dentro do seu editor quanto o ChatGPT chamando o seu servidor MCP.
Por que a agent experience importa para quem cria tecnologia
Durante anos, a pergunta central de quem publica uma biblioteca foi simples: um desenvolvedor consegue usar isso sem sofrer? Agora, existe um intermediário entre o desenvolvedor e o seu código.
Esse intermediário lê a sua documentação, executa os seus comandos e interpreta as suas mensagens de erro. Além disso, ele confia no que recebe de volta muito mais do que um humano experiente confiaria.
Na prática, uma agent experience ruim gera um efeito silencioso. O desenvolvedor não abre uma issue dizendo que o agente errou, ele simplesmente conclui que a sua tecnologia é difícil ou instável.
Por outro lado, uma boa experiência para agentes vira vantagem competitiva. Quando o agente acerta de primeira, o desenvolvedor associa a sua ferramenta à produtividade.
Propensão e eficácia: as duas perguntas da AX
A AX se resume a duas perguntas. Primeiro, o agente encontra e escolhe a sua tecnologia? Depois, ele a usa corretamente?
Cada pergunta tem um nome e um jeito próprio de ser testada. Além delas, existe uma terceira dimensão que costuma ficar de fora das avaliações: o custo.
Propensão: o agente escolhe a sua tecnologia?
Propensão mede se o agente chega até a sua tecnologia sem ser conduzido. Para testar, você entrega uma tarefa que não cita o seu produto, como adicionar envio de e-mail a uma aplicação.
Em seguida, você observa o que o agente escolhe. Se ele sempre recorre ao concorrente, você tem um problema de propensão, mesmo que o seu produto seja tecnicamente superior.
Algumas ferramentas de avaliação chamam essa dimensão de descoberta e seleção. O nome muda, mas a ideia continua a mesma.
Eficácia: o agente usa a sua tecnologia corretamente?
Eficácia mede o que acontece depois que o agente já escolheu a sua tecnologia. Nesse caso, a tarefa cita o produto pelo nome e você verifica se o agente chama a API atual ou uma versão depreciada.
Em outras palavras, a propensão diz se os agentes chegam até você. Já a eficácia diz o que acontece quando eles chegam.
Custo: a métrica que todo mundo esquece
Para propensão e eficácia, você pontua o que cada execução produziu e quanto ela custou. O custo é fácil de ignorar e também fácil de calcular errado.
Por exemplo, o Claude Sonnet 5 chegou com preço por token 33% menor que o do Sonnet 4.6. Ainda assim, ao atualizar projetos do SharePoint Framework (SPFx) no GitHub Copilot Chat, ele custou 3,7 vezes mais por execução, em 3 cenários e 15 execuções por modelo.
Isso acontece porque o preço por token não conta a história inteira. Um modelo pode gastar muito mais tokens explorando, repetindo leituras ou tentando caminhos alternativos.
Portanto, qualidade e custo andam juntos em qualquer análise de agent experience. Uma melhoria que dobra a qualidade e quadruplica o custo pode não valer a pena.
Onde praticar agent experience
Você não muda o modelo. Além disso, você só influencia o harness, ou seja, a aplicação que executa o modelo, por meio do fornecedor dele.
No entanto, tudo o que o agente lê e chama pertence a você. É nesse território que a agent experience acontece de verdade, e ele se divide em três frentes.
Documentação
Quando você atualiza a documentação, um modelo que aprendeu o conteúdo no treinamento só descobre a mudança na próxima versão do modelo. Por outro lado, um agente que lê a documentação enquanto trabalha enxerga a atualização já na execução seguinte.
Por isso, a documentação é a alavanca mais rápida que você tem. Ela atinge todos os desenvolvedores ao mesmo tempo, sem exigir instalação de nada.
Extensões de agente
Extensões de agente são tudo o que você entrega para guiar o comportamento do agente. Entram aqui skills, servidores MCP, arquivos de instrução e agentes customizados.
Um bom exemplo dessa categoria é o Microsoft Binlog MCP Server, que dá ao agente acesso estruturado aos logs de build do .NET. Contudo, toda extensão tem uma limitação importante: ela só ajuda quem a instala.
Interfaces: APIs, SDKs e CLIs
APIs, SDKs, CLIs, mensagens de erro e scaffolders também fazem parte da superfície. Os agentes usam essas interfaces como desenvolvedores usam, mas confiam muito mais no que recebem.
Em um caso real, um scaffolder sem versão fixada criou um projeto com uma versão de julho de 2020 em vez da atual. Mesmo assim, o agente tratou o resultado como sucesso e seguiu em frente.
Esse exemplo mostra por que mensagens de erro claras e versões fixadas importam tanto. Um humano estranharia a data, enquanto o agente apenas aceita o retorno.
Boas práticas de agent experience são hipóteses
Listas de boas práticas de AX são um bom ponto de partida. No entanto, uma mudança que parece amigável para agentes ainda pode piorar os resultados ou deixá-los mais caros.
Além disso, a correção óbvia nem sempre é a melhor. É aqui que a medição deixa de ser detalhe e passa a ser o centro da agent experience.
O caso das atualizações de SPFx
A equipe da Microsoft executou cinco vezes uma tarefa de atualização de projetos SPFx no GitHub Copilot Chat, com Claude Sonnet 4.6 no Windows. Nesse cenário, o agente passou em apenas 30 de 80 verificações de configuração.
Em seguida, a equipe instruiu o agente a usar a CLI for Microsoft 365, uma ferramenta open source que atualiza projetos SPFx. Com isso, o resultado subiu para 75 de 80 verificações.
Mesmo assim, havia um problema. Uma instrução como essa só funciona para quem já conhece a CLI ou para quem instala a skill que carrega essa orientação.
O rastro passo a passo do agente revelou algo mais útil. Durante o trabalho, ele consultava as notas de versão do SPFx, então a equipe corrigiu as notas de versão em vez de publicar uma skill.
Hoje, as notas de versão do SPFx no Microsoft Learn trazem um aviso de que atualizar apenas o package.json causa falhas de build. Logo abaixo, elas recomendam o comando da CLI que analisa o projeto e gera o script de atualização.
Depois dessa mudança, todas as execuções passaram a usar a CLI sem instrução explícita. Ou seja, a melhoria chegou a todos os desenvolvedores, sem nenhuma skill extra instalada.
Outras intuições que não sobreviveram à medição
A equipe também mediu outras ideias que soam amigáveis para agentes. A tabela a seguir resume os resultados.
| Parece amigável para agentes | O que a medição mostrou |
|---|---|
| Dar à CLI um modo de entrada em JSON | Com argumentos comuns, todos os perfis acertaram as 5 execuções. Em JSON, o Claude Haiku 4.5 acertou 2 de 5 implantações e todos os modelos custaram de 4 a 11 vezes mais |
| Colocar uma dica na documentação apontando a ferramenta certa | Uma dica direta levou 1 de 5 execuções à ferramenta. Um aviso que nomeava a abordagem com falha levou 5 de 5 |
| Oferecer outra fonte de documentação | O servidor MCP context7 não trouxe ganho relevante. As ferramentas não carregaram em 3 de 5 execuções e não foram chamadas nas outras 2 |
| Trocar para o modelo com token mais barato | O Claude Sonnet 5 custou 3,7 vezes mais por execução que o Sonnet 4.6, apesar do token 33% mais barato |
O resultado mais contraintuitivo é o do modo JSON. Muita gente assume que agentes preferem entrada estruturada, mas os números mostraram o oposto para essa CLI.
Vale lembrar que cada resultado vale para os cenários e o perfil de agente medidos. Os seus podem ser diferentes, e é justamente por isso que você precisa medir.
Vocabulário essencial de agent experience
A AX tem um vocabulário próprio, e dominar esses termos facilita conversas com o time. O primeiro deles é a baseline pura, ou seja, as mesmas tarefas executadas sem nenhuma extensão, apenas com o harness e o modelo.
A baseline é a referência para qualquer comparação. Contra ela, uma mudança gera lift quando melhora os resultados e drag quando os mantém iguais ou piores.
Já o custo da tarefa considera cada token pelo seu preço real, e não apenas a quantidade. Você reporta esse número ao lado da qualidade, sempre.
Por fim, o perfil de agente descreve o setup usado: sistema operacional, harness, modelo com suas configurações e extensões carregadas. Assim, todo resultado de agent experience pertence ao perfil em que você o mediu.
Agent experience, DX, GEO e llms.txt
A AX se apoia na developer experience (DX) e herda uma das lições mais antigas dela. Convenções de usabilidade ajudam, mas você ainda precisa observar usuários reais para saber se o produto funciona.
A diferença é que agentes são usuários muito mais fáceis de observar. Afinal, você pode rodar a mesma tarefa cinco vezes com e sem uma mudança, algo impensável com uma sala cheia de desenvolvedores.
Já a generative engine optimization (GEO) busca fazer a busca por IA mencionar o seu produto. Ela se sobrepõe à propensão, mas a agent experience vai além porque pergunta se o agente usa a tecnologia corretamente depois de escolhê-la.
Formatos como llms.txt e MCP também fazem parte da AX, porque são superfícies que você oferece aos agentes. Contudo, como qualquer boa prática, eles continuam sendo hipóteses até você medi-los com as suas tarefas.
Como começar a medir agent experience na prática
O artigo da Microsoft propõe um roteiro pragmático em cinco passos. Ele serve tanto para quem mantém uma biblioteca open source quanto para quem publica uma API interna.
- Escolha a sua tecnologia e escreva algumas tarefas que os desenvolvedores realmente pedem aos agentes, com as palavras deles. Inclua tarefas que não citam o produto, para testar propensão, e tarefas que citam, para testar eficácia.
- Execute cada tarefa algumas vezes em uma baseline pura, sempre com o mesmo perfil de agente. Observe onde o agente erra e o que ele leu pelo caminho.
- Corrija a causa, começando pela documentação ou pelas interfaces que os agentes já usam. Deixe uma nova extensão para o fim, porque ela só ajuda quem a instala.
- Compare qualidade e custo da tarefa e decida se a mudança gerou lift, drag ou um lift caro demais para manter.
- Mantenha a conclusão restrita àquele perfil de agente e repita a medição sempre que o perfil mudar.
Se você já publicou uma skill ou um servidor MCP, comece pelo passo 2. Nesse caso, compare execuções com e sem a extensão.
Um exemplo de tarefa de avaliação
Para organizar as avaliações, ajuda descrever cada tarefa em um arquivo versionado. O formato abaixo é apenas ilustrativo, já que cada ferramenta de avaliação define a própria estrutura.
# Tarefa de propensão: o prompt não cita o produto
- id: send-email-propensity
  type: propensity
  prompt: "Add email sending to this ASP.NET Core app when a user signs up."
  runs: 5
  profile:
    os: windows
    harness: github-copilot-chat
    model: claude-sonnet-4-6
    extensions: []          # baseline pura, sem extensões
  checks:
    - name: uses-our-sdk
      expect: "package reference to Contoso.Email"

# Tarefa de eficácia: o prompt cita o produto
- id: send-email-efficacy
  type: efficacy
  prompt: "Use Contoso.Email to send a welcome email when a user signs up."
  runs: 5
  profile:
    os: windows
    harness: github-copilot-chat
    model: claude-sonnet-4-6
    extensions: []
  checks:
    - name: no-deprecated-api
      expect: "no calls to EmailClient.SendLegacyAsync"
    - name: build-succeeds
      expect: "dotnet build exits with code 0"
  report:
    - quality
    - task_cost
Repare que as duas tarefas compartilham o mesmo perfil de agente. Dessa forma, a única variável entre a baseline e a próxima rodada é a mudança que você aplicou.
Além disso, o bloco report força o custo a aparecer ao lado da qualidade. Assim, ninguém comemora um ganho de qualidade sem enxergar quanto ele custou.
Se você já trabalha com especificações para guiar agentes, como no spec driven development, a lógica é parecida. Você descreve a intenção de forma explícita e verificável antes de confiar no resultado.
Qualquer avaliação é melhor do que nenhuma. Com ela, você sai da zona do "confia em mim", em que a única evidência é uma demo que pareceu funcionar.
Conclusão
A agent experience nasce de uma constatação simples: agentes de IA viraram usuários da sua tecnologia. Por isso, a forma como eles descobrem, escolhem e usam o seu produto passou a definir a percepção que os desenvolvedores têm dele.
O ponto mais valioso do artigo da Microsoft é tratar boas práticas como hipóteses. O caso do SPFx mostra isso com clareza, já que corrigir as notas de versão funcionou melhor do que publicar uma skill.
Em resumo, a prática de agent experience combina três atividades. Primeiro, observar como os agentes usam a sua tecnologia, depois mudar o que você controla e, por fim, medir se a mudança melhorou qualidade e custo.
Comece pequeno, com poucas tarefas e uma baseline bem definida. Com o tempo, essas medições viram o termômetro mais confiável da sua agent experience.
FAQ
Quem criou o termo agent experience?
Mathias Biilmann, CEO da Netlify, propôs o termo em janeiro de 2025. Desde então, empresas como a Microsoft passaram a publicar métodos práticos para medir a AX.
Qual a diferença entre agent experience e developer experience?
A DX trata da experiência de desenvolvedores humanos com a sua tecnologia. A AX trata da experiência dos agentes de IA, que leem, executam e confiam no retorno de forma diferente.
O que é propensão em AX?
É a medida de quanto o agente encontra e escolhe a sua tecnologia quando a tarefa não cita o seu produto. Algumas ferramentas chamam isso de descoberta e seleção.
Publicar um servidor MCP melhora a agent experience?
Pode melhorar, mas não há garantia. Trate o servidor como hipótese e compare execuções com e sem ele em uma baseline pura.
Por que o custo por token não basta para comparar modelos?
Porque um modelo com token mais barato pode consumir muito mais tokens por tarefa. Por isso, o que importa é o custo total da tarefa ao lado da qualidade.