
Microsoft.Extensions.DataIngestion: Ingestão de dados para aplicações .NET com RAG

A ingestão de dados no .NET ganhou uma biblioteca oficial, a Microsoft.Extensions.DataIngestion, criada para preparar documentos que alimentam aplicações de IA com RAG. O pacote vem da equipe de bibliotecas do .NET e conta com a contribuição de Adam Sitnik, conhecido pelo trabalho no BenchmarkDotNet e nas APIs de base do runtime.
O objetivo central é claro: tornar o .NET uma plataforma competitiva no ecossistema de inteligência artificial. Para isso, a biblioteca oferece suporte nativo a fluxos de ingestão de documentos voltados para modelos de linguagem de grande escala (LLMs).
O que é ingestão de dados no contexto de IA
No contexto de aplicações com IA, a ingestão de dados corresponde ao processo clássico de ETL (Extract, Transform, Load). Nesse caso, porém, o ETL serve para preparar documentos que depois passam por buscas vetoriais.
A motivação principal é fornecer contexto ao LLM. Sem contexto relevante, o modelo tende a gerar respostas genéricas ou imprecisas para casos de uso específicos.
Segundo a documentação oficial, a ingestão de dados para IA não se resume a converter formatos. Na prática, ela precisa preservar a estrutura e o significado dos documentos, dividir o conteúdo em partes gerenciáveis e enriquecer tudo com metadados ou embeddings.
Por fim, o resultado precisa ficar armazenado de um jeito que permita recuperação rápida e precisa. É justamente essa sequência que a biblioteca padroniza.
RAG: Retrieval-Augmented Generation
A abordagem adotada pela biblioteca é o RAG, sigla para Retrieval-Augmented Generation. Essa técnica permite que o modelo consulte uma base vetorial privada para recuperar informações relevantes antes de gerar a resposta.
Se você ainda não domina o conceito, vale ler o artigo o que é RAG (Retrieval-Augmented Generation) antes de seguir. Ele explica a técnica com mais calma.
O RAG funciona como alternativa ao fine-tuning e ao treinamento de modelos proprietários. Esses processos exigem alto custo computacional e, além disso, levantam preocupações com a privacidade dos dados.
Por isso, a qualidade de uma solução RAG depende diretamente da ingestão de dados. Se os documentos entram mal divididos ou sem contexto, a recuperação devolve trechos ruins e o modelo responde mal.
As três etapas do pipeline de ingestão de dados
O pipeline de ingestão de dados segue as três etapas tradicionais do ETL. Cada uma tem uma responsabilidade bem definida.
Extração é a primeira etapa, responsável por ler e interpretar o documento original. O conteúdo pode vir de arquivos PDF, documentos Word, bancos de dados relacionais ou APIs externas.
Transformação converte o conteúdo extraído para um formato padronizado. A biblioteca adota Markdown como formato intermediário, porque os LLMs modernos compreendem bem esse tipo de marcação.
Carregamento persiste os dados transformados em um vector store. Com isso, a aplicação consegue fazer buscas semânticas posteriores por similaridade vetorial.
Imagine um chatbot interno que ajuda colaboradores a encontrar informações em PDFs, planilhas, apresentações e páginas web espalhadas pela empresa. Sem uma etapa de ingestão de dados, esses arquivos brutos simplesmente não servem para um sistema de IA.
Fundamentos da arquitetura
A biblioteca se apoia em três pilares do ecossistema .NET. Cada um cuida de uma camada distinta do pipeline.
O Microsoft.ML.Tokenizers fornece a base para o chunking baseado em tokens. Assim, o conteúdo se divide de forma precisa e compatível com os limites dos modelos de linguagem.
O Microsoft.Extensions.AI potencializa as transformações de enriquecimento. Ele habilita sumarização, análise de sentimento, extração de palavras-chave e geração de embeddings.
O Microsoft.Extensions.VectorData oferece uma interface consistente para gravar os chunks processados. Entre os destinos suportados estão Qdrant, Azure SQL, CosmosDB, MongoDB, ElasticSearch e outros.
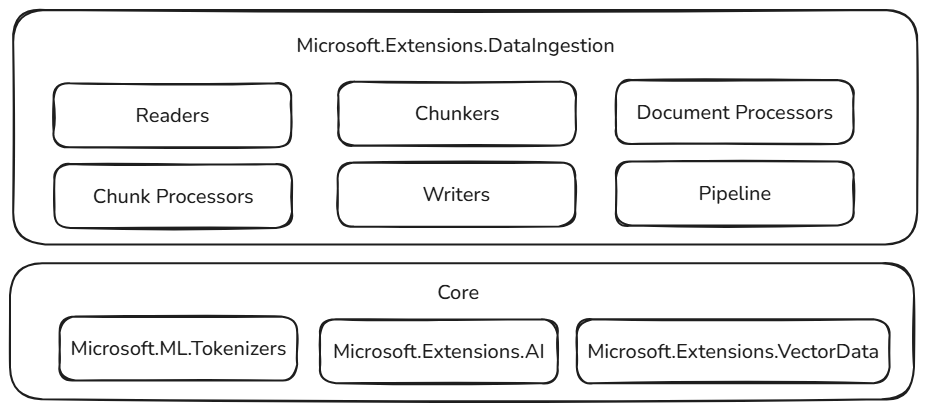
Essa arquitetura em camadas deixa o pipeline modular e intercambiável. Além disso, ela acompanha a evolução do ecossistema de IA do .NET sem exigir reescritas.
Componentes principais da biblioteca
A biblioteca disponibiliza interfaces e tipos que abstraem cada etapa do pipeline. Dessa forma, você substitui implementações de maneira modular, sem mexer no restante do fluxo.
A interface IEmbeddingGenerator transforma textos em vetores numéricos, os embeddings, que representam semanticamente o conteúdo dos documentos. Ela aceita tanto modelos locais quanto serviços em nuvem como o Azure OpenAI.
Os vector stores se integram via Microsoft.Extensions.VectorData, uma biblioteca complementar com abstração sobre diferentes provedores. O artigo sobre dados vetoriais no .NET com Microsoft.Extensions.VectorData detalha essa camada.
Entre os provedores, aparecem soluções locais e distribuídas, como o Azure AI Search. Então, a escolha do destino fica desacoplada do código de ingestão de dados.
Documentos e leitores na ingestão de dados
A base da biblioteca é o tipo IngestionDocument, que oferece uma representação unificada para qualquer formato de arquivo. Esse tipo é centrado em Markdown, pois os modelos de linguagem trabalham melhor com esse formato.
A abstração IngestionDocumentReader carrega documentos de diferentes fontes, sejam arquivos locais ou streams. Atualmente, os leitores disponíveis incluem MarkItDown e Markdig.
A Microsoft também anunciou suporte futuro para LlamaParse e Azure Document Intelligence. Esses leitores devem ampliar o alcance para formatos mais complexos.
Ao padronizar a leitura, o desenvolvedor troca a fonte de dados sem modificar o restante do pipeline. Na prática, isso deixa o código mais fácil de manter e de testar.
Estratégias de chunking na ingestão de dados
Após o carregamento, os documentos precisam ser divididos em partes menores chamadas chunks. Essa divisão garante que o conteúdo caiba nos limites de contexto dos modelos.
Além disso, ela permite que o sistema de recuperação identifique os trechos mais relevantes para cada consulta. Sem chunking, a ingestão de dados produziria blocos grandes demais para uma busca precisa.
A biblioteca oferece três estratégias principais de chunking:
- Por headers: o chunking divide o documento nos títulos e subtítulos, preservando a estrutura hierárquica do conteúdo.
- Por seções: o chunking divide por unidades estruturais, como páginas.
- Semântico: o chunking tenta preservar pensamentos completos, evitando cortes que comprometam o significado do trecho.
Veja como configurar um chunker baseado em headers com limite de 2000 tokens por chunk:
// Tokenizador compatível com o modelo usado na aplicação
Tokenizer tokenizer = TiktokenTokenizer.CreateForModel("gpt-4");

IngestionChunkerOptions options = new(tokenizer)
{
    MaxTokensPerChunk = 2000,
    OverlapTokens = 0
};

// Divide o documento a partir dos títulos
IngestionChunker<string> chunker = new HeaderChunker(options);
O TiktokenTokenizer conta os tokens do mesmo jeito que o modelo informado. Por isso, o limite de 2000 tokens corresponde de fato ao que o LLM vai receber.
A escolha da estratégia ideal depende do tipo de documento e da forma das consultas. Documentos com estrutura bem definida se beneficiam do chunking por headers, enquanto conteúdos narrativos pedem uma abordagem semântica.
Enriquecimento de chunks na ingestão de dados
Depois da divisão, você pode enriquecer o conteúdo com informações adicionais que aumentam sua utilidade para a IA. A biblioteca traz alguns processadores de chunks prontos.
O SummaryEnricher gera resumos automáticos de cada chunk. Assim, a recuperação de informações de alto nível fica mais fácil.
O SentimentEnricher aplica análise de sentimento, útil para sistemas que categorizam feedbacks ou avaliações. Já o KeywordEnricher extrai as palavras-chave principais de cada trecho e melhora a precisão das buscas.
O ClassificationEnricher categoriza automaticamente o conteúdo com base em categorias predefinidas. Por exemplo, ele pode separar trechos de contratos, manuais e políticas internas.
Todos esses processadores usam as abstrações do Microsoft.Extensions.AI para conversar com o LLM. Com isso, o enriquecimento fica flexível e independente do provedor de IA.
Processamento de imagens
Um componente notável da biblioteca é o ImageAlternativeTextEnricher. Diferente dos anteriores, ele atua no nível do documento, e não do chunk.
Esse processador usa modelos de linguagem para gerar textos alternativos descritivos para as imagens dos documentos. Isso importa muito quando há diagramas, gráficos e capturas de tela que o sistema de recuperação precisa compreender.
Sem esse enriquecimento, a busca simplesmente ignoraria as imagens. Consequentemente, as respostas perderiam parte da informação original.
Armazenamento em vector stores
Após o processamento, os chunks precisam de um destino adequado para consultas semânticas. O VectorStoreWriter<T> implementa a abstração IngestionChunkWriter<T> e grava em qualquer vector store compatível com Microsoft.Extensions.VectorData.
O writer também gera os embeddings dos chunks automaticamente. Para isso, ele usa um IEmbeddingGenerator<string, Embedding<float>> configurado pelo desenvolvedor.
O exemplo a seguir configura o writer com SQLite e o modelo text-embedding-3-small, acessado pelo endpoint do GitHub Models:
// Cliente apontando para o endpoint de inferência do GitHub Models
OpenAIClient openAIClient = new(
    new ApiKeyCredential(Environment.GetEnvironmentVariable("GITHUB_TOKEN")!),
    new OpenAIClientOptions { Endpoint = new Uri("https://models.github.ai/inference") });

IEmbeddingGenerator<string, Embedding<float>> embeddingGenerator =
    openAIClient.GetEmbeddingClient("text-embedding-3-small").AsIEmbeddingGenerator();

// Vector store local em SQLite
using SqliteVectorStore vectorStore = new(
    "Data Source=vectors.db;Pooling=false",
    new()
    {
        EmbeddingGenerator = embeddingGenerator
    });

// O text-embedding-3-small gera vetores de 1536 dimensões
using VectorStoreWriter<string> writer = new(vectorStore, dimensionCount: 1536);
O parâmetro dimensionCount deve corresponder à dimensão do modelo de embedding. Para o text-embedding-3-small, esse valor é 1536.
Se você trocar o modelo, revise esse número. Caso contrário, a gravação falha ou a busca compara vetores incompatíveis.
O pipeline de ingestão de dados
O ponto de convergência de todos os componentes é o IngestionPipeline<T>. Esse tipo encadeia leitores, processadores de documentos, processadores de chunks e writers em um único fluxo coeso e testável.
O código a seguir lê arquivos Markdown de um diretório, gera texto alternativo para imagens, resume cada chunk e grava os resultados no vector store:
using IngestionPipeline<string> pipeline = new(reader, chunker, writer, loggerFactory: loggerFactory)
{
    // Processadores aplicados ao documento inteiro
    DocumentProcessors = { imageAlternativeTextEnricher },
    // Processadores aplicados a cada chunk
    ChunkProcessors = { summaryEnricher }
};

await foreach (var result in pipeline.ProcessAsync(new DirectoryInfo("."), searchPattern: "*.md"))
{
    Console.WriteLine($"Completed processing '{result.DocumentId}'. Succeeded: '{result.Succeeded}'.");
}
Um detalhe importante: o método ProcessAsync retorna IAsyncEnumerable<IngestionResult>. Ou seja, o pipeline implementa o conceito de partial success, e a falha em um documento não interrompe os demais.
Cabe ao consumidor decidir como tratar as falhas. Ele pode refazer os documentos que falharam, registrar os erros para análise ou parar tudo se a taxa de falha ficar alta.
O pipeline também é composicional. Um fluxo mínimo de ingestão de dados pode ter apenas um leitor, um chunker e um writer, sem nenhum enriquecimento.
Execução local e privacidade de dados
Um dos diferenciais da biblioteca é executar todo o pipeline localmente, sem enviar dados a serviços externos. Isso pesa muito para organizações que lidam com contratos, manuais internos, políticas corporativas e outros documentos sigilosos.
Cada etapa aceita configuração independente. Por exemplo, você pode usar um parser local na extração, um modelo de embedding na própria máquina e um vector store também local.
Dessa forma, nenhum dado trafega fora do ambiente controlado. Para muitas empresas, essa é a condição que viabiliza a ingestão de dados sensíveis.
Integração com SQL Server 2025
O SQL Server 2025 introduz suporte nativo a operações vetoriais, com o tipo vector e funções como VECTOR_DISTANCE. Assim, ele vira um destino possível para pipelines de RAG sem exigir um banco vetorial separado.
A integração com Microsoft.Extensions.VectorData permite que o VectorStoreWriter<T> grave direto em tabelas do SQL Server. Vale notar que, segundo a documentação, os índices vetoriais ainda estão em preview no SQL Server 2025.
Essa integração interessa especialmente a equipes que já têm infraestrutura SQL Server. Afinal, elas ganham busca semântica sem introduzir novos componentes na arquitetura.
Integração com o ecossistema .NET de IA
O pacote faz parte de um esforço mais amplo da equipe de bibliotecas do .NET. Outros projetos relacionados incluem o MCP SDK, o A2A SDK e o Microsoft Agent Framework.
A interoperabilidade com o Agent Framework é natural, já que os dois projetos nasceram da base do Semantic Kernel. Portanto, o vector store que a ingestão de dados preencheu pode virar uma ferramenta para agentes construídos com o framework.
À medida que o Microsoft.Extensions.AI e o Microsoft.Extensions.VectorData ganham recursos, os componentes de ingestão também se beneficiam. Os pipelines existentes acompanham essa evolução sem mudanças estruturais.
Extensibilidade da biblioteca
A Microsoft construiu a biblioteca com a extensibilidade como princípio central. Todo componente é uma abstração aberta.
Assim, você pode implementar leitores customizados para formatos proprietários e processadores para regras de negócio específicas. Também pode escrever writers para destinos que a biblioteca não suporta nativamente.
Os futuros leitores LlamaParse e Azure Document Intelligence devem ampliar o suporte a PDFs escaneados e documentos com layouts elaborados. Enquanto isso, as abstrações já permitem cobrir essas lacunas com código próprio.
Desempenho na ingestão de dados
O design da biblioteca de ingestão de dados mira cenários de produção com grandes volumes de documentos. O uso de IAsyncEnumerable mantém o processamento assíncrono e com baixo consumo de memória.
Em outras palavras, o pipeline não carrega todos os documentos ao mesmo tempo. Cada resultado chega assim que o documento termina de passar pelas etapas.
A configuração de MaxTokensPerChunk e OverlapTokens equilibra a precisão da recuperação e o custo dos embeddings. Chunks muito grandes reduzem a granularidade da busca.
Por outro lado, chunks muito pequenos aumentam o custo computacional e podem perder contexto importante. Por isso, teste alguns valores com consultas reais antes de fixar a configuração.
Como começar com a ingestão de dados no .NET
A forma mais rápida de experimentar é o template AI Chat Web App, distribuído no pacote Microsoft.Extensions.AI.Templates. Ele demonstra o fluxo completo: ingestão de documentos, geração de embeddings, armazenamento vetorial e chat com RAG ativo.
# Instala os templates de IA do .NET
dotnet new install Microsoft.Extensions.AI.Templates

# Cria um app de chat com vector store local
dotnet new aichatweb --provider openai --vector-store local
O template serve como ponto de partida para cenários reais. Um exemplo típico é um assistente interno que responde perguntas com base na documentação corporativa privada.
O pacote está disponível no NuGet, e a documentação oficial de data ingestion no Microsoft Learn descreve cada bloco. Além disso, o projeto aceita contribuições e feedbacks no repositório dotnet/extensions do GitHub.
Conclusão
A biblioteca Microsoft.Extensions.DataIngestion representa uma evolução importante na ingestão de dados para aplicações .NET com IA. Ela padroniza leitura, processamento, chunking e armazenamento.
Com isso, a Microsoft elimina a necessidade de reinventar essa infraestrutura em cada projeto. O resultado é um código mais manutenível, testável e preparado para escalar com o negócio.
Para equipes que constroem soluções de RAG com .NET, adotar a biblioteca desde o início significa investir em uma base sólida. Afinal, ela segue o roadmap oficial do ecossistema .NET de IA.
FAQ
O que diferencia data ingestion de ETL tradicional no contexto de IA?
O ETL tradicional se preocupa principalmente em mover dados entre sistemas. Já a ingestão para IA preserva o significado do conteúdo, divide documentos em chunks e os enriquece com embeddings e metadados.
Preciso usar todos os componentes do pipeline?
Não, porque o IngestionPipeline<T> é composicional. Um pipeline mínimo pode conter apenas um leitor, um chunker e um writer.
Qual vector store usar em produção?
Depende da infraestrutura existente. Equipes com SQL Server podem aproveitar o suporte vetorial do SQL Server 2025, enquanto cenários cloud native costumam usar Qdrant ou CosmosDB.
Como o pipeline lida com falhas?
O ProcessAsync retorna IAsyncEnumerable<IngestionResult> e permite sucesso parcial. Cada resultado indica se o documento passou ou falhou, e o consumidor decide o tratamento.
Posso usar provedores de embedding diferentes da OpenAI?
Sim. O pipeline usa a abstração IEmbeddingGenerator<string, Embedding<float>>, que aceita Azure OpenAI, modelos locais via Ollama e outros provedores compatíveis.
O pacote está pronto para produção?
A biblioteca foi anunciada em preview como parte do ecossistema oficial .NET de IA. Verifique a versão atual no NuGet antes de adotar em produção.