
Channels em C#: como evitar gargalos em APIs de alto volume
Channels em C# trabalham com o conceito de producers, que produzem dados, e consumers, que consomem esses dados, ambos de forma assíncrona. A ideia parece simples, mas é justamente ela que permite tirar trabalho pesado do caminho da requisição sem perder o controle sobre a concorrência.
Neste artigo, você vai entender o que diferencia um channel de uma lista ou de uma BlockingCollection. Em seguida, vai ver como combinar channels com Background Services para gravar auditoria em lote em uma API de alto volume.
Por que gargalos surgem em APIs de alto volume
Toda requisição que chega a uma API ocupa recursos enquanto está em andamento. Ela usa uma thread do pool em alguns momentos, consome memória e, muitas vezes, mantém uma conexão aberta com o banco.
Quando a API executa tarefas secundárias dentro da própria requisição, esse tempo de ocupação cresce. Gravar logs, enviar e-mails ou atualizar métricas são exemplos de trabalho que o cliente não precisa esperar.
Em baixo volume, ninguém percebe a diferença. Porém, com milhares de requisições por minuto, cada milissegundo extra se multiplica e as conexões com o banco começam a disputar espaço.
O resultado é conhecido: filas no pool de conexões, aumento da latência e, no pior caso, timeouts em cascata. Por isso, a estratégia mais comum é tirar o trabalho secundário do caminho da requisição e processá-lo depois.
É exatamente aqui que os channels em C# entram. Eles oferecem uma fila em memória, segura para concorrência, que separa quem gera o trabalho de quem o executa.
O que são channels em C#
Os channels em C# vivem no namespace System.Threading.Channels e implementam o modelo produtor e consumidor. Segundo a documentação oficial da biblioteca System.Threading.Channels, eles passam dados de uma parte para outra por meio de uma fila FIFO, em que o primeiro a entrar é o primeiro a sair.
A biblioteca faz parte do shared framework desde o .NET Core 3.0. Ou seja, em qualquer projeto .NET moderno, ela já está disponível sem instalar pacote algum.
Até aí, nada de especial, porque muitas estruturas fazem algo parecido. Então, qual a diferença de uma lista ou de uma BlockingCollection?
A grande diferença está na eficiência thread-safe e no controle de backpressure. Com isso, o channel evita o esgotamento de recursos e o bloqueio de threads, já que foi pensado para cenários de stress e de alto throughput.
Podemos imaginar um channel como um pipe, com produtores de um lado e consumidores do outro.
[ Producers ] → ( Channel / Buffer ) → [ Consumers ]
- Producers escrevem dados no channel.
- Consumers leem dados do channel.
- O channel controla o fluxo entre eles.
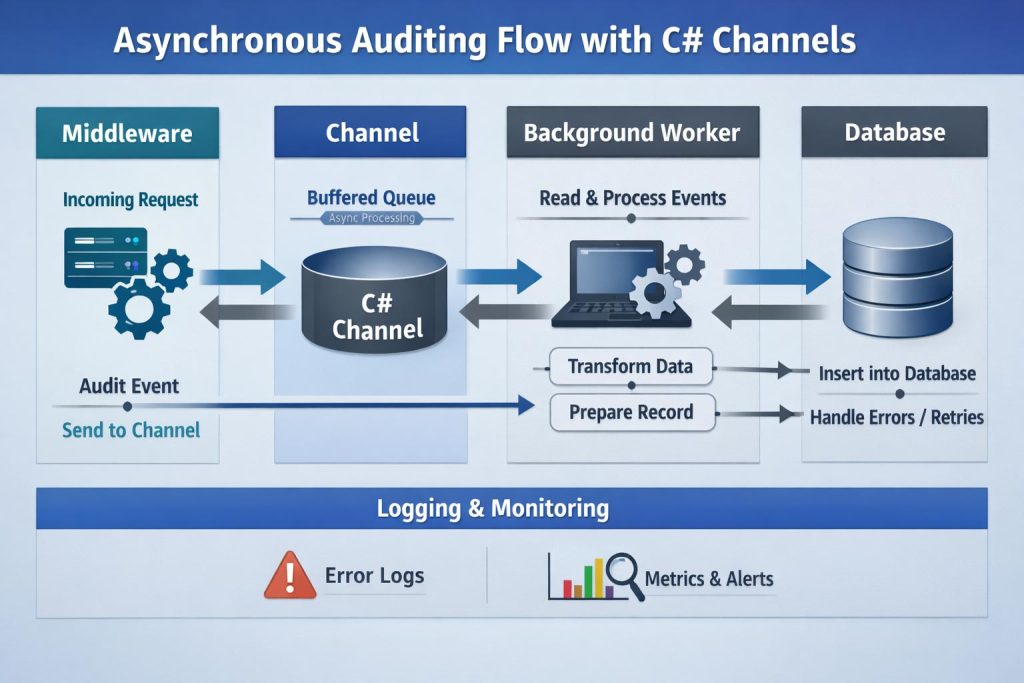
Na prática, o channel expõe duas pontas. A propriedade Writer, do tipo ChannelWriter<T>, serve aos produtores, enquanto a propriedade Reader, do tipo ChannelReader<T>, serve aos consumidores.
Criando channels em C# limitados e ilimitados
Existem duas estratégias de criação. O método Channel.CreateUnbounded<T> cria um channel sem limite de capacidade, enquanto Channel.CreateBounded<T> define um tamanho máximo para a fila.
No channel ilimitado, toda escrita termina na hora, porque sempre existe espaço. Por outro lado, se o consumidor ficar mais lento que o produtor, a memória cresce sem controle.
Channel limitado com BoundedChannelOptions
Para APIs de alto volume, o modelo limitado costuma ser a escolha mais segura entre os channels em C#. O exemplo abaixo cria um channel de auditoria com capacidade para mil itens.
using System.Threading.Channels;

// Criando um channel limitado (bounded)
var options = new BoundedChannelOptions(capacity: 1000)
{
    // Define o que acontece quando o channel está cheio
    FullMode = BoundedChannelFullMode.DropOldest, // Wait, DropNewest, DropOldest ou DropWrite
    SingleReader = true,  // Otimização quando existe apenas um consumer
    SingleWriter = false  // Vários producers (por exemplo, várias requisições simultâneas)
};

Channel<AuditLog> auditChannel = Channel.CreateBounded<AuditLog>(options);
As propriedades SingleReader e SingleWriter funcionam como promessas sobre o uso do channel. Quando você informa que existe um único leitor, a implementação interna consegue operar de forma mais eficiente.
Recursos primitivos, assíncronos e thread-safe
Dois detalhes de implementação explicam por que os channels em C# são tão eficientes. Vale entender cada um antes de partir para o código da API.
ValueTask e menos alocações
Primeiro, os channels em C# usam ValueTask na maioria das operações. Como ValueTask é uma struct, ela pode evitar a criação de uma Task quando a operação termina de forma síncrona.
Isso reduz a alocação na heap. Em outras palavras, há ganho de performance, porque a pressão sobre o garbage collector diminui.
Backpressure nos channels em C#
Segundo, você pode limitar o tamanho da fila com os bounded channels, evitando falta de recursos. Quando o produtor escreve mais rápido do que o consumidor lê, o writer sofre backpressure, e você decide como agir.
Wait: é o padrão, e oWriteAsyncaguarda até liberar um espaço, enquanto oTryWriteretornafalsena hora.DropNewest: remove o item mais novo da fila para abrir espaço para a escrita atual.DropOldest: remove o item mais antigo, ou seja, o começo da fila.DropWrite: descarta o próprio item que está sendo escrito.
A escolha depende do negócio. Para auditoria obrigatória, Wait protege os dados, enquanto para telemetria descartável um modo Drop mantém a API rápida mesmo sob pico.
Monitorando itens descartados
Descartar itens sem saber que isso aconteceu é perigoso. Por isso, os channels em C# limitados aceitam um callback chamado sempre que um item sai da fila por falta de espaço.
// O callback recebe o item descartado quando o channel está cheio
var channel = Channel.CreateBounded<AuditLog>(
    new BoundedChannelOptions(1000)
    {
        FullMode = BoundedChannelFullMode.DropOldest
    },
    static void (AuditLog dropped) =>
        Console.WriteLine($"Audit log dropped: {dropped.Path}"));
Na prática, esse callback é um bom lugar para incrementar uma métrica. Assim, um aumento repentino de descartes vira um alerta, e não uma surpresa no dia da investigação.
Channels em C# comparados a outras coleções
Uma comparação rápida ajuda a entender onde cada estrutura se encaixa.
- Lista comum (List ou Queue): são rápidas, mas não trabalham com concorrência, então dois produtores escrevendo juntos podem gerar exceção ou corromper o estado.
- ConcurrentQueue: é thread-safe, mas não avisa o consumer, que precisa ficar verificando manualmente se chegou algo novo.
- BlockingCollection: resolve a concorrência, porém bloqueia a thread enquanto envia ou recebe o dado, em vez de usar
await. - Channel: é thread-safe, avisa o consumer de forma assíncrona e ainda oferece controle de capacidade.
Essa última característica dos channels em C# faz toda a diferença em uma API. Afinal, cada thread bloqueada é uma thread a menos para atender requisições.
Channels e Background Services: o combo
Os channels em C# combinam muito bem com outro recurso interessante do .NET: os Background Services. O channel funciona como a esteira, e o serviço em segundo plano é quem processa o que chega nela.
Se você ainda não conhece esse recurso, o artigo sobre Background Services em C# e .NET explica o ciclo de vida desses serviços. Para um exemplo passo a passo, consulte também o guia de implementação de Background Services.
Onde usar channels em C#: auditoria de API
O exemplo clássico é a auditoria. Imagine que você precisa registrar todas as chamadas da sua API, que recebe milhares de requisições por minuto.
Se o middleware gravar a informação a cada request, o tempo de resposta aumenta por causa do I/O de banco de dados. Assim, a auditoria vira o gargalo da aplicação.
Você poderia ir na opção ingênua e usar um fire and forget? Poderia, mas não deveria.
Nesse caso, você perderia o controle da concorrência e poderia derrubar o processo por falta de recursos. Por isso, a saída é usar channels com Background Services, colocando os eventos na esteira e tratando cada um de forma assíncrona.
Definindo a fila de auditoria
Primeiro, crie um tipo para o evento e uma abstração para a fila. O channel fica encapsulado em uma classe registrada como singleton, para que producers e consumer compartilhem a mesma instância.
using System.Threading.Channels;

public sealed record AuditLog(string Method, string Path, int StatusCode, DateTime CreatedAt);

public interface IAuditQueue
{
    ChannelReader<AuditLog> Reader { get; }
    bool TryEnqueue(AuditLog log);
}

public sealed class AuditQueue : IAuditQueue
{
    private readonly Channel<AuditLog> _channel = Channel.CreateBounded<AuditLog>(
        new BoundedChannelOptions(1000)
        {
            FullMode = BoundedChannelFullMode.DropOldest,
            SingleReader = true,
            SingleWriter = false
        });

    public ChannelReader<AuditLog> Reader => _channel.Reader;

    // TryWrite não bloqueia a requisição, mesmo com a fila cheia
    public bool TryEnqueue(AuditLog log) => _channel.Writer.TryWrite(log);
}
Colocando os eventos no pipe
Em seguida, o middleware atua como producer dos channels em C# da aplicação. Ele apenas escreve o evento no channel e devolve a resposta, sem esperar pelo banco.
builder.Services.AddSingleton<IAuditQueue, AuditQueue>();
builder.Services.AddHostedService<AuditWorker>();

var app = builder.Build();

app.Use(async (context, next) =>
{
    await next(context);

    // Producer: registra o evento no channel e segue o fluxo
    var queue = context.RequestServices.GetRequiredService<IAuditQueue>();
    queue.TryEnqueue(new AuditLog(
        context.Request.Method,
        context.Request.Path,
        context.Response.StatusCode,
        DateTime.UtcNow));
});
Consumindo e gravando em lote
Você pode, inclusive, gravar os logs apenas quando a fila alcançar uma quantidade configurada de registros. Dessa forma, o consumer usa um bulk insert e evita idas desnecessárias ao banco de dados.
Contudo, convém configurar um tempo máximo de espera, para evitar que poucos eventos fiquem parados para sempre. O worker abaixo junta até 30 itens ou espera no máximo 10 segundos, o que acontecer primeiro.
public sealed class AuditWorker(
    IAuditQueue queue,
    IServiceScopeFactory scopeFactory,
    ILogger<AuditWorker> logger) : BackgroundService
{
    private const int BatchSize = 30;
    private readonly TimeSpan _maxWaitTime = TimeSpan.FromSeconds(10);

    protected override async Task ExecuteAsync(CancellationToken stoppingToken)
    {
        var buffer = new List<AuditLog>(BatchSize);

        while (!stoppingToken.IsCancellationRequested)
        {
            try
            {
                // Token que expira após _maxWaitTime ou quando a aplicação para
                using var cts = CancellationTokenSource.CreateLinkedTokenSource(stoppingToken);
                cts.CancelAfter(_maxWaitTime);

                try
                {
                    // WaitToReadAsync aguarda sem bloquear até que exista algo no channel
                    while (buffer.Count < BatchSize && await queue.Reader.WaitToReadAsync(cts.Token))
                    {
                        // TryRead aproveita o que já está em memória, sem esperar
                        while (buffer.Count < BatchSize && queue.Reader.TryRead(out var log))
                            buffer.Add(log);
                    }
                }
                catch (OperationCanceledException) when (!stoppingToken.IsCancellationRequested)
                {
                    // Tempo máximo atingido: grava o que já estiver no buffer
                }

                if (buffer.Count > 0)
                {
                    await FlushBatchAsync(buffer, stoppingToken);
                    buffer.Clear();
                }
            }
            catch (Exception ex) when (!stoppingToken.IsCancellationRequested)
            {
                logger.LogError(ex, "Failed to process audit batch");
                await Task.Delay(TimeSpan.FromSeconds(5), stoppingToken);
            }
        }
    }

    private async Task FlushBatchAsync(List<AuditLog> logs, CancellationToken cancellationToken)
    {
        // O worker é singleton, então o repositório vem de um escopo próprio
        using var scope = scopeFactory.CreateScope();
        var repository = scope.ServiceProvider.GetRequiredService<IAuditRepository>();
        await repository.BulkInsertAsync(logs, cancellationToken);
    }
}
O IServiceScopeFactory aparece porque o Background Service vive como singleton. Portanto, dependências com escopo, como um DbContext, precisam de um escopo criado manualmente.
Formas de leitura em channels em C#
A API de leitura dos channels em C# oferece caminhos diferentes, e cada um atende a um cenário. Escolher bem evita código complexo sem necessidade.
Leitura item a item com ReadAllAsync
Para uma leitura simples, item a item, use ReadAllAsync. Ele devolve um IAsyncEnumerable<T>, então cada evento recebido no channel é processado individualmente com await foreach.
protected override async Task ExecuteAsync(CancellationToken stoppingToken)
{
    // Processa cada evento assim que ele chega
    await foreach (var log in _reader.ReadAllAsync(stoppingToken))
        await _repository.InsertAsync(log, stoppingToken);
}
Leitura em lote com WaitToReadAsync
Para controlar manualmente a fila, use WaitToReadAsync, ideal para tratamento em lote. Com ele, o consumer aguarda até que exista pelo menos um item disponível antes de iniciar a leitura.
Depois disso, o TryRead retira tudo o que estiver disponível imediatamente, até o limite definido. Assim, cada ida ao banco carrega vários registros de uma só vez.
protected override async Task ExecuteAsync(CancellationToken stoppingToken)
{
    while (await _reader.WaitToReadAsync(stoppingToken))
    {
        var batch = new List<AuditLog>();

        // Pega o que estiver disponível imediatamente, até 50 itens
        while (batch.Count < 50 && _reader.TryRead(out var log))
            batch.Add(log);

        if (batch.Count > 0)
            await _repository.BulkInsertAsync(batch, stoppingToken);
    }
}
Esse laço termina sozinho quando o producer chama Complete no writer e a fila esvazia. Por isso, ele é a forma mais segura de consumir um channel que pode ser fechado.
Vários consumers lendo o mesmo channel
Quando um único consumer não dá conta do volume, os channels em C# também permitem vários leitores. Para isso, basta criar o channel com SingleReader = false e iniciar mais de uma tarefa de leitura.
// Três consumers dividem o trabalho do mesmo channel
var consumers = Enumerable.Range(0, 3)
    .Select(_ => ConsumeAsync(channel.Reader, stoppingToken))
    .ToArray();

await Task.WhenAll(consumers);
Cada item chega a apenas um dos consumers, então não há processamento duplicado. Entretanto, a ordem global deixa de ser garantida, já que cada leitor avança no seu próprio ritmo.
Encerrando channels em C# sem perder eventos
Uma API que usa channels em C# precisa pensar no desligamento. Quando a aplicação recebe o sinal de parada, ainda podem existir itens na fila esperando processamento.
O writer oferece os métodos Complete e TryComplete para sinalizar que nenhum dado novo será escrito. Depois disso, o consumer termina de ler o que restou e o laço de leitura encerra naturalmente.
Também é importante saber que qualquer escrita depois do fechamento gera uma ChannelClosedException. Por isso, o TryWrite é uma escolha mais tranquila no middleware, já que ele apenas retorna false nesse caso.
No worker de auditoria, vale gravar o conteúdo do buffer antes de sair do ExecuteAsync. Assim, os últimos eventos recebidos não desaparecem junto com o processo.
Quando usar channels em C# e quando evitar
Channels são muito úteis para pipelines internos de processamento dentro da aplicação. Eles brilham especialmente quando não há necessidade de persistir a fila nem de comunicação entre múltiplos serviços.
Em outras palavras, se não há necessidade de uma fila distribuída como Kafka ou RabbitMQ, os channels em C# resolvem o problema com muito menos infraestrutura. Exemplos comuns incluem auditoria, envio de e-mails, geração de miniaturas e agregação de métricas.
Entretanto, existe um ponto importante: channels em C# não persistem dados. Se o processo morrer, os itens que estavam na fila se perdem.
Portanto, para eventos que não podem desaparecer de jeito nenhum, um broker persistente continua sendo a escolha certa. Também vale lembrar que o channel vive em uma única instância, então cada réplica da API terá sua própria fila.
Se o seu problema é limitar quantas tarefas rodam ao mesmo tempo, e não enfileirar trabalho, outra ferramenta pode servir melhor. Nesse caso, veja o artigo sobre controle de concorrência com SemaphoreSlim.
Resumindo
Channels em C# são um recurso simples de usar, eficiente e ainda pouco explorado. Eles oferecem uma forma direta de desacoplar a produção e o consumo de eventos, sem perder o controle sobre a concorrência e o uso de recursos.
Com bounded channels, você define o tamanho máximo da fila e escolhe o comportamento quando ela enche. Além disso, o uso de ValueTask reduz alocações e alivia o garbage collector.
Combinados com Background Services, os channels em C# podem evitar filas distribuídas em pipelines internos, com ótima performance. Assim, a API responde rápido e o trabalho pesado acontece em segundo plano, no ritmo que o banco suporta.
FAQ
Preciso instalar algum pacote para usar channels em C#?
Não, a partir do .NET Core 3.0 a biblioteca System.Threading.Channels já faz parte do shared framework. Para .NET Framework ou .NET Standard, existe o pacote NuGet de mesmo nome.
Qual a diferença entre bounded e unbounded channel?
O bounded tem capacidade máxima e aplica backpressure quando enche, enquanto o unbounded aceita itens sem limite. O unbounded é mais simples, mas pode consumir memória sem controle se o consumer ficar lento.
Channels substituem RabbitMQ ou Kafka?
Não, eles servem para filas internas de um único processo e não persistem dados. Para comunicação entre serviços ou eventos que não podem se perder, um broker continua sendo necessário.
O que acontece com os itens se a aplicação reiniciar?
Eles se perdem, porque o channel vive apenas em memória. Se essa perda for inaceitável, grave os eventos em um armazenamento durável antes de processá-los.
Quando usar TryWrite em vez de WriteAsync?
Use TryWrite quando o producer não pode esperar, como em um middleware de API. O WriteAsync faz sentido quando aguardar espaço na fila é aceitável e você não quer perder itens.